本地优先并不意味着“只要进程能启动就算正常”。OncallAgent 同时依赖 SQLite、Milvus、模型服务、MCP Server 和浏览器前端,其中任何一项都可能单独失败。仓库因此把存活检查、依赖就绪检查、配置诊断、请求指标和结构化日志拆成不同入口,再用宿主机启动器与基础设施 Compose 明确运行边界。
这篇文章的重点不是记住四个 URL,而是理解每个信号能够证明什么。/health 只证明 FastAPI 还能响应;/ready 才会探测运行依赖;/config/check 同时检查配置能否解析和依赖是否可用;/metrics 只提供进程内请求聚合。把这些信号混用,很容易把“端口打开”误判成“诊断链路可用”。
📷 [图片 token=KTuQbdyWLorQeKx05dzcGCDUnNg(未能下载,见飞书原文)]
学习目标
区分 liveness、readiness、configuration diagnostics 和本地 metrics。
理解 request ID、结构化事件和敏感字段脱敏的实现方式。
掌握 Compose 基础设施与宿主机应用进程的本地运行拓扑。
能够根据真实检查结果定位 SQLite、Milvus、模型或 MCP 的具体故障层。
功能入口与完整调用链
apps/backend/src/super_ai/api/app.py 的 create_app 在应用创建时启用结构化日志,组装 SQLite repositories、Milvus、后台任务和请求指标,并保存可注入的模型 provider;默认模型 provider 会在首次请求或 readiness 路径中懒加载。lifespan 启动 durable job runtime,在应用关闭时停止 worker 并释放自建数据库 engine。外部网络连接没有在模块导入时发生,而是在请求、readiness 或显式运行路径中创建。
📷 [图片 token=Rnxtb0PaXoNQA7xQW4Ec20E2nHK(未能下载,见飞书原文)]
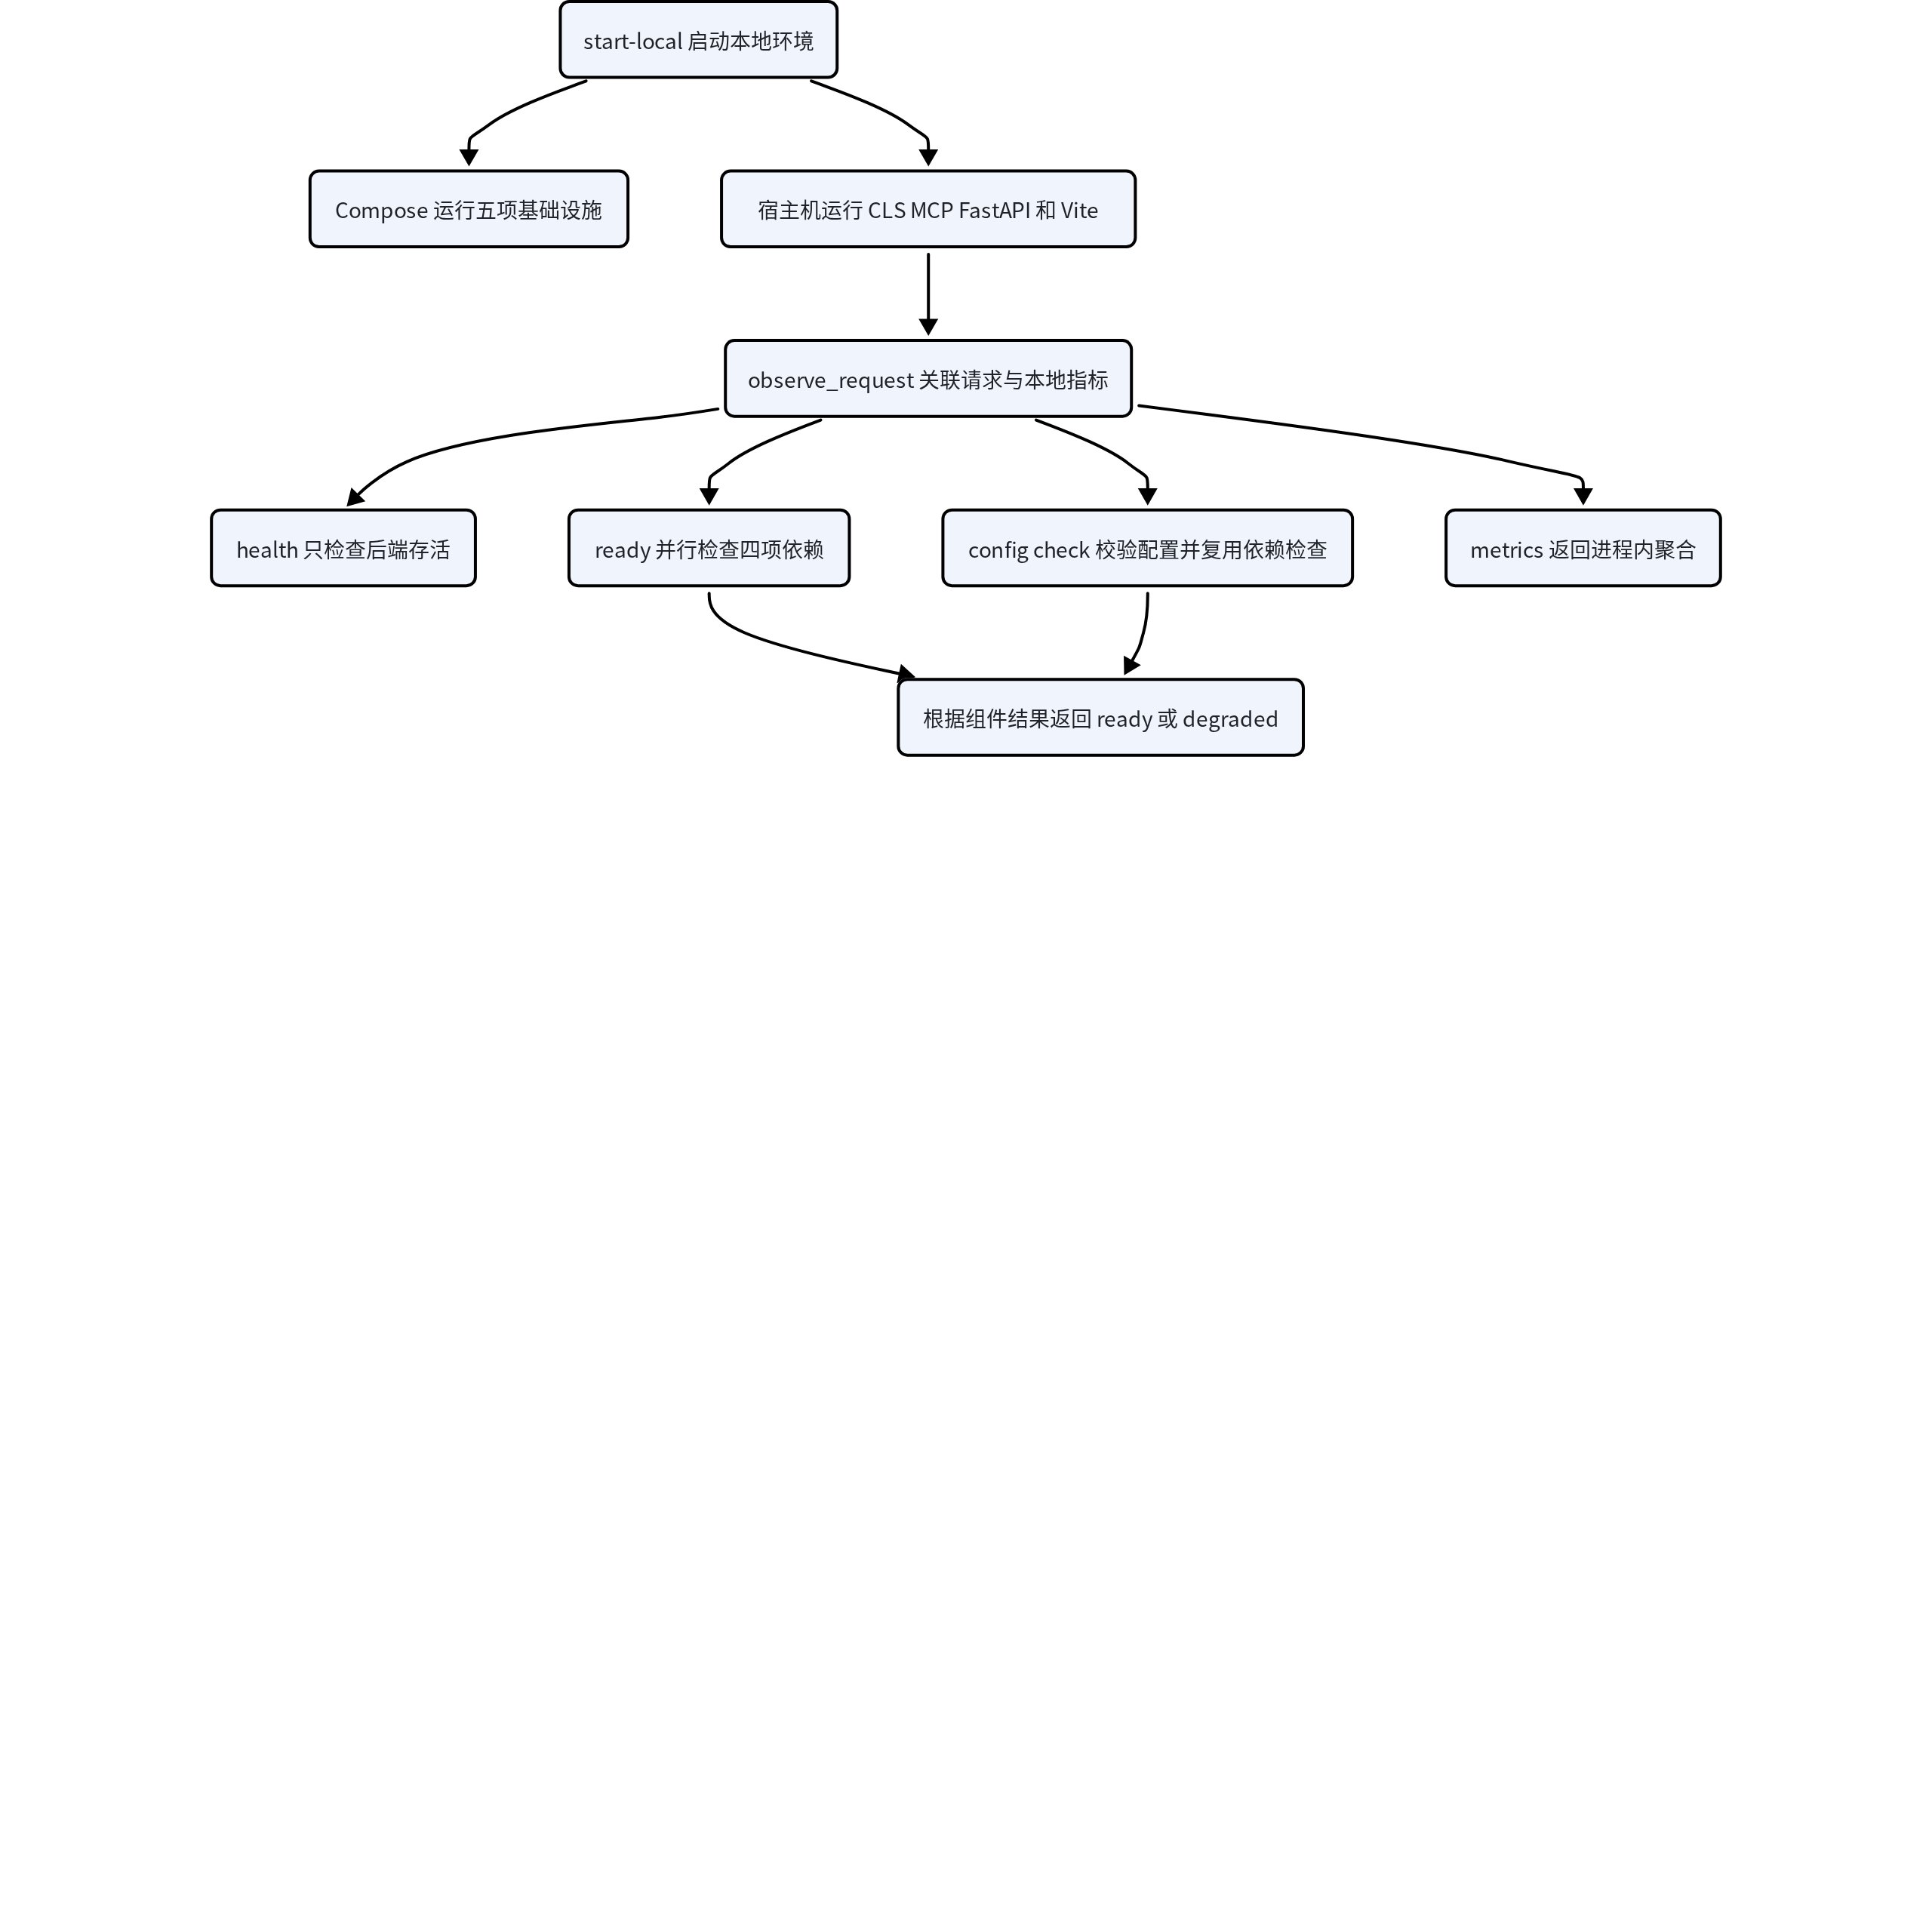
每个 HTTP 请求先经过 observe_request middleware。它尊重调用方传入的 X-Request-ID,没有时生成新 ID,将其放入 context variable,并在响应头中返回。请求完成后记录 method、path、status 和 latency,同时更新 RequestMetrics;异常处理器另行记录规范化错误码或异常类别。
📷 [图片 token=CIW2bkM2toKwWtxeAI7cPdkmnwd(未能下载,见飞书原文)]
本地启动时,infra/compose.yaml 只运行 etcd、MinIO、Milvus、Attu 和 Alertmanager。scripts/start-local.sh 或 scripts/start-local.bat 在宿主机准备依赖、执行 Alembic migration,并启动官方 CLS MCP Server、FastAPI 与 Vite 前端。应用配置仍来自本地 JSON;启动器只为外部 CLS MCP 进程把合并后的必要字段导出为该进程需要的环境变量。
📷 [图片 token=SJelbCjQYoGgmKxVvLqcivxFnEw(未能下载,见飞书原文)]
浏览器 / 运维检查
  → /health:仅 FastAPI 存活
  → /ready:并行检查 SQLite、Milvus、LLM、MCP
  → /config/check:解析配置 + 复用依赖检查
  → /metrics:进程内请求数、5xx 数、平均延迟

本地运行拓扑
  → Docker Compose:etcd + MinIO + Milvus + Attu + Alertmanager
  → 宿主机进程:CLS MCP Server + FastAPI + Vue/Vite
  → SQLite:宿主机本地业务持久化
  → config/project.json + config/user.project.json:递归合并,用户配置覆盖基础配置
核心源码地图
| 源码位置 | 关键符号 | 职责 |
|---|---|---|
apps/backend/src/super_ai/api/app.py | health、ready、config_check、metrics | 提供分层运行状态入口,并统一返回安全响应。 |
apps/backend/src/super_ai/api/app.py | observe_request、_runtime_dependency_payload | 关联请求、汇总指标,并并行检查 SQLite、Milvus、LLM 与 MCP。 |
apps/backend/src/super_ai/observability.py | emit_event、_redact | 输出紧凑 JSON 事件,并按字段名递归清理敏感值。 |
apps/backend/src/super_ai/api/observability.py | RequestMetrics | 线程安全地聚合请求数、5xx 数和总延迟。 |
apps/backend/src/super_ai/project_config.py | load_project_config、_deep_merge | 读取基础 JSON 和用户覆盖文件,按嵌套对象递归合并。 |
apps/frontend/src/runtimeHealth.ts | createRuntimeHealthClient | 调用轻量 /health,供工作台标题栏显示连接状态。 |
apps/frontend/src/layouts/WorkspaceLayout.vue | isConnected | 把轻量 health 成功或失败渲染为可感知状态,不阻塞受保护页面加载。 |
infra/compose.yaml | 五个基础设施 services | 定义本地容器基础设施、端口、依赖、healthcheck 和数据卷。 |
scripts/start-local.sh | require_command、port_is_open | 检查前置命令、合并配置、启动基础设施、迁移和宿主机进程。 |
openspec/specs/runtime-readiness-checks/spec.md | Readiness requirements | 规定安全依赖检查、轻量 health 和配置诊断边界。 |
代码调用流程图
本地运行不是一个单进程黑盒:Compose 管理基础设施,宿主机运行应用;同一 FastAPI middleware 再把请求关联、结构化事件和进程内指标串起来。
关键实现拆解
四个状态入口回答四个问题
GET /health 返回 service、status 和 version,不访问 SQLite、Milvus、模型或 MCP。它适合回答“后端进程是否还能处理 HTTP”,也适合前端标题栏的轻量连通性显示。apps/backend/tests/test_readiness_api.py 明确使用一个一旦调用就抛错的 vector store,验证 health 不会触发依赖探测。
看什么:/health 只读取进程内 foundation 信息;/metrics 只读取当前进程内累计快照并计算平均耗时,两者都不调用四项依赖探针。
    @app.get("/health")
    async def health(request: Request) -> object:
        # 1. liveness 不触碰 SQLite、Milvus、LLM 或 MCP。
        foundation = get_foundation_info()
        return success_response(
            request,
            {
                "service": foundation.service,
                "status": foundation.status,
                "version": foundation.version,
            },
        )

    @app.get("/metrics")
    async def metrics(request: Request) -> object:
        snapshot = request.app.state.request_metrics.snapshot()
        # 2. 平均值来自当前进程内累计总耗时。
        average = (
            snapshot.total_latency_ms / snapshot.request_count if snapshot.request_count else 0.0
        )
这段代码证明 health 成功只表示 HTTP 进程可响应,不能推出数据库或外部服务可用;metrics 也不是探针。进程重启会清空计数,且这些数据没有跨实例聚合或长期保留。
GET /ready 使用 asyncio.gather 并行检查四个组件。SQLite 执行 SELECT 1;Milvus 调用 vector store 的 health_check;LLM 调用 provider 的 check_readiness;MCP 调用 LocalMcpClient.readiness 并统计真实发现的工具。所有组件都成功时返回 200 和 ready,任一失败返回 503 和 degraded,同时保留其他组件的结果。
📷 [图片 token=AFLkbaUiMoDnUnxMdoUcfAWpnlg(未能下载,见飞书原文)]
看什么:四个探针用 asyncio.gather 并行执行,再以固定键返回;各探针内部把异常转换为安全的 ok=False 结果,所以单项失败不会抹掉其他项。
async def _runtime_dependency_payload(request: Request) -> dict[str, dict[str, object]]:
    # 1. 四项真实检查并行等待,避免串行叠加延迟。
    sqlite_result, milvus_result, llm_result, mcp_result = await asyncio.gather(
        _sqlite_readiness_payload(request),
        _milvus_readiness_payload(request),
        _llm_readiness_payload(request),
        _mcp_readiness_payload(request),
    )
    # 2. 某一项降级时仍保留另外三项结果。
    return {
        "sqlite": sqlite_result,
        "milvus": milvus_result,
        "llm": llm_result,
        "mcp": mcp_result,
    }
它证明 readiness 是聚合结果而不是“第一个失败就提前返回”。一致性边界是四个探针不是同一时刻的分布式快照:并行能缩小时间差,但组件状态仍可能在响应生成后立即变化。
看什么:路由层只做最终归约——所有组件 ok 才返回 200;否则仍使用统一成功 envelope 承载 degraded 数据,但 HTTP 状态为 503。
    @app.get("/ready")
    async def ready(request: Request) -> object:
        dependencies = await _runtime_dependency_payload(request)
        # 1. 任一组件 ok 为假,整体 readiness 即降级。
        is_ready = all(bool(component["ok"]) for component in dependencies.values())
        # 2. 响应保留全部组件安全结果,便于定位单点故障。
        return success_response(
            request,
            {"status": "ready" if is_ready else "degraded", "dependencies": dependencies},
            status_code=200 if is_ready else 503,
        )
这段代码证明客户端必须同时读取 HTTP 状态和响应数据:503 并不意味着响应体不可解析,而是明确的 readiness 失败。它也没有自动重启或修复依赖,只负责报告当前探测事实。
📷 [图片 token=O6ZFbnFBjooGEnxKteEcDaPAn5g(未能下载,见飞书原文)]
GET /config/check 先分别解析 SQLite、LLM、Milvus 和 MCP 配置,再复用运行依赖检查。配置解析和连接状态是两套结果:字段合法但服务没启动时,configuration 可以 valid,而 dependency 仍然不 ready;字段缺失时则在 configuration 标记 invalid。响应不返回显式 API key 或 CLS secret 字段,但会按配置原样返回 provider、model、base URL、Milvus URI、collection 和 MCP endpoint;因此连接 URL 与 endpoint 中不得嵌入 userinfo、token 或其他凭据。
📷 [图片 token=HqaLbZiheo6TP2xBV8pcQnOVnx9(未能下载,见飞书原文)]
GET /metrics 从进程内 RequestMetrics 返回 request count、failure count 和 average latency。failure 只统计 HTTP 状态大于等于 500 的请求;数据随进程重启清零,也不是 Prometheus 格式的完整监控系统。它适合本地快速观察,不能被描述为长期指标存储或分布式 tracing。
📷 [图片 token=SKuObt57YoABamx4zY1c20CinvC(未能下载,见飞书原文)]
看什么:入口关系图把 liveness、readiness、配置诊断与本地指标分开,避免把“状态页面”误写成一个含义。
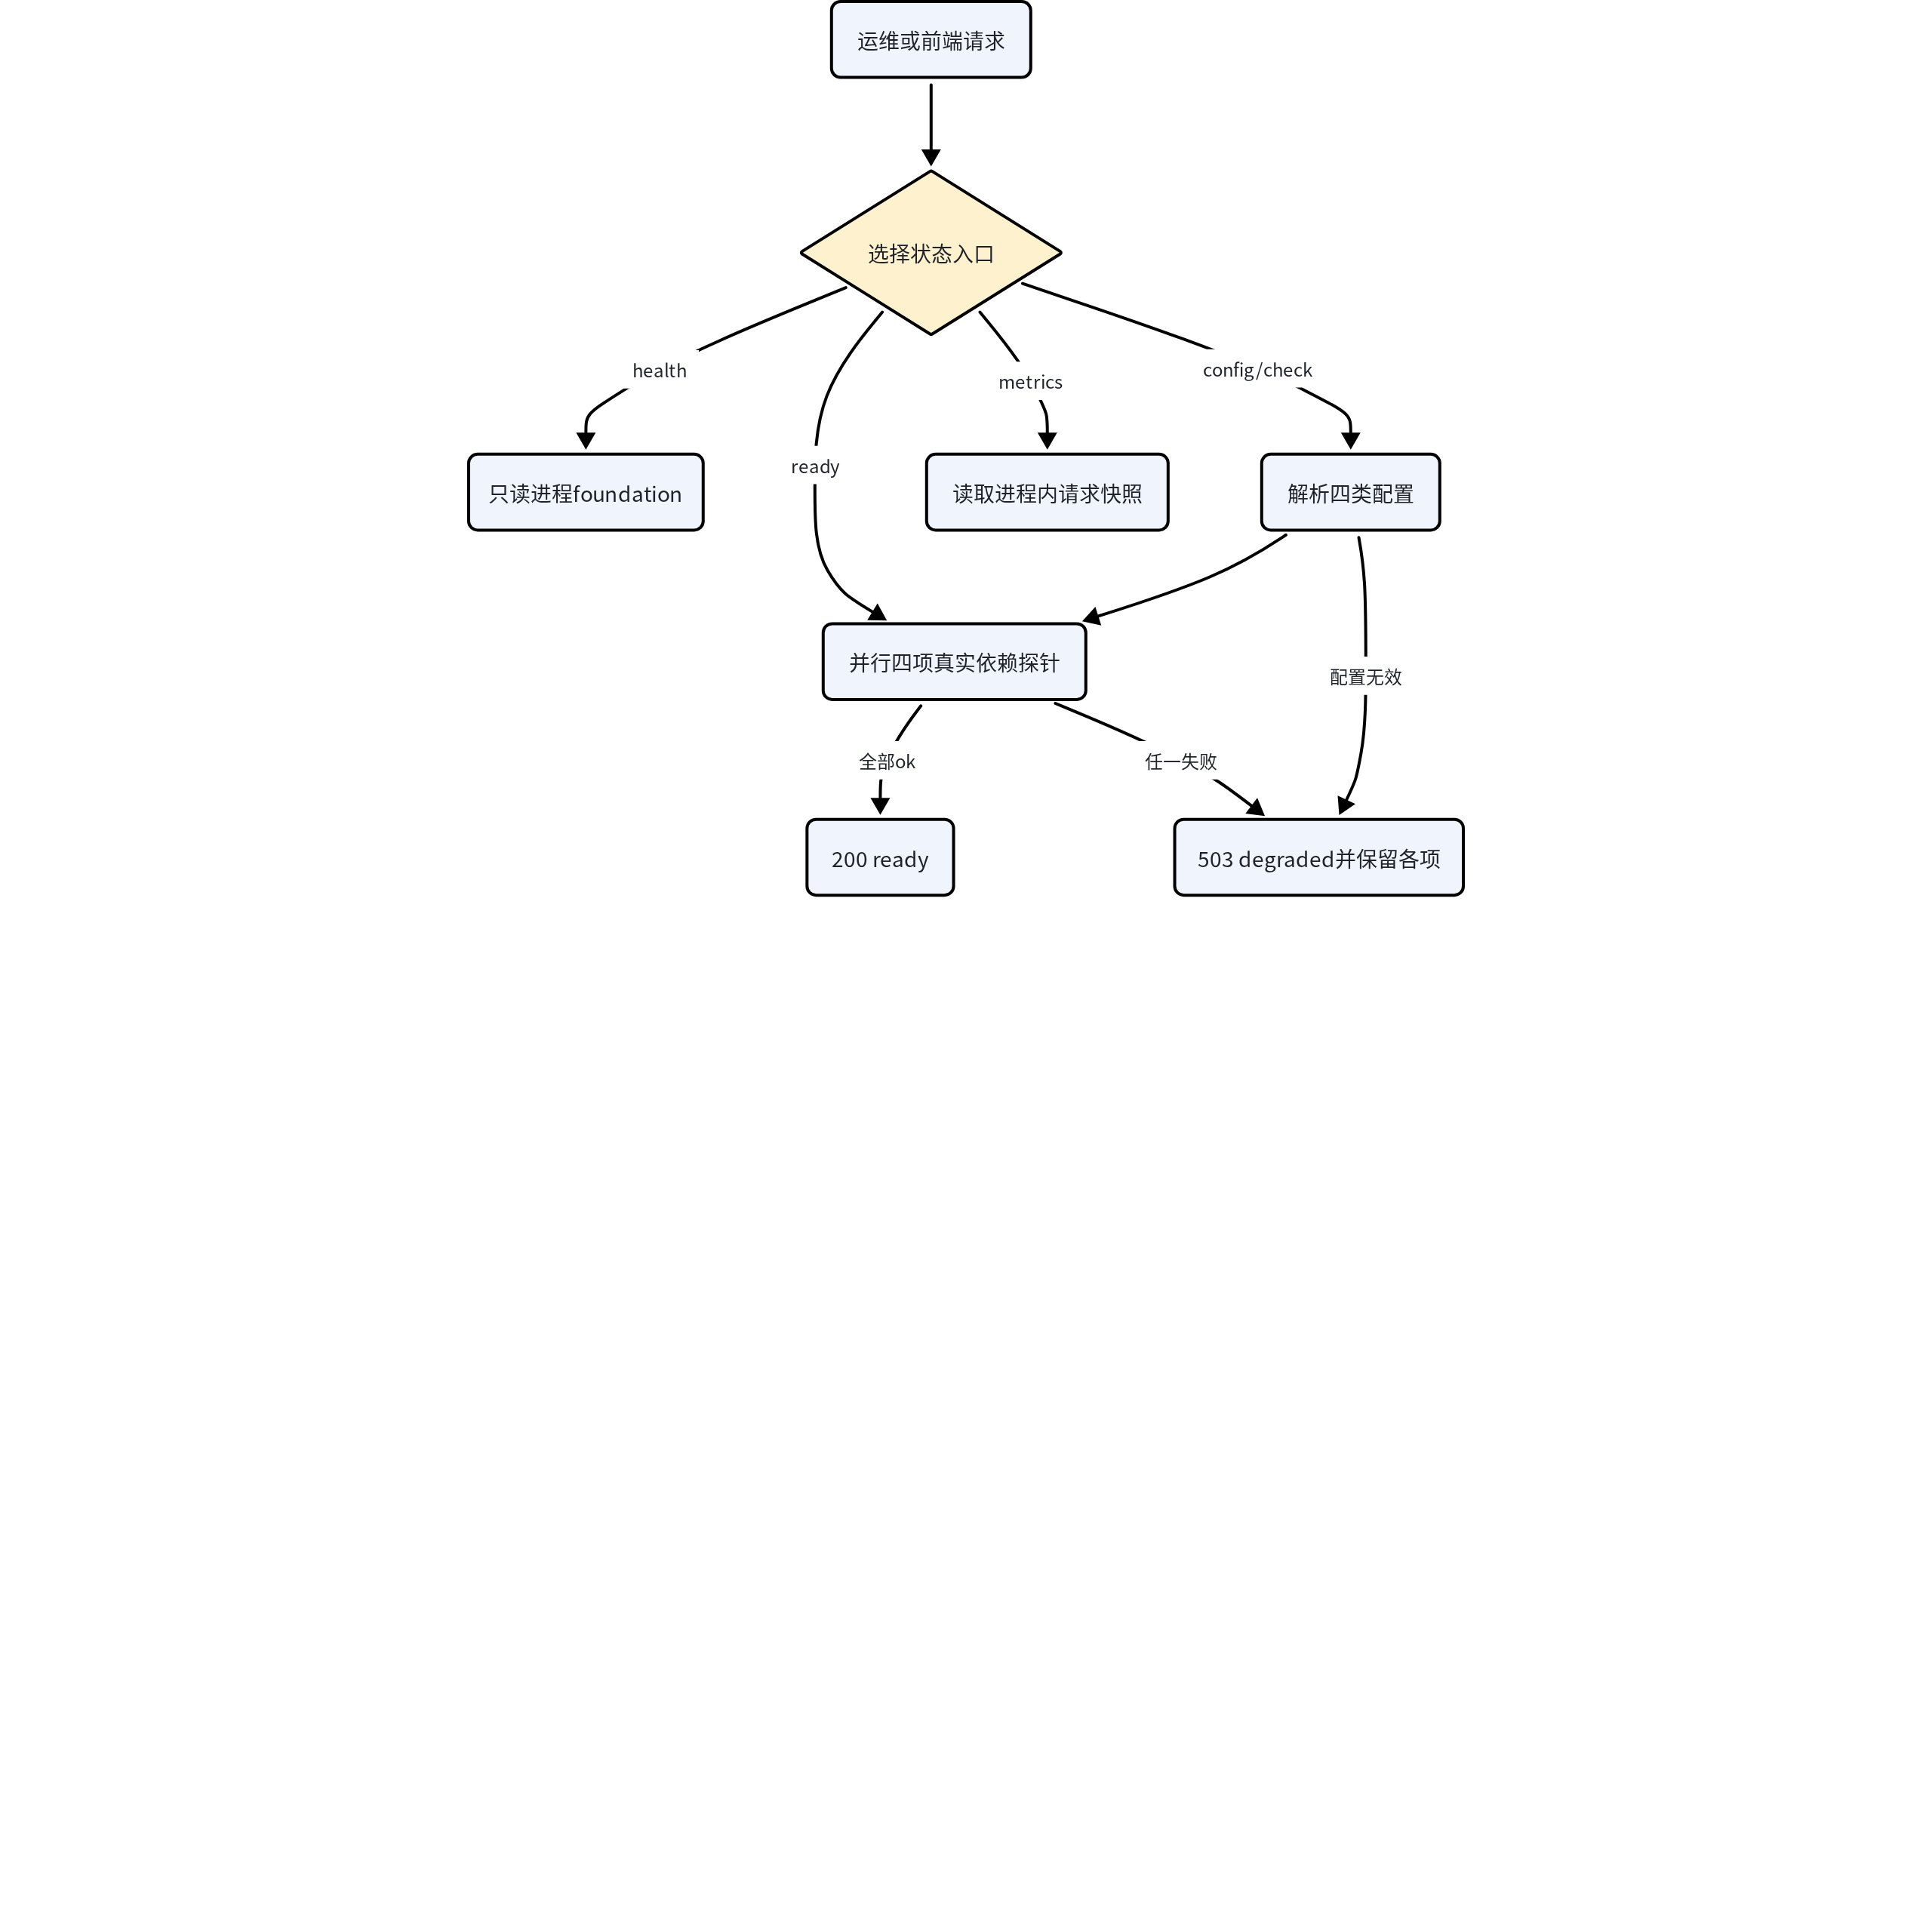
这张图证明 /config/check 比 /ready 多回答“配置能否解析”,但不会因此替代真实连接检查;/health 与 /metrics 则刻意保持轻量。选择错误入口会得到语义正确却不适合问题的答案。
请求关联与结构化事件
observe_request 把 request ID 放入 ContextVar,因此同一异步请求内调用 emit_event 时可以自动附带关联 ID。正常完成事件记录 method、path、status 和 latency;API 错误处理器只记录规范化 error code;未捕获异常只记录异常类型,不记录原始异常文本、header 或 body。
看什么:middleware 优先复用请求头中的 ID,否则生成新 ID;无论成功或异常,finally 都更新本地指标并发出 completion 事件,最后恢复 ContextVar。
        # 1. 同一请求复用或生成稳定关联 ID。
        request_id = request.headers.get("x-request-id") or f"req_{uuid4().hex}"
        request.state.request_id = request_id
        correlation_token = set_request_id(request_id)
        started_at = monotonic()
        response: Response | None = None
        try:
            response = await call_next(request)
            response.headers["X-Request-ID"] = request_id
            return response
        except Exception as exc:
            # 2. 未捕获异常只记录类型,不复制原异常文本。
            emit_event(logger, "request.error", errorCategory=exc.__class__.__name__)
            raise
        finally:
            status_code = response.status_code if response is not None else 500
            latency_ms = elapsed_ms(started_at)
            app.state.request_metrics.record(latency_ms=latency_ms, status_code=status_code)
            emit_event(
                logger,
                "request.complete",
                method=request.method,
                path=request.url.path,
                status=status_code,
                latencyMs=latency_ms,
            )
            reset_request_id(correlation_token)
这段代码证明关联 ID 同时进入响应头与请求范围日志。未捕获异常没有可用 Response,因此不能从这段代码推断异常响应一定带 X-Request-ID;但错误与 completion 事件在 ContextVar 重置前仍能共享该 ID。
📷 [图片 token=HU1gb2XHXokeGex2cIOcdJgXn2b(未能下载,见飞书原文)]
emit_event 在 JSON 编码前递归调用 _redact。字段名被规范化后,只要命中 authorization、password、secret、token、API key 等精确集合,或以 _key、_password、_secret、_token 结尾,值就替换为 [redacted]。像 privatekey 或 mySecret 这类不满足当前规则的名字不会自动命中。这是一道防守线,但调用方仍应遵守“不要把用户消息、文档正文、工具参数值和模型输出写进日志”的约束;脱敏不能替代正确的日志字段设计。
📷 [图片 token=TABrbTw9mol3r2xzqBvcRDQAnxg(未能下载,见飞书原文)]
看什么:脱敏根据父字段名递归决定是否替换值;字典、列表和元组都会继续遍历,其他对象最终转为字符串。
def _redact(value: object, *, parent_key: str | None = None) -> object:
    # 1. 命中敏感字段名时整值替换,不检查值的内容。
    if parent_key is not None and _is_sensitive_key(parent_key):
        return "[redacted]"
    if isinstance(value, Mapping):
        mapping = cast(Mapping[object, object], value)
        return {str(key): _redact(item, parent_key=str(key)) for key, item in mapping.items()}
    if isinstance(value, list):
        return [_redact(item, parent_key=parent_key) for item in cast(list[object], value)]
    if isinstance(value, tuple):
        return [_redact(item, parent_key=parent_key) for item in cast(tuple[object, ...], value)]
    if isinstance(value, (str, int, float, bool)) or value is None:
        return value
    return str(value)

def _is_sensitive_key(key: str) -> bool:
    normalized = key.replace("-", "_").lower()
    # 2. 只覆盖精确集合和四类下划线后缀。
    return normalized in _SENSITIVE_KEYS or normalized.endswith(
        ("_key", "_password", "_secret", "_token")
    )
它证明脱敏是字段名驱动而不是通用内容扫描;未命名为规则可识别字段的秘密不会自动清除。因此调用方必须只传最小化运维字段,不能把整个请求、模型输出或工具 payload 交给 emit_event 后期待它自动安全。
📷 [图片 token=YUfQbPYj7o32apxOH9OcPVZBnKb(未能下载,见飞书原文)]
关键工作还有独立生命周期事件:文档索引记录任务和文档 ID,聊天/AIOps 记录会话或诊断 ID,MCP 记录工具名和参数键。它们使用 elapsed_ms 计算耗时,不把 embedding、完整工具输出或用户输入塞进日志。工具业务审计保存在 SQLite,和运行日志是两种不同的数据面。
看什么:时序图展示 request ID 在一次异步请求内如何自动关联 API 错误、关键工作事件与最终 completion,并在结束后恢复上下文。
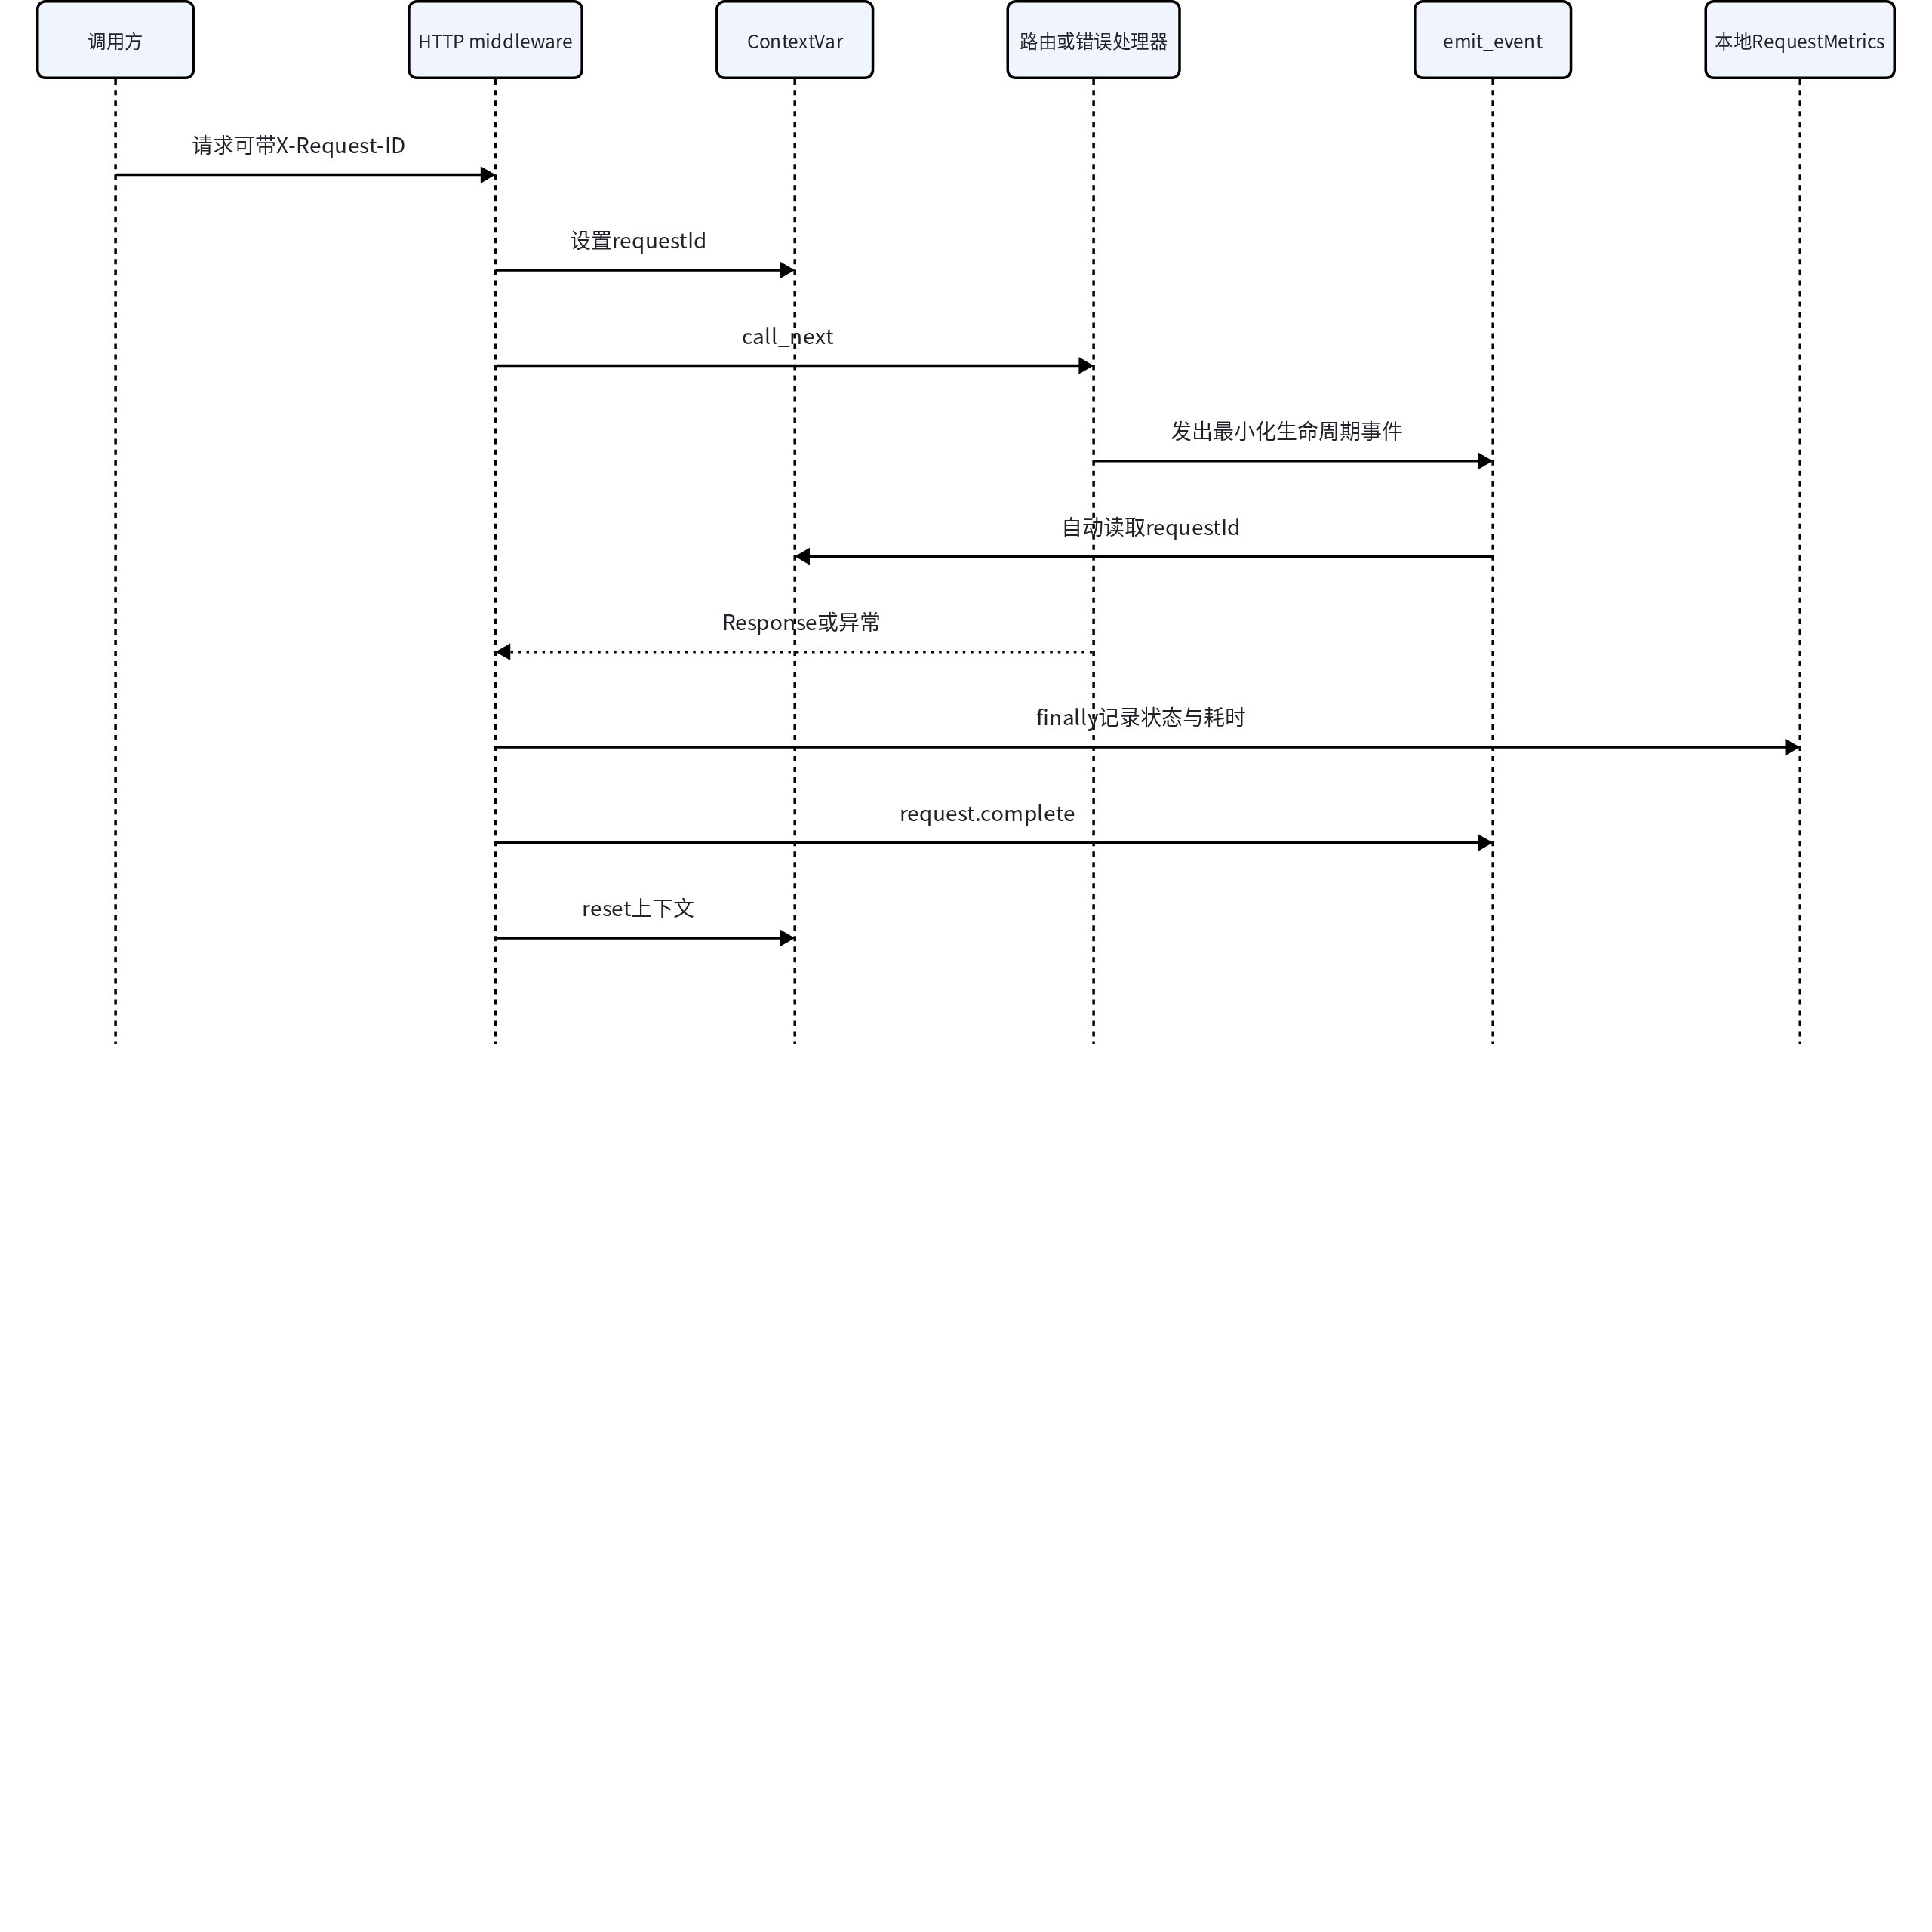
这张图证明请求关联是进程内异步上下文传播,不是完整分布式 tracing。跨进程、队列或外部 MCP 的关联需要显式传递;当前图不能被扩展解释为已经存在全链路 trace backend。
项目配置只从本地 JSON 合并
load_project_config 默认读取 config/project.json,如果 config/user.project.json 存在,则用 _deep_merge 递归覆盖相同路径。对象会继续合并,非对象值由用户配置替换。project_config_section 和 required_str、required_int 等函数在真正使用时校验字段类型。
看什么:加载器先读基础 JSON,再解析用户配置路径;只有用户文件存在时才递归合并,代码中没有读取环境变量的补值分支。
    path = Path(config_path) if config_path is not None else DEFAULT_PROJECT_CONFIG_PATH
    config = _read_json_object(path)
    override_path = _default_user_config_path(path, user_config_path)
    if override_path.exists():
        override = _read_json_object(override_path)
        # 1. 用户 JSON 仅在文件存在时覆盖基础 JSON。
        return _deep_merge(config, override)
    return config

# … 省略 JSON 读取与路径解析
def _deep_merge(base: Mapping[str, Any], override: Mapping[str, Any]) -> Mapping[str, Any]:
    merged: dict[str, Any] = dict(base)
    for key, value in override.items():
        current = merged.get(key)
        # 2. 两侧都是对象才递归,否则用户值整体替换。
        if isinstance(current, dict) and isinstance(value, dict):
            merged[key] = _deep_merge(
                cast(Mapping[str, Any], current),
                cast(Mapping[str, Any], value),
            )
        else:
            merged[key] = value
    return merged
这段代码证明数组、标量和布尔值不会逐项合并,而是由用户值整体替换;缺失用户文件则完整保留基础配置。JSON 缺失、格式错误或顶层非对象会抛配置错误,不会悄悄从 .env 或进程环境恢复。
后端业务配置不会从 .env 或宿主机环境变量补值。启动脚本中的环境变量导出只服务于单独运行的官方 CLS MCP Server:脚本先读取并合并两份 JSON,再设置该外部进程要求的 transport、port、腾讯云凭据和时区。不能由此推断 FastAPI 自身改成了环境变量配置。
📷 [图片 token=WLsSbm1qwoed3MxhZBIcu72Un7d(未能下载,见飞书原文)]
看什么:配置数据流图区分 FastAPI 的 JSON 读取和启动脚本为外部 CLS MCP 进程导出环境变量,两条消费者不能互相替代。
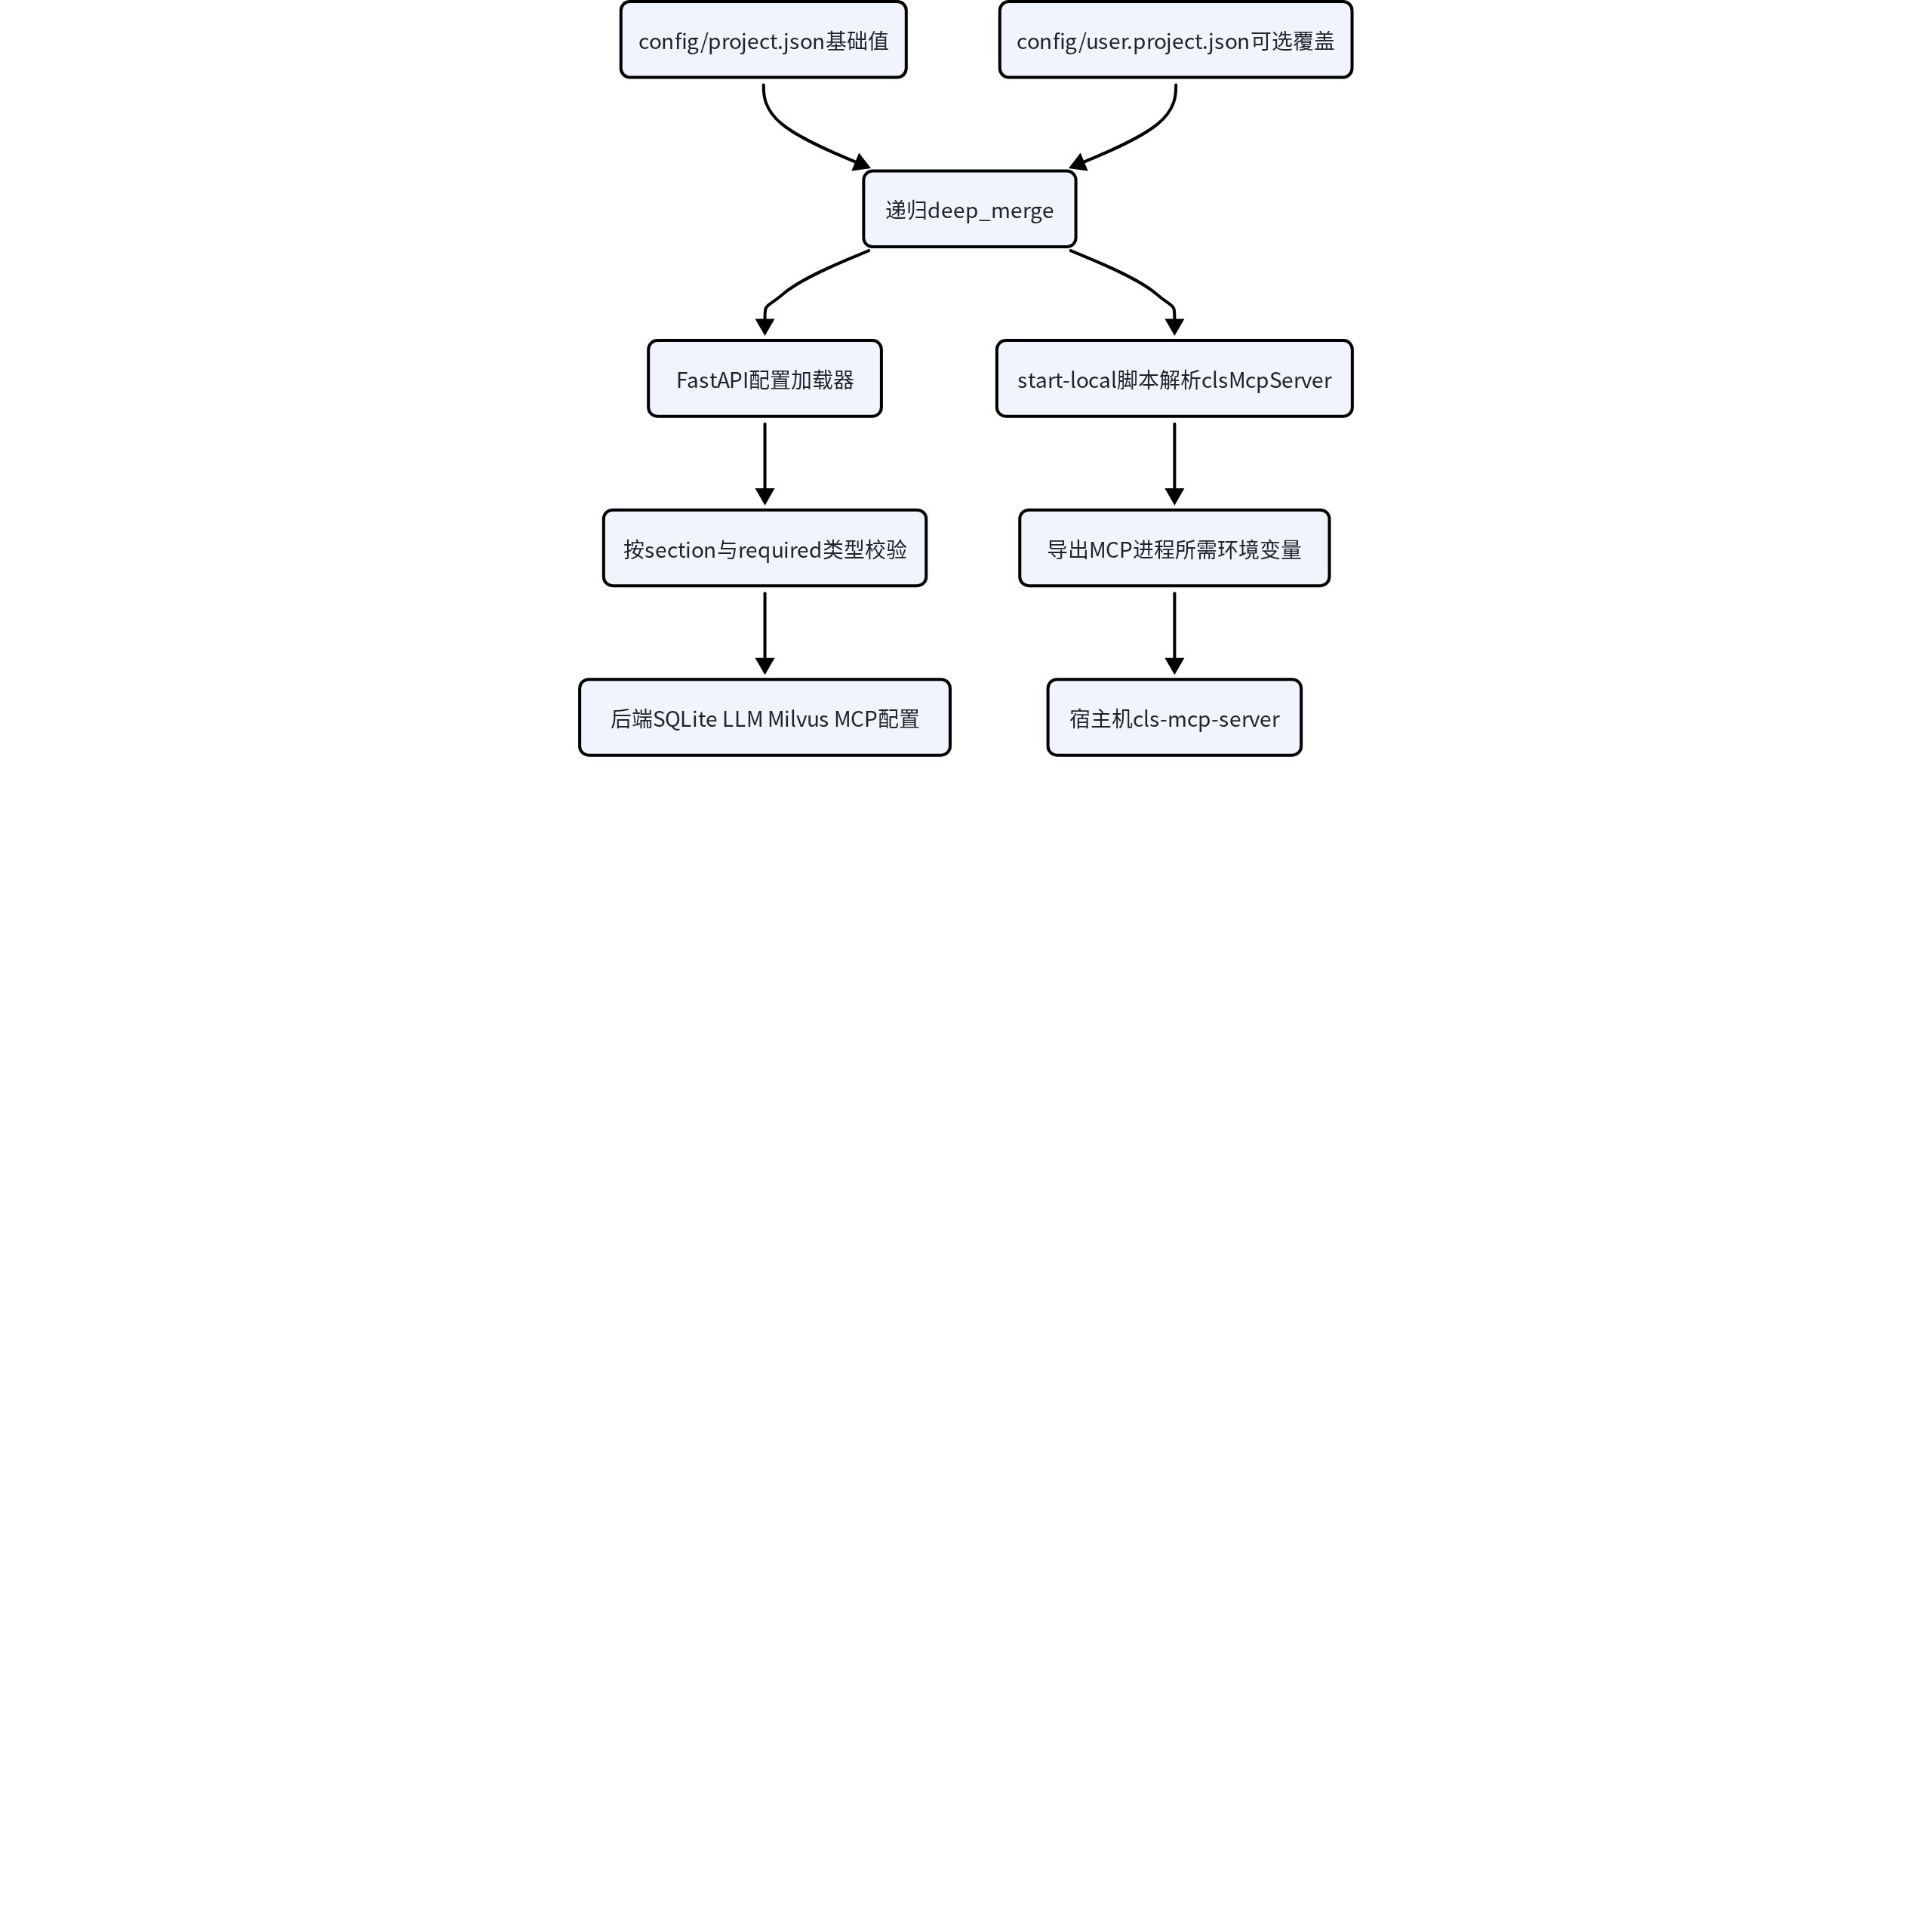
这张图证明环境变量出现在启动拓扑中不等于后端配置来源发生变化。安全边界是两份运行时 JSON 都被 Git 忽略且可能含真实凭据;模板、日志和诊断响应不得复制这些值。
Compose 与宿主机进程刻意分离
infra/compose.yaml 中的 etcd 和 MinIO 是 Milvus standalone 的依赖,Milvus 暴露 19530 与 9091,Attu 暴露本地管理界面,Alertmanager 暴露 9093。Compose 不包含 backend、frontend 或 CLS MCP Server,也不读取项目 .env。这使容器层只承担有状态基础设施,应用代码仍保留本机调试和文件访问体验。
📷 [图片 token=A57LbOLhSostUcx6j2gc1M6Ynud(未能下载,见飞书原文)]
看什么:Compose 中 Milvus 只依赖 etcd 与 MinIO 的健康状态,并暴露服务端口;这一段没有 backend、frontend 或 MCP 应用容器。
  milvus:
    image: milvusdb/milvus:v3.0-beta
    command: ["milvus", "run", "standalone"]
    environment:
      ETCD_ENDPOINTS: etcd:2379
      MINIO_ADDRESS: minio:9000
      MINIO_ACCESS_KEY: minioadmin
      MINIO_SECRET_KEY: minioadmin
    # 1. Milvus 的服务端与健康端口由基础设施栈暴露。
    ports:
      - "19530:19530"
      - "9091:9091"
    volumes:
      - milvus-data:/var/lib/milvus
    depends_on:
      etcd:
        condition: service_healthy
      minio:
        condition: service_healthy
    # 2. 这里只定义基础设施健康检查,不启动应用进程。
    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:9091/healthz"]
这段代码证明容器编排边界由文件本身落实,而不是文档约定。Compose 的健康只代表基础设施容器状态;FastAPI、Vue 和 CLS MCP 仍可能未启动,因此不能把 docker compose up 成功等同于完整工作台 ready。
macOS/Linux 启动器会检查 docker、npm、python3、uv 和 cls-mcp-server,启动 Compose,执行 uv sync 与 Alembic migration,并在对应端口未占用时启动 MCP、后端和前端,日志写到 apps/backend/var/。Windows 启动器完成相同角色的依赖检查、Compose、迁移和宿主机进程启动。启动器会安装依赖、写运行日志并启动服务,因此它不是无副作用的验证命令。
📷 [图片 token=SBClbC4JtoT35WxYmEZcSvdynTd(未能下载,见飞书原文)]
看什么:正式本机启动器先启动五项基础设施,再在后端目录安装依赖和升级迁移,最后按端口判断是否启动三个宿主机进程。
docker compose -f infra/compose.yaml up -d etcd minio milvus attu alertmanager

(
  cd "$BACKEND_DIR"
  # 1. 启动器会安装依赖并执行数据库迁移。
  uv sync
  uv run alembic upgrade head
)

if ! port_is_open "$PORT"; then
  (
    cd "$BACKEND_DIR"
    nohup cls-mcp-server </dev/null > "$RUNTIME_DIR/cls-mcp-server-local.log" 2>&1 &
  )
fi

if ! port_is_open 8000; then
  (
    cd "$BACKEND_DIR"
    # 2. 后端直接运行在宿主机,而不是 Compose 服务。
    nohup uv run uvicorn super_ai.api.app:create_app --factory --host 127.0.0.1 --port 8000 \
      </dev/null > "$RUNTIME_DIR/backend-local.log" 2>&1 &
  )
fi
它证明启动器是有副作用的运行入口:会拉起容器、同步依赖、迁移数据库、创建日志并启动后台进程。端口已占用时脚本跳过对应进程,但不会验证占用者就是本项目服务;因此启动后的最终事实仍应由 /health、/ready 与实际日志确认。
📷 [图片 token=CcbSblEbio8GQfxworocw8Q9nnf(未能下载,见飞书原文)]
看什么:拓扑图用进程归属而非调用顺序组织组件,清楚标出 Compose 与宿主机之间的连接边界。
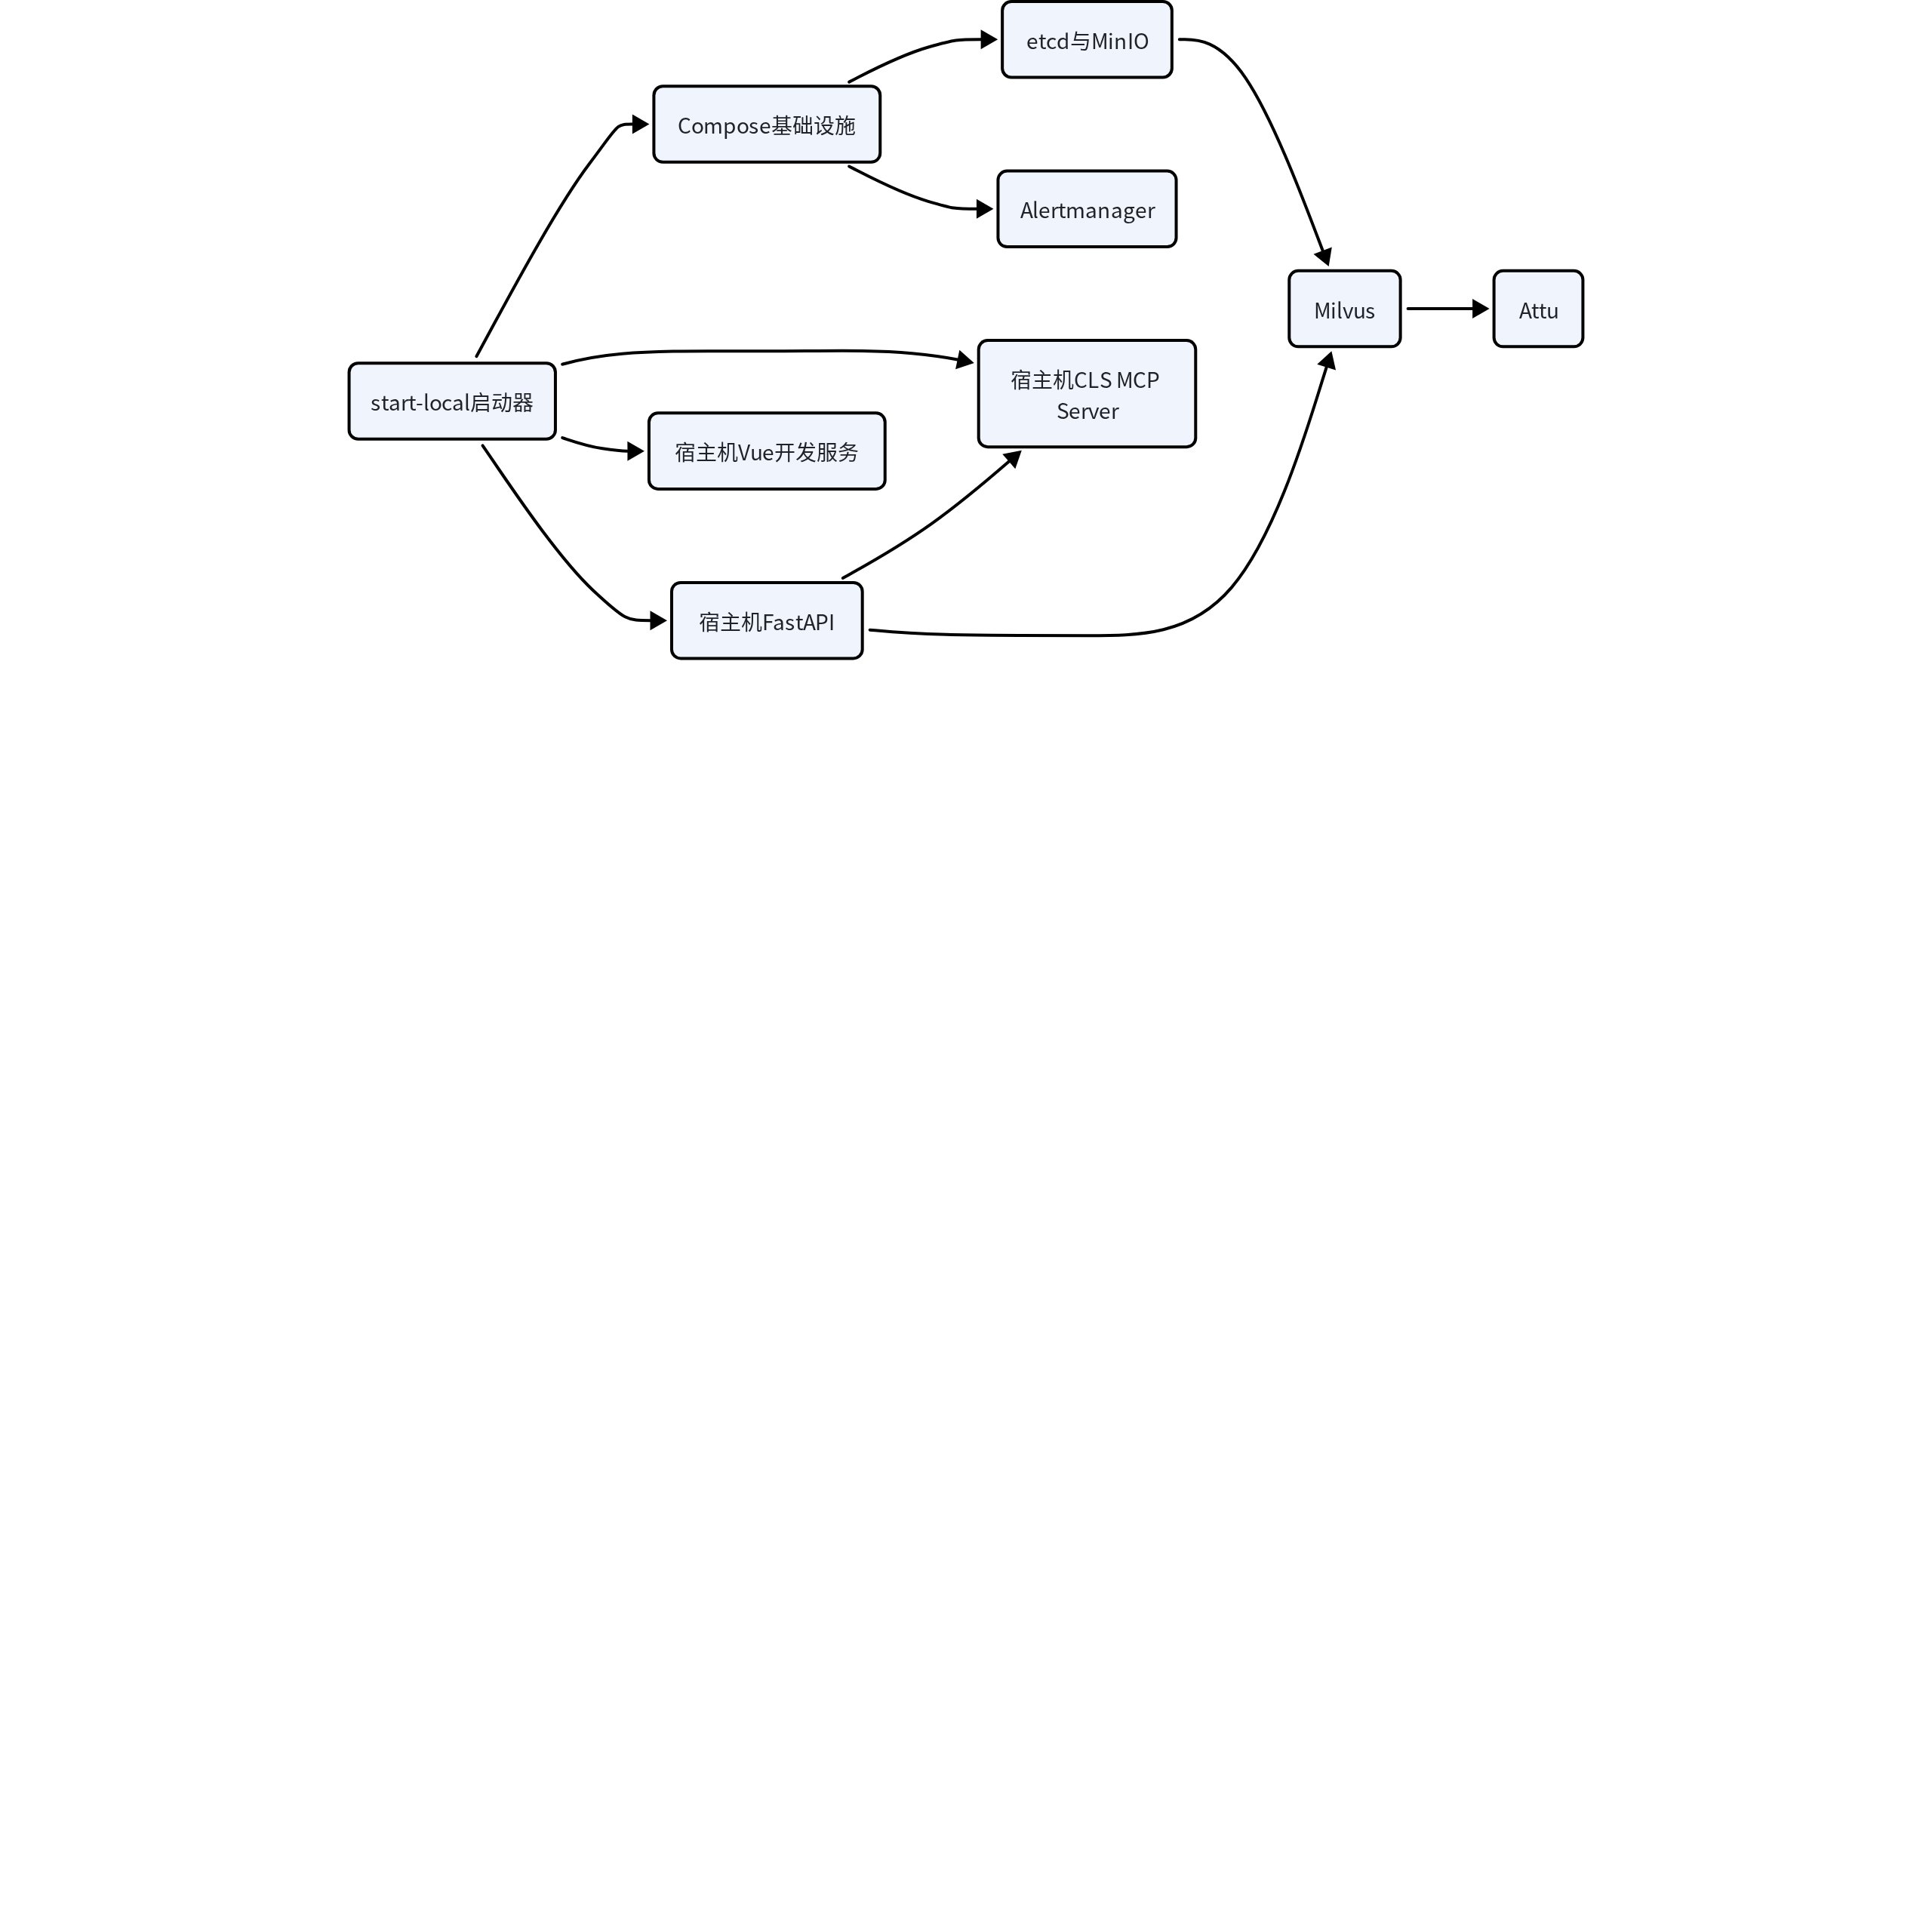
这张图证明 Compose 只负责有状态基础设施,应用与官方 MCP Server 保留在宿主机。失败边界也分层:容器 healthy 不能证明宿主机进程正常,反之 health 成功也不能证明 Milvus、LLM 或 MCP ready。
数据、契约与状态
readiness 返回每个 dependency 的 ok、连接元数据、latency 或 tool count 以及规范化 error。configuration check 返回每个配置块的 valid 和部分配置上下文。共享 OpenAPI 定义位于 packages/api-contracts/src/openapi.ts,前端 health 客户端通过通用 createApiClient 解开统一响应 envelope。由于 endpoint 与 URI 可能原样出现在响应中,安全性依赖配置本身不把凭据写入 URL。
WorkspaceLayout.vue 只用 /health 设置 isConnected。请求失败时标题栏显示降级,但不会把整个工作台路由替换成阻塞页。这是合理的 liveness 用法:用户仍可以查看已经加载到前端内存状态中的内容或继续排查,而更严格的依赖信息应到 /ready 和 /config/check 查看。
请求 metrics 位于当前 FastAPI 进程内,使用锁保护并发更新。它没有 tenant 维度、路径标签或历史落盘。结构化日志则输出到本地进程 handler,启动脚本把 stdout/stderr 写入运行目录。二者共同提供本地排障基线,但不等同于集中式监控平台。
📷 [图片 token=XRhDbphpTozSmFxCOoyclS3dnK0(未能下载,见飞书原文)]
权限、安全与失败边界
/health、/ready、/config/check 和 /metrics 当前都不要求用户认证,因此响应必须坚持最小安全信息原则。代码不会返回显式 API key、Authorization 字段、CLS secret 字段或原始基础设施异常,外部服务异常会规范化为 “SQLite/Milvus/LLM/MCP unavailable” 等信息;但 base URL、Milvus URI 和 MCP endpoint 会按配置值返回,配置文件不得把凭据嵌进这些字符串。
readiness 的成功只证明探针执行时组件响应,并不证明完整业务链路。MCP readiness 能发现工具,不代表特定参数调用一定成功;LLM readiness 不证明长对话或 rerank 都成功;Milvus health 不证明每个 tenant 都有可检索 chunk。真实验收需要继续执行相应的垂直业务路径。
📷 [图片 token=ZLSlbq1HzolHbfx7NF8coIqDnff(未能下载,见飞书原文)]
本地启动也不会自动上传 CLS 日志、发布告警、创建用户、写入 SOP 或执行诊断。这些属于显式演示/运维动作。将它们放进普通启动会污染数据并制造“已经完成真实取证”的假象,因此当前脚本只负责基础设施、依赖、迁移和进程。
阅读顺序与小结
先读
apps/backend/src/super_ai/api/app.py的四个端点和请求 middleware,建立信号层级。再读两份 observability 模块,理解 metrics、request ID 和脱敏。
进入
project_config.py,确认 JSON 合并和字段校验方式。对照
infra/compose.yaml与两个启动脚本,画出本地进程拓扑。最后把 readiness、observability、配置加载和 infra 拓扑连起来,核对每项检查实际证明了什么。
本地优先系统的可靠性来自清晰边界:存活不是就绪,配置合法不是依赖可用,依赖可用也不是业务闭环成功;容器负责基础设施,宿主机负责应用进程;日志记录安全信号,SQLite 保存业务审计。把这些层次分清,OncallAgent 的启动、排障和验收才不会依赖猜测。