AI Native 应用要想持续改进,至少需要回答两类不同问题:系统实际调用了什么工具、调用是否成功;用户认为哪一段结果有帮助、哪里不正确。OncallAgent 分别用工具调用审计和结构化用户反馈处理这两类问题。前者记录可观测的执行事实,后者记录用户对回答、引用、诊断步骤或报告的评价。
这两套数据不能混为一谈。工具审计不会自动判断回答是否正确,用户点踩也不能证明某次 MCP 调用失败。只有把审计中的执行链、引用中的来源、反馈中的具体目标和纠正意见放在一起,才可能定位“工具没调用”“工具返回无结果”“结果被错误解释”或“引用与结论不匹配”等不同问题。
📷 [图片 token=HyFJbBVHzoMOXMxIKjDcSkKpntF(未能下载,见飞书原文)]
学习目标
理解聊天与 AIOps 如何共用一套 owner-scoped 工具审计模型。
掌握 started、completed、failed 三种持久状态与实时 SSE 状态的关系。
理解四类反馈目标、重复提交更新规则和目标归属校验。
识别运行日志脱敏、业务审计内容和前端展示之间的安全边界。
功能入口与完整调用链
聊天工具调用从 LangChain 事件进入 apps/backend/src/super_ai/chat/streaming.py。on_tool_start、on_tool_end 和 on_tool_error 被转换成具有稳定 run ID 的 ChatAgentToolCall,ChatStreamingService 在发送 tool.call SSE 之前调用 _persist_tool_call_audit。started 事件创建记录,completed 或 failed 事件完成同一记录并计算耗时。
📷 [图片 token=DPS4b0m25onHbBxfBxTceDghnac(未能下载,见飞书原文)]
AIOps 侧由 AiopsDiagnosticService 显式控制生命周期。Planner 的知识检索和 Executor 的每个工具调用都先调用 _create_audit,随后根据真实结果调用 _finalize_audit。所有诊断审计绑定 diagnostic_task_id;聊天审计绑定 chat_session_id。数据库约束要求二者只能有一个父资源。
📷 [图片 token=NHUxbowrfoRXqixaHiqcTYM2nRg(未能下载,见飞书原文)]
反馈入口分布在聊天回答、单条 citation、诊断 step 和最终 report 旁边。UserFeedbackControl.vue 提供点赞、点踩、问题类型、说明和建议纠正;useUserFeedbackStore 通过 GET、POST 和 DELETE 方法访问 /feedback。后端 UserFeedbackService 先验证目标真实存在且属于当前用户,再执行 owner-scoped upsert 或 delete。
📷 [图片 token=DeY8byimso3DVexOvzMc1NuAnph(未能下载,见飞书原文)]
工具执行事实
  → LangChain tool event 或 AIOps Executor
  → tool.call SSE 供当前页面实时展示
  → SQLiteToolCallAuditRepository
  → started / completed / failed + duration
  → 会话审计接口或 AIOps evidence-chain 回读

用户质量判断
  → 回答 / citation / diagnostic step / report 旁的反馈控件
  → UpsertFeedbackRequest
  → UserFeedbackService._require_owned_target
  → SQLiteUserFeedbackRepository.upsert
  → 重新打开目标时恢复评价
核心源码地图
| 源码位置 | 关键符号 | 职责 |
|---|---|---|
apps/backend/src/super_ai/chat/streaming.py | _persist_tool_call_audit | 将聊天工具 started/completed/failed 事件映射为持久审计生命周期。 |
apps/backend/src/super_ai/aiops/diagnostics.py | _create_audit、_finalize_audit | 为知识检索与诊断工具调用创建并完成同一审计。 |
apps/backend/src/super_ai/memory/sqlite.py | SQLiteToolCallAuditRepository | 验证父资源归属,保存状态、参数、摘要、错误和派生耗时。 |
apps/backend/src/super_ai/memory/models.py | AgentToolCallAuditModel | 定义审计表和“聊天会话或诊断任务二选一”的父资源约束。 |
packages/api-contracts/src/chat.ts | ToolCallAudit | 定义审计在前后端之间的共享字段和状态枚举。 |
apps/frontend/src/stores/chat.ts | updateLiveToolCall、loadSession | 流式期间合并实时工具状态,流结束后回读会话与服务器持久审计。 |
apps/backend/src/super_ai/feedback.py | UserFeedbackService | 校验反馈类型、评分、长度和目标归属,组织 upsert/list/delete。 |
apps/backend/src/super_ai/memory/extended_sqlite.py | SQLiteUserFeedbackRepository | 按 owner、target、subject 唯一键更新或创建反馈。 |
packages/api-contracts/src/feedback.ts | FeedbackTargetType、UpsertFeedbackRequest | 定义四类目标、正负评价和可选纠正字段。 |
apps/frontend/src/components/UserFeedbackControl.vue | rate、remove、current、pending | 提供紧凑评价、渐进表单、提交状态和删除操作。 |
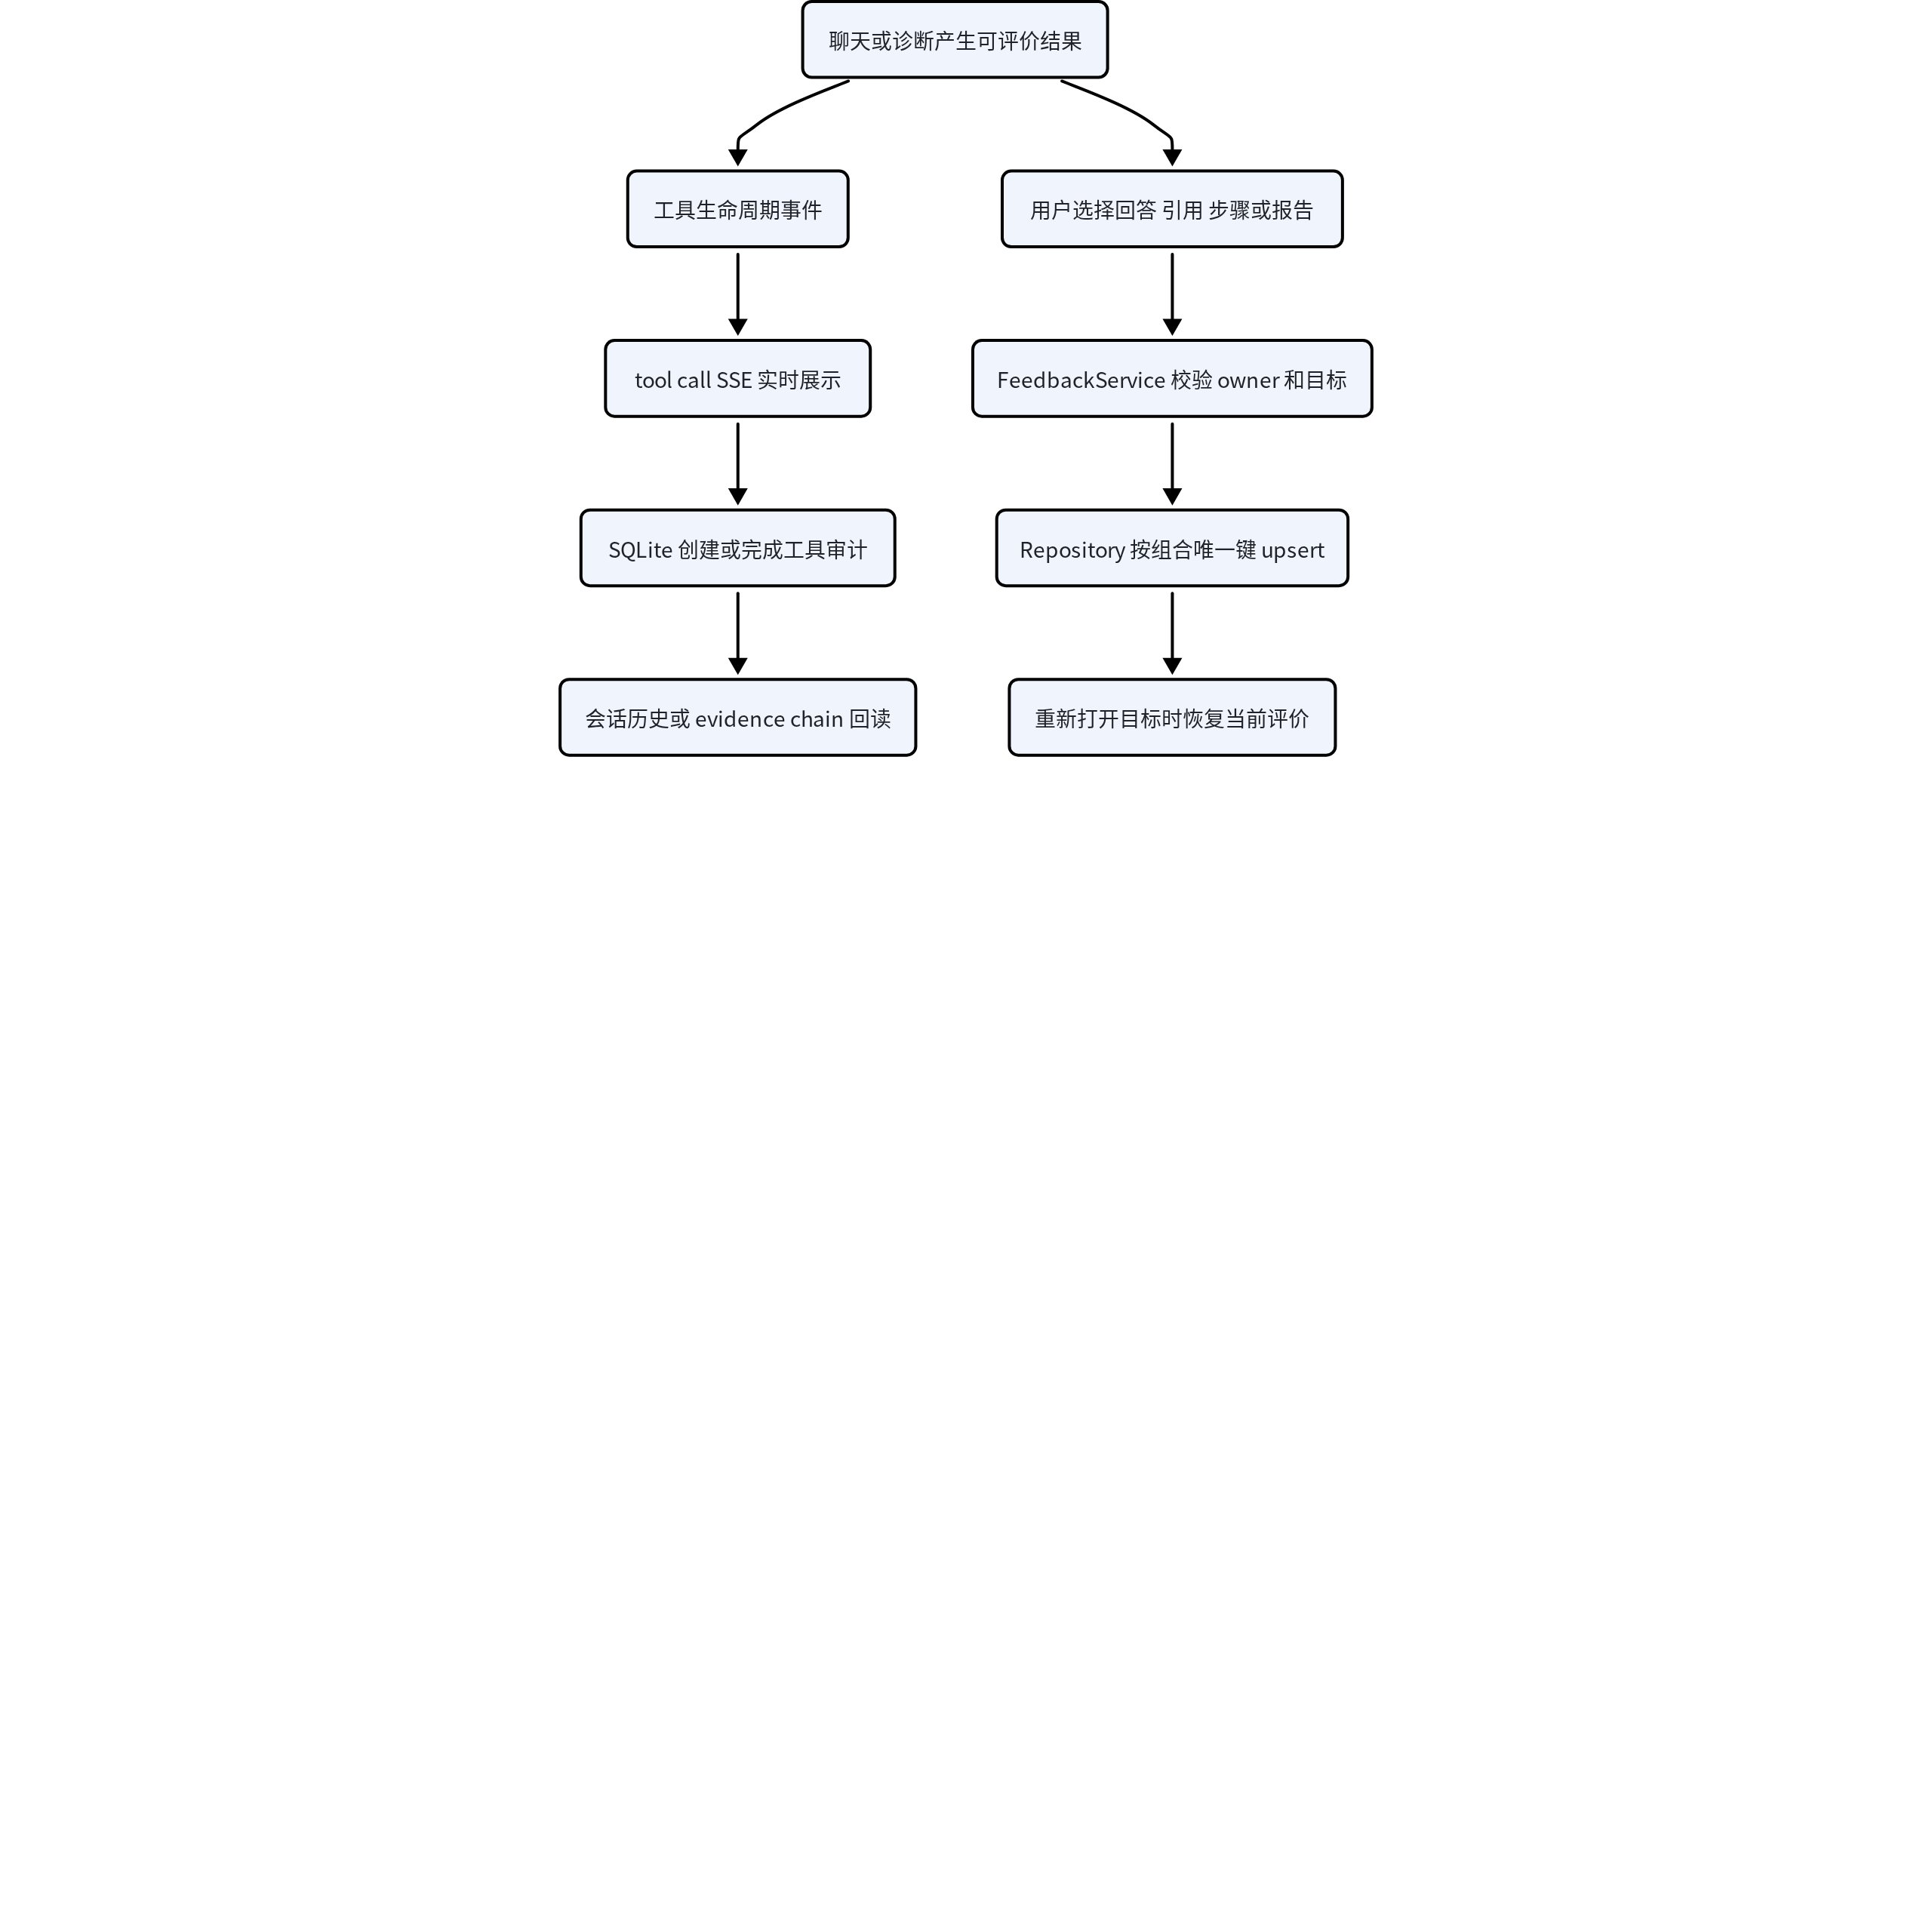
代码调用流程图
审计回答“工具实际做了什么”,反馈回答“用户如何评价结果”。两条链路共享 owner scope,但数据目的和写入时机不同。
关键实现拆解
同一个工具调用 ID 贯穿实时事件与持久记录
LangChain adapter 使用事件的 run_id 作为工具调用 ID;AIOps 则在调用前生成 tool_... ID。started 事件携带工具名与输入,创建审计记录;completed 事件保存有限结果摘要;failed 事件保存安全错误摘要。SQLiteToolCallAuditRepository.finalize 根据完成时间减开始时间计算非负 duration_ms。
📷 [图片 token=OO3Cb4EGnoCXWrxPhv7c35yKnTz(未能下载,见飞书原文)]
看什么:聊天流收到工具生命周期事件后,使用事件自身的 ID 创建或完成审计;started 保存结构化参数,completed 只保存有限结果摘要。
        try:
            if event.status == "started":
                # 1. started 用事件 ID 创建 owner 与会话关联的审计。
                await repository.create_for_chat_session(
                    owner_user_id=owner_user_id,
                    audit_id=event.id,
                    chat_session_id=session_id,
                    tool_name=event.name,
                    arguments=_json_dict_or_empty(event.input),
                )
                return
            if event.status == "completed":
                # 2. completed 用同一个 ID finalize,而不是新建第二条记录。
                audit = await repository.finalize(
                    owner_user_id=owner_user_id,
                    audit_id=event.id,
                    status="completed",
                    result_summary=_audit_summary(event.output),
                )
                if audit is None:
                    await self._create_and_finalize_missing_audit(
                        owner_user_id=owner_user_id,
                        session_id=session_id,
                        event=event,
                        result_summary=_audit_summary(event.output),
                    )
这段代码证明实时事件 ID 是 SSE 与 SQLite 记录之间的稳定关联键。异常边界是整个方法外层采用 best-effort:Repository 写入抛错会被捕获并返回,聊天内容流仍可继续,因此一次成功回答不保证审计一定存在。
如果聊天流先收到 completed/failed 而没有对应 started 记录,_create_and_finalize_missing_audit 会补建后再完成,避免历史中完全丢失一次调用。反过来,只有 started 而没有终止事件时,记录会保留 started、空 completed time 和空 duration,不会虚构完成结果。这对进程中断或上游事件缺失尤其重要。
看什么:补偿函数只处理“收到终止事件但找不到 started 记录”的情况;它先以同一 ID 建立 started,再立刻根据终止事件完成。
        repository = self._repositories.tool_call_audits
        if repository is None:
            return
        # 1. 先补建同 owner、会话和事件 ID 的 started 记录。
        await repository.create_for_chat_session(
            owner_user_id=owner_user_id,
            audit_id=event.id,
            chat_session_id=session_id,
            tool_name=event.name,
            arguments=_json_dict_or_empty(event.input),
        )
        # 2. 再按终止事件内容完成,不反推不存在的输出。
        await repository.finalize(
            owner_user_id=owner_user_id,
            audit_id=event.id,
            status="failed" if error_message is not None else "completed",
            result_summary=result_summary,
            error_message=error_message,
        )
它证明缺 started 的终止事件不会让整次调用从历史中消失,但补偿开始时间只能是补建时刻,因此持续时间不代表真实工具端执行全程。只有 started 没有终止事件时不会触发反向补偿,记录会如实停留在 started。
📷 [图片 token=VjRwbYpaKo1oFnxM7e8c1txRnFc(未能下载,见飞书原文)]
聊天页面在流式期间由 updateLiveToolCall 合并 tool.call 事件,因此用户不必等回答结束才看到工具开始。收到完整流后,store 调用 loadSession;该函数并行读取会话详情和 /chat/sessions/{session_id}/tool-call-audits,用服务器记录替换临时状态。AIOps 页面则从 evidence-chain 中读取同一 ToolCallAudit 结构。
📷 [图片 token=KaT5bsLfzoGYAGxKwBfckQGPn7e(未能下载,见飞书原文)]
看什么:前端回载会话时并行读取消息和持久审计,随后清空流式临时调用;刷新后的事实来源是服务器记录。
  async function loadSession(sessionId: string): Promise<void> {
    const [detail, audits] = await Promise.all([
      client.getSession(sessionId),
      client.listToolCallAudits(sessionId)
    ]);
    // 1. 完整回载后以持久审计替换临时调用。
    activeSessionId.value = detail.session.id;
    messages.value = detail.messages;
    toolAudits.value = audits.items;
    liveToolCalls.value = [];
    setReferencesFromMessages(detail.messages);
    upsertSession(detail.session);
  }

// … 省略其他 store 方法
  // 2. 流式阶段按同一 ID 合并 started/completed/failed。
  const existing = target.value.find((item) => item.id === next.id);
  const merged: LiveToolCall = {
    ...existing,
    ...next,
    ...(next.input === undefined ? {} : { input: next.input }),
    ...(next.output === undefined ? {} : { output: next.output })
  };
这段代码证明页面有“流中临时状态”和“完成后持久状态”两层,而不是只依赖 SSE 缓存。若审计 best-effort 写入失败,回载后临时工具调用可能消失;这不是前端伪造完成状态,而是服务器持久事实缺失的可见结果。
看什么:状态图展示完整、缺 started、缺终止事件三种实际路径,重点是系统只补偿已有事实,不推测未收到的终态。
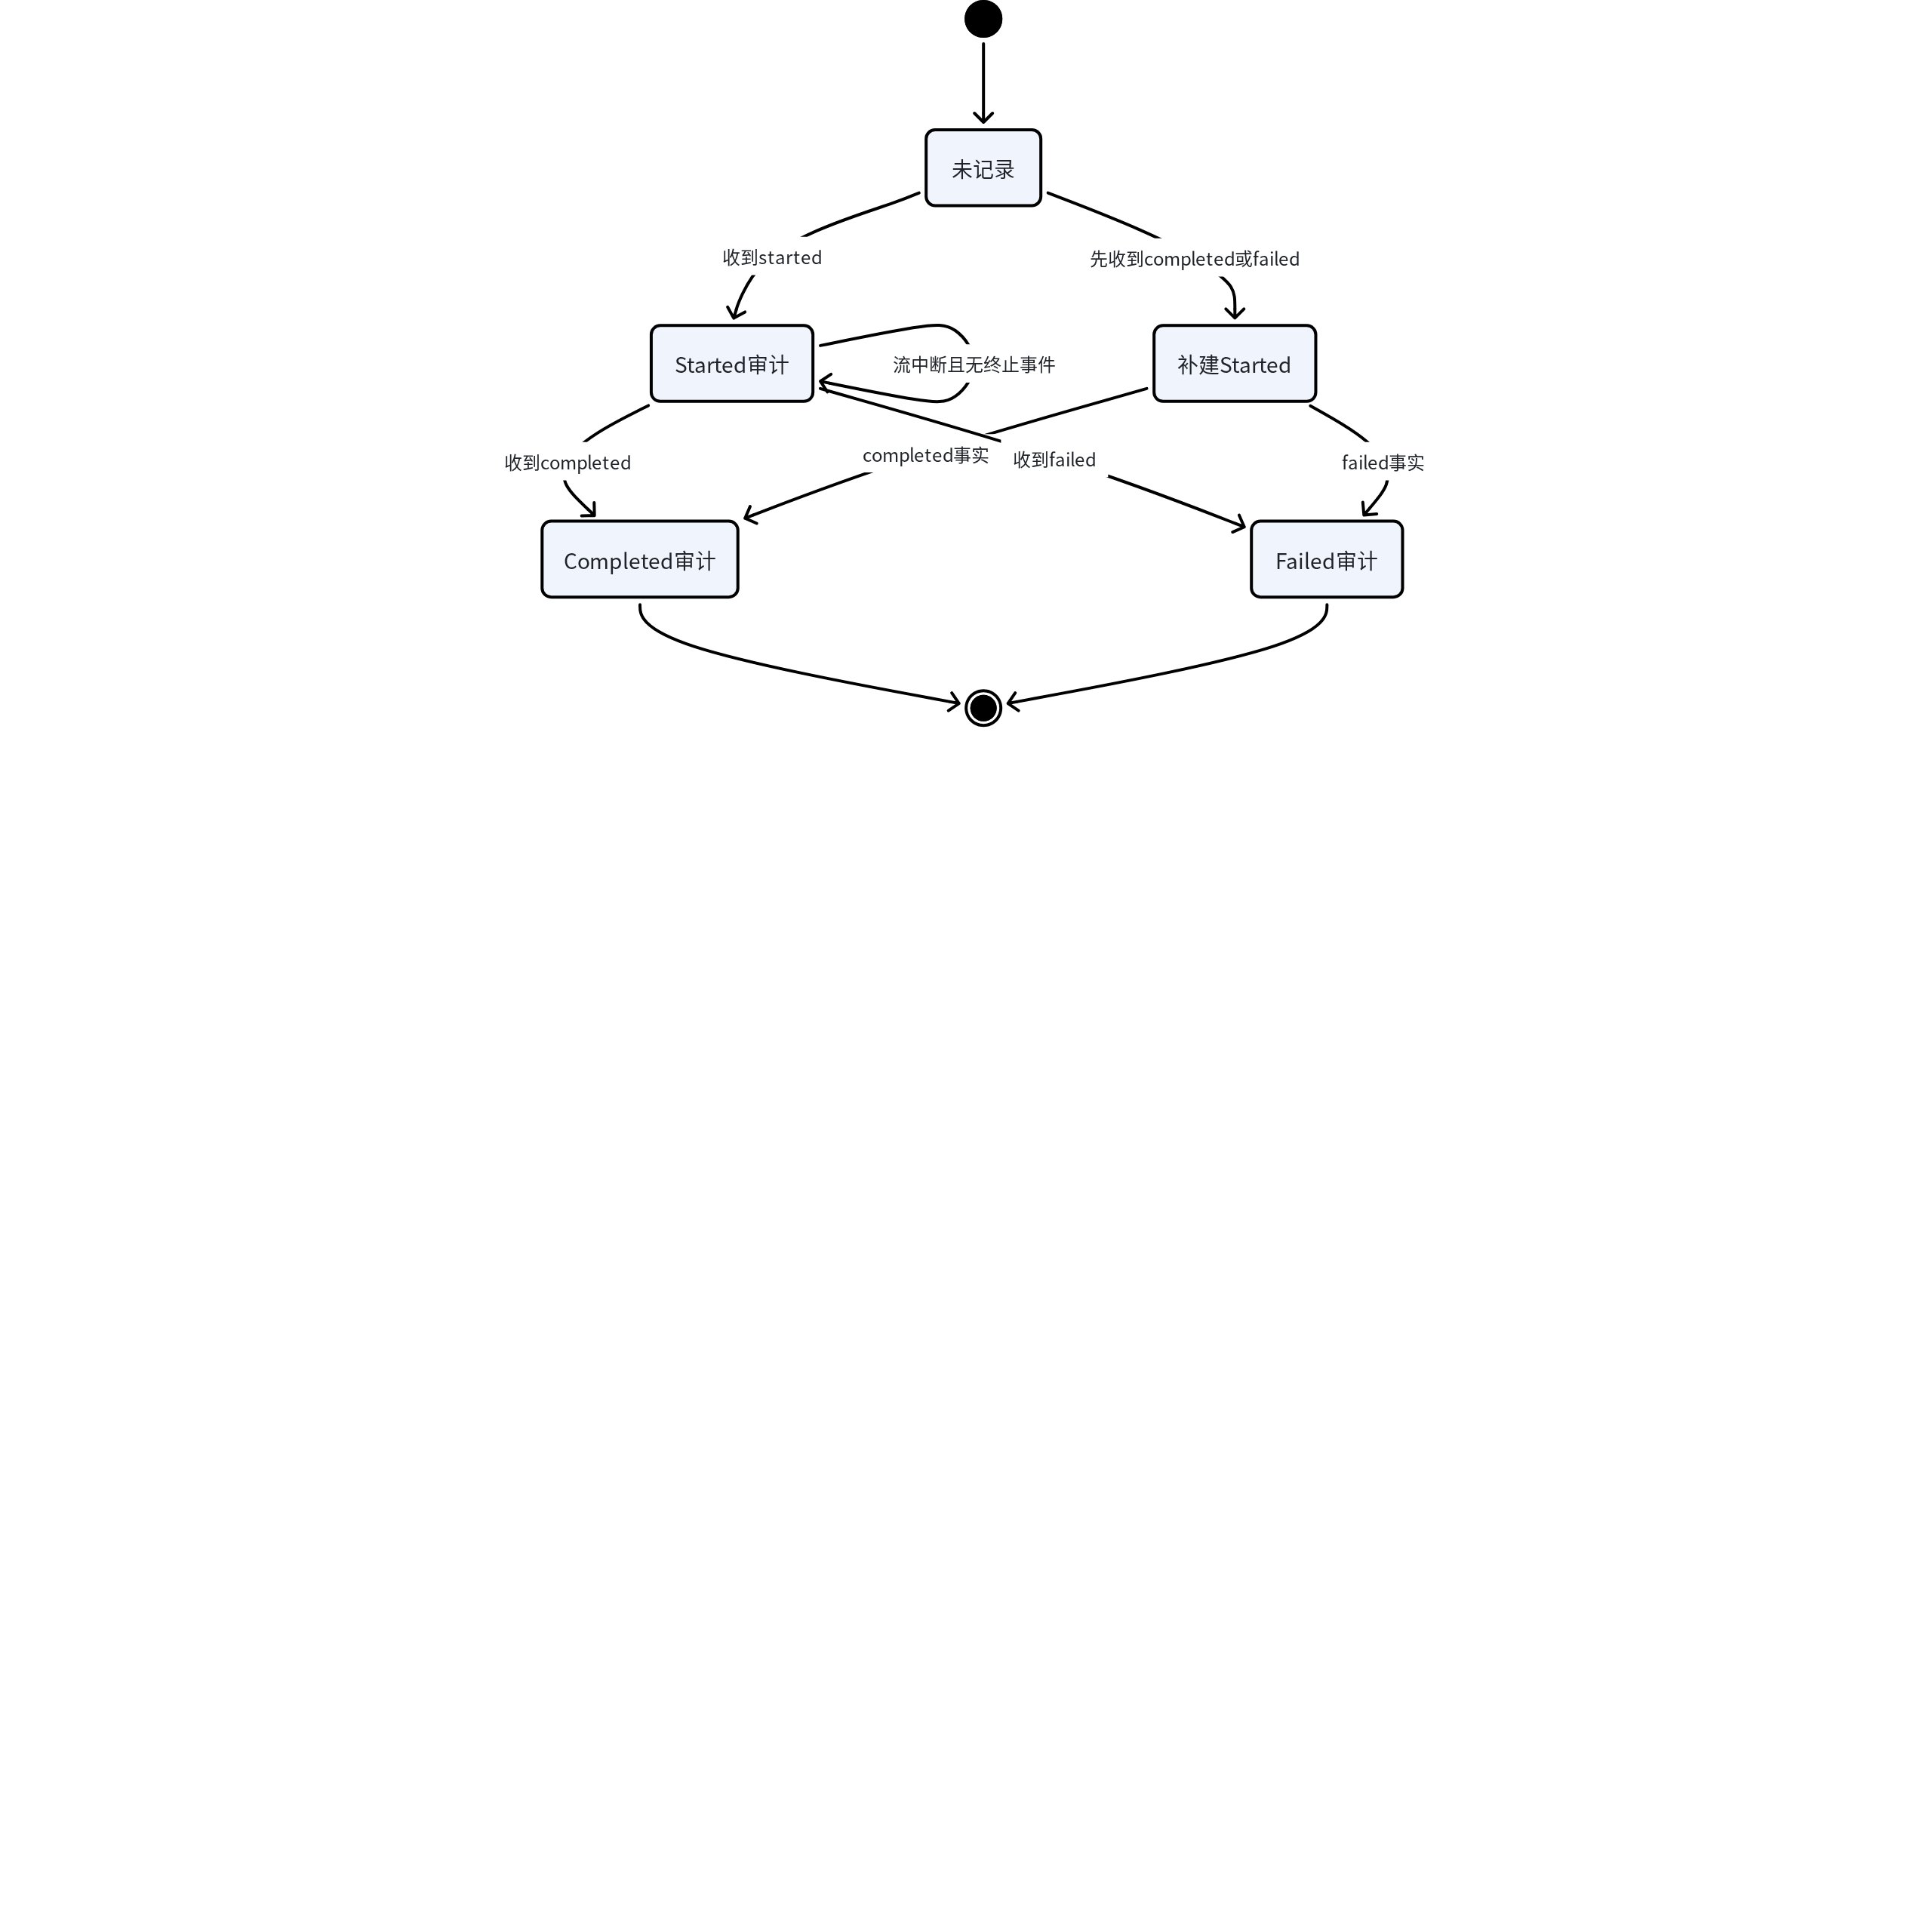
这张图证明 started 是可持久观察的合法状态,而不是必须由清理任务强行改成 failed。审计历史忠实保留事件缺口;业务方应结合聊天完成事件或诊断任务终态解释它。
审计记录、结构化日志和 SSE 各有边界
SSE 面向当前交互,允许前端展示输入或输出;SQLite 审计用于历史追踪,保存 JSON 参数、最多约束长度的结果摘要或错误;结构化运行日志用于运维,只记录工具名、参数键、状态、耗时和错误类别。apps/backend/src/super_ai/mcp_client.py 不把参数值或工具输出写进运行日志,apps/backend/tests/test_mcp_observability.py 对此有明确断言。
📷 [图片 token=L1jCbHSHtoXSvmxos7EcFMoCnSh(未能下载,见飞书原文)]
看什么:SQLite finalize 只在 owner 与 audit ID 同时匹配时更新,完成时间与开始时间计算为非负毫秒;找不到记录返回 None,让上层决定是否补偿。
        timestamp = completed_at or utc_now()
        async with self._session_factory() as session:
            row = (
                await session.scalars(
                    select(AgentToolCallAuditModel).where(
                        AgentToolCallAuditModel.id == audit_id,
                        # 1. finalize 不能跨 owner 命中同 ID 记录。
                        AgentToolCallAuditModel.owner_user_id == owner_user_id,
                    )
                )
            ).one_or_none()
            if row is None:
                return None
            row.status = status
            row.result_summary = result_summary
            row.error_message = error_message
            row.completed_at = timestamp
            # 2. 时钟异常时也不写负 duration。
            row.duration_ms = max(
                0,
                round((timestamp - _ensure_utc(row.started_at)).total_seconds() * 1000),
            )
            await session.commit()
它证明 owner scope 同时约束创建、完成与读取,不是 API 返回前才过滤。边界是 Repository 保存调用参数和摘要本身,并不等同于运行日志的最小字段策略;数据库访问必须继续受认证与父资源权限保护。
📷 [图片 token=W2FfbGOeOoxdGtxxc1IcieqGnJb(未能下载,见飞书原文)]
需要注意的是,业务审计不是一个通用秘密扫描器。聊天的 _audit_summary 将 JSON 序列化结果截断到 2000 字符,错误摘要只清理特定 API key 形式;started 审计会保存结构化参数。它们只通过 owner-scoped API 暴露,但调用工具时仍不应把凭据放进普通参数或结果正文。运行日志脱敏不能被误解为所有数据库审计字段都已自动删除敏感信息。
看什么:业务审计摘要和错误摘要的安全策略非常具体——先 JSON 化并截断,再只对错误文本替换当前正则识别的 key 形态。
def _audit_summary(value: object | None) -> str:
    encoded = json.dumps(_jsonable(value), ensure_ascii=True, separators=(",", ":"), default=str)
    # 1. 结果摘要是长度边界,不是字段级秘密清洗。
    return encoded[:2000]

def _audit_error_summary(value: object | None) -> str:
    # 2. 当前错误清洗只覆盖特定 sk 与 AKID 形式。
    return re.sub(r"(?:sk-[A-Za-z0-9_-]+|AKID[A-Za-z0-9]+)", "[redacted]", _audit_summary(value))
这段代码证明数据库审计不是“绝不含输入输出”,而是受 owner 保护的有界业务记录。未命中正则的凭据仍可能进入审计,因此正确边界是调用端不传秘密、API 做权限校验、运行日志保持最小字段,三者缺一不可。
📷 [图片 token=IyfWb3Wdoof5lGxeGHucJqBEnie(未能下载,见飞书原文)]
聊天侧的审计持久化使用 best-effort 策略:_persist_tool_call_audit 捕获异常,避免审计存储故障中断回答流。这意味着一次聊天回答成功但审计缺失在异常场景下仍可能发生。AIOps 的审计写入属于诊断节点执行链,存储异常可能使节点失败。阅读系统状态时,应以实际审计记录和任务状态为准,不要根据设计意图补齐不存在的数据。
📷 [图片 token=OWyXbQ8zzoaC9Wxo0mLcf7nInId(未能下载,见飞书原文)]
看什么:三数据面图把同一工具事实分流到即时 SSE、owner-scoped SQLite 和最小化结构化日志;每条边的保留内容与失败影响不同。
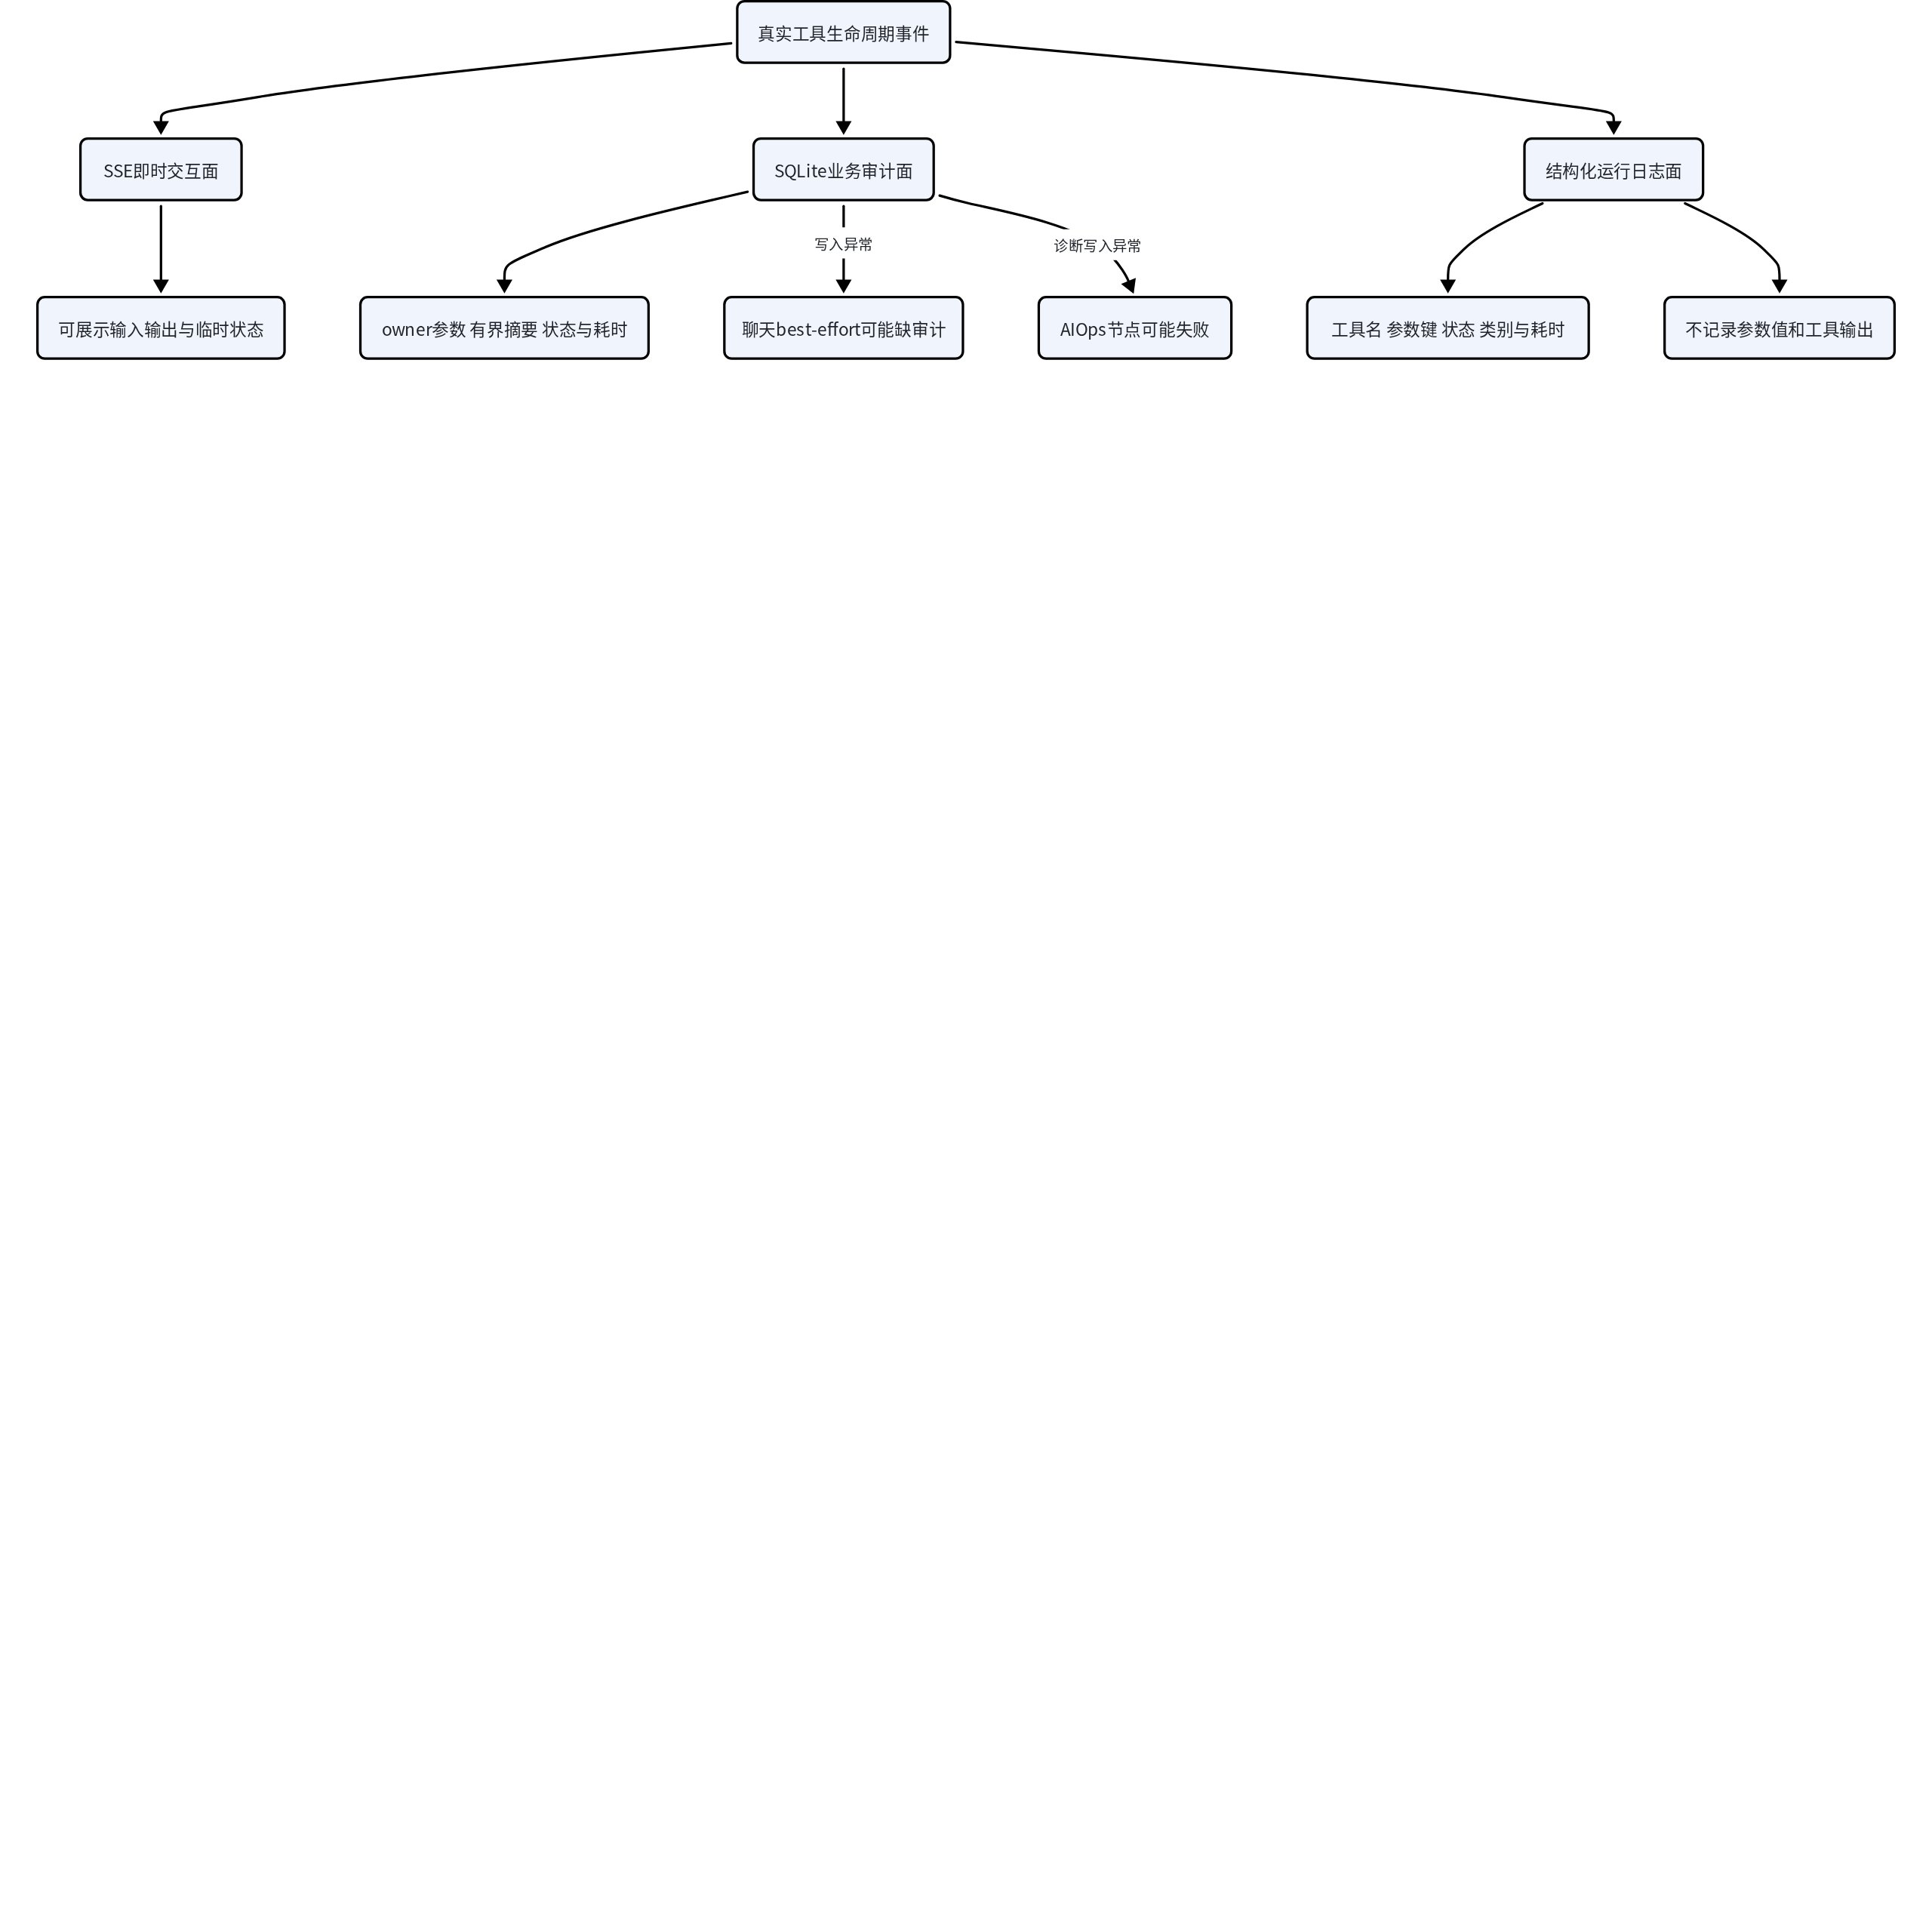
这张图证明“都在记录工具调用”不代表三者数据相同或一致性相同。排障时应先确定观察的是即时 UI、持久历史还是运维日志,再解释缺失;任何一面都不能凭空补成另一面的事实。
反馈首先验证“你能否评价这个对象”
UserFeedbackService 支持 chat_message、citation、diagnostic_step 和 diagnostic_report。聊天目标必须是当前用户拥有的 assistant message;citation 还要求 subject_id 出现在该消息 metadata 的 citations 中;诊断 step 和 report 通过 owner-scoped repository 查询。目标不可访问时统一返回 AUTH_FORBIDDEN,不会泄露其他用户对象是否存在。
📷 [图片 token=ZWs4bEH4Rof9oGxd7VBcYuE2nif(未能下载,见飞书原文)]
看什么:写入前先校验目标类型、评分和所有自由文本长度,再调用目标归属检查;Repository upsert 只有在这些条件全部通过后才发生。
        # 1. 目标类型和评分使用后端白名单。
        if target_type not in SUPPORTED_FEEDBACK_TARGETS:
            raise FeedbackError("VALIDATION_INVALID_ARGUMENT", "Unsupported feedback target.")
        if rating not in SUPPORTED_FEEDBACK_RATINGS:
            raise FeedbackError("VALIDATION_INVALID_ARGUMENT", "Unsupported feedback rating.")
        normalized_subject = _optional_text(subject_id, 160)
        normalized_reason = _optional_text(reason, 80)
        normalized_comment = _optional_text(comment, 2000)
        normalized_correction = _optional_text(correction, 4000)
        # 2. targetId 可由调用者提交,但归属必须再次查库确认。
        await self._require_owned_target(
            owner_user_id=owner_user_id,
            target_type=target_type,
            target_id=target_id,
            subject_id=normalized_subject,
        )
        repository = self._repositories.feedback
        if repository is None:
            raise FeedbackError("SYSTEM_UNAVAILABLE", "Feedback storage is unavailable.")
这段代码证明前端的输入控件不是权限边界,伪造 target ID 仍会在服务层被查库拒绝。reason 当前只受长度约束,并没有后端枚举白名单;前端给出的若干原因选项不能被文档描述成强制协议。
评分只允许 positive 或 negative。subject 最长 160 字符,reason 最长 80,comment 最长 2000,correction 最长 4000;空白会规范化为 null。前端提供 incorrect、incomplete、citation、unsafe 和 other 等问题类型选项,但后端当前只做长度校验,并未把 reason 限定为固定枚举。
📷 [图片 token=MkH8bPVdjoNj8yxmCDacbzv0nbc(未能下载,见飞书原文)]
看什么:归属检查按目标类型分支;citation 不仅要求 assistant message 属于 owner,还要求 subject ID 真正在该消息的 citations metadata 中。
        if target_type in {"chat_message", "citation"}:
            message = await self._repositories.chat.get_message(
                owner_user_id=owner_user_id,
                message_id=target_id,
            )
            # 1. 只允许评价当前 owner 的 assistant message。
            if message is None or message.role != "assistant":
                raise FeedbackError("AUTH_FORBIDDEN", "Feedback target is not accessible.")
            if target_type == "citation" and not allow_citation_collection:
                # 2. citation subject 必须出现在该消息持久 metadata 中。
                if subject_id is None or not _message_has_citation(message.metadata, subject_id):
                    raise FeedbackError("AUTH_FORBIDDEN", "Feedback target is not accessible.")
            return
        if target_type == "diagnostic_step":
            target = await self._repositories.diagnostics.get_step(
                owner_user_id=owner_user_id,
                step_id=target_id,
            )
        else:
            target = await self._repositories.diagnostics.get_report(
                owner_user_id=owner_user_id,
                report_id=target_id,
            )
        if target is None:
            raise FeedbackError("AUTH_FORBIDDEN", "Feedback target is not accessible.")
它证明 citation 评价不能借用同一回答中不存在的 subject,诊断反馈也不能跨 owner 引用 step 或 report。统一 AUTH_FORBIDDEN 有意模糊“对象不存在”和“对象属于别人”,减少枚举泄露。
看什么:权限流程图展示输入合法性、owner 归属和 citation 成员关系三个连续门槛;任一失败都不会进入反馈 Repository。
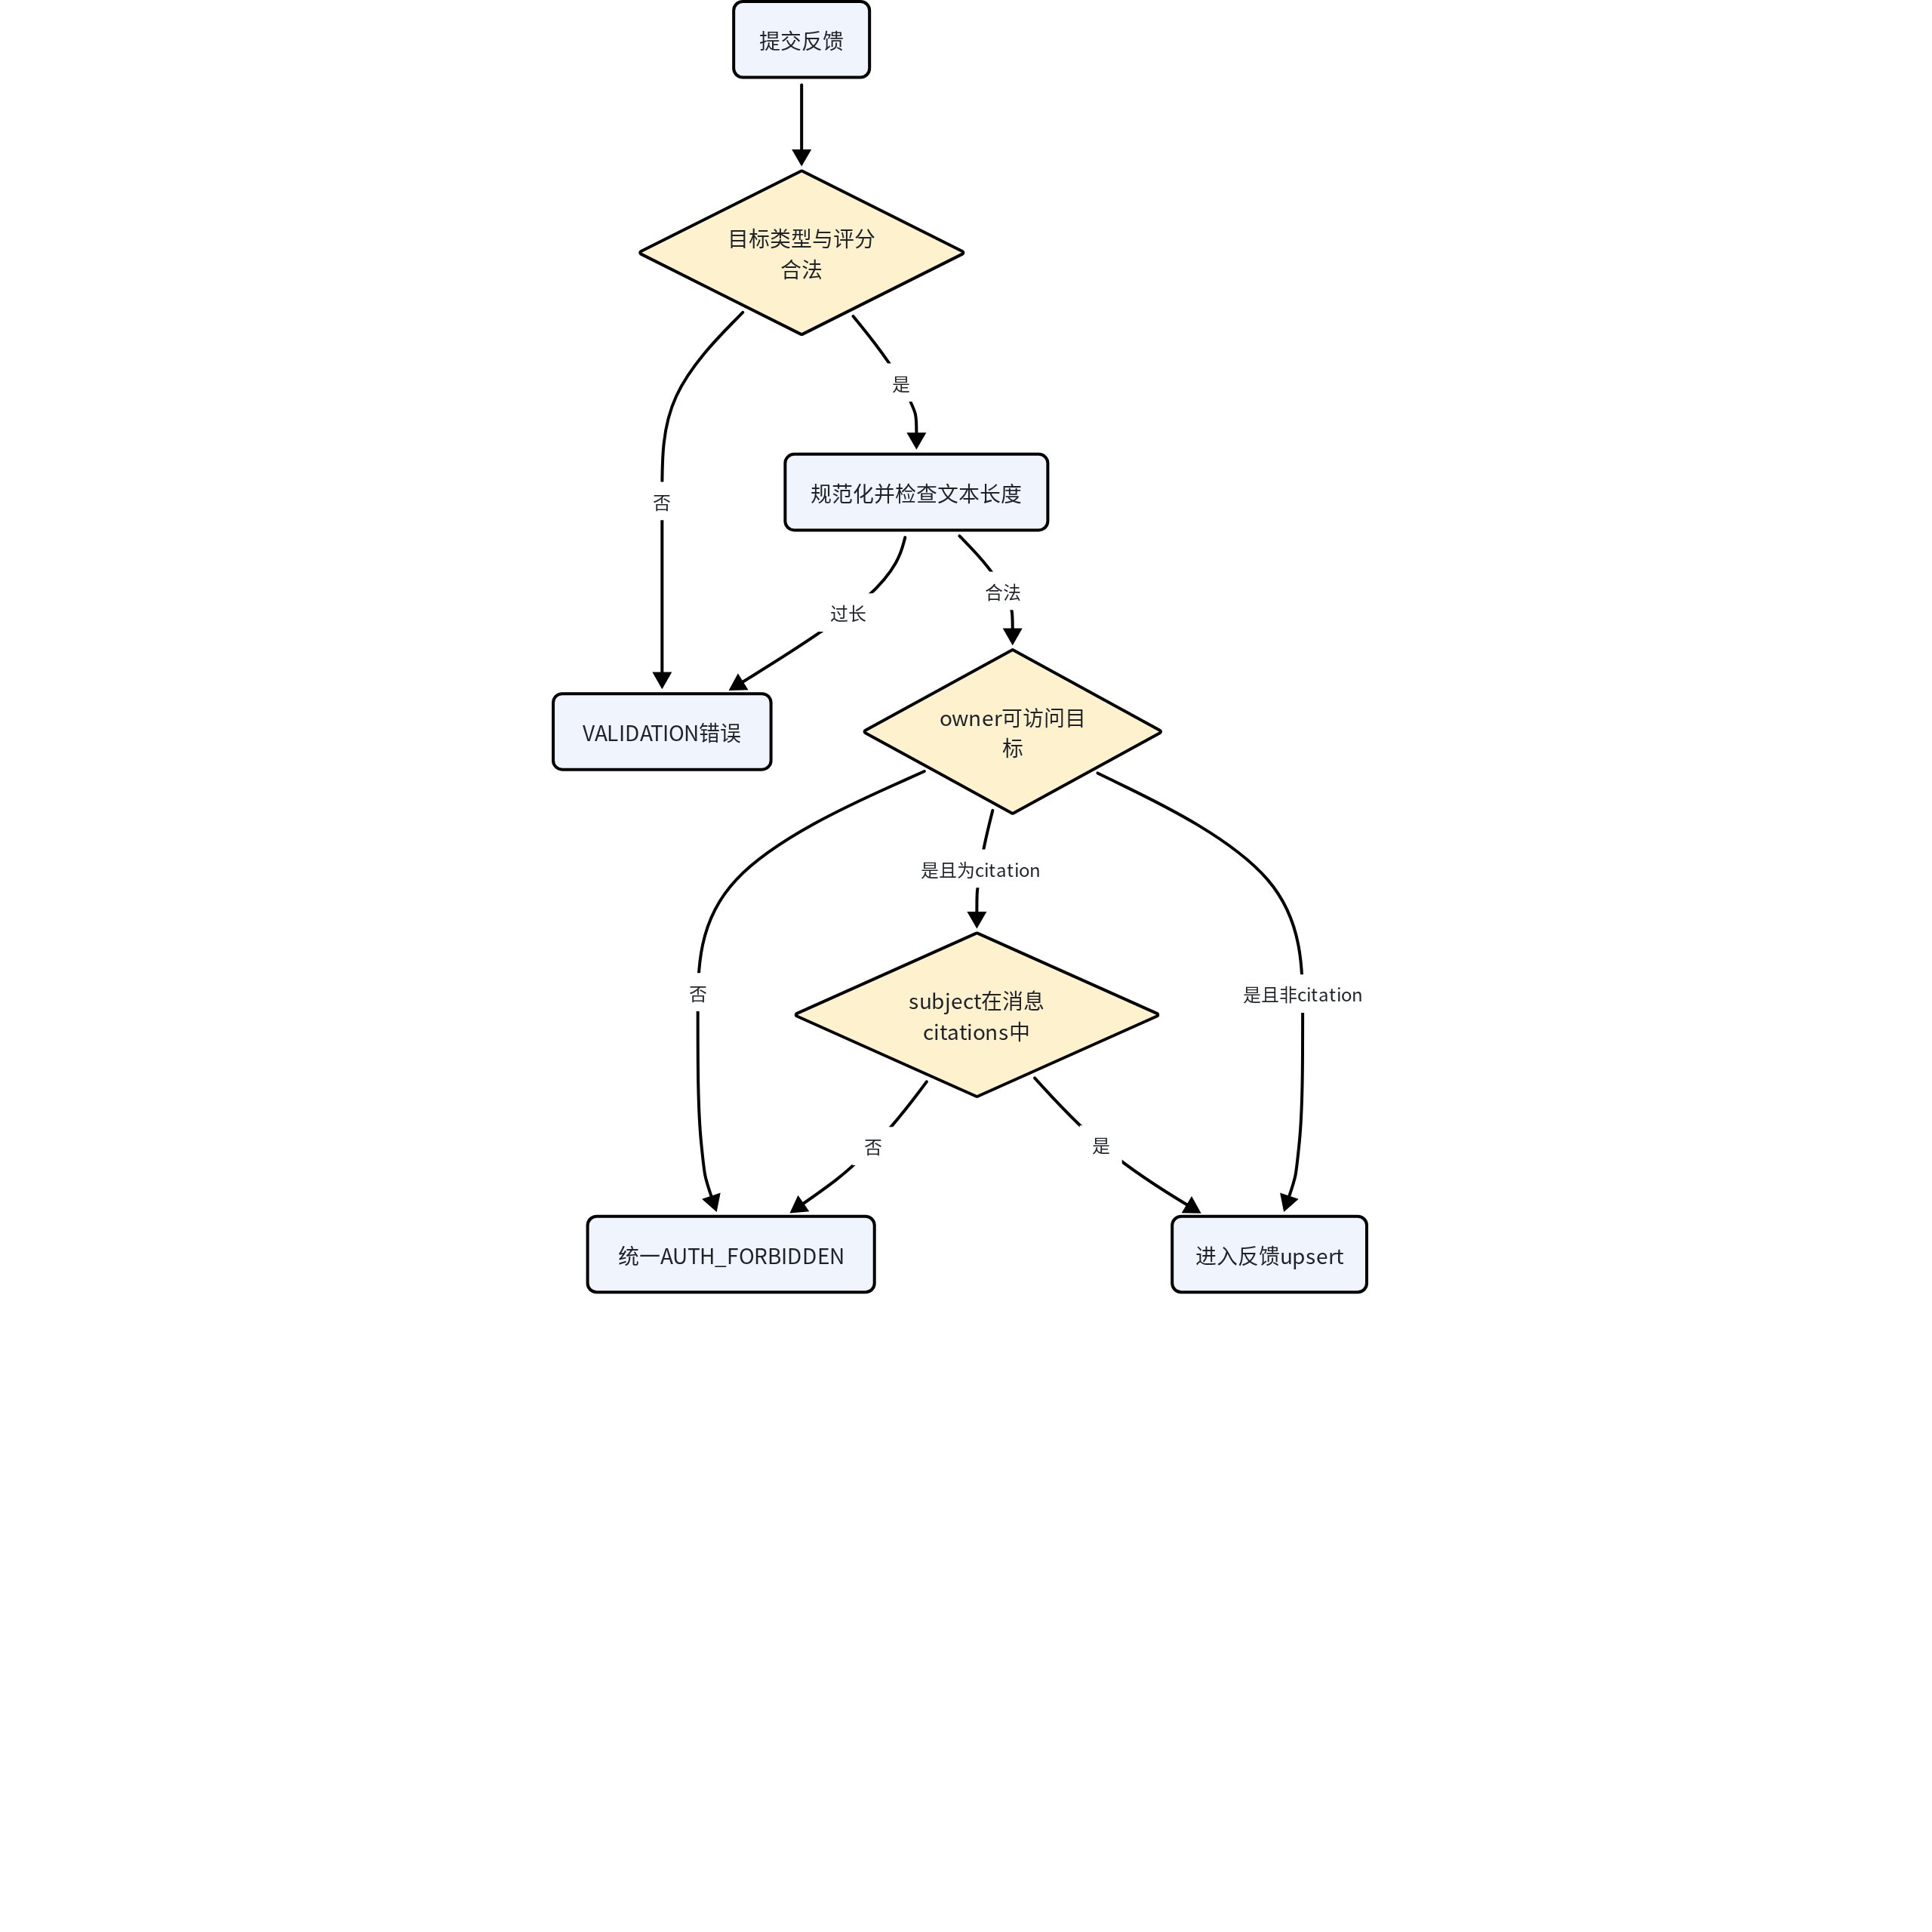
这张图证明反馈权限依赖被评价对象的真实父资源,而不是反馈记录自身携带的 owner 字段。即使请求 schema 已限制类型,服务层仍重复校验,保障非 HTTP 调用路径也遵守同一边界。
重复提交是更新,不是重复计数
UserFeedbackModel 对 owner_user_id + target_type + target_id + subject_key 建立唯一约束。SQLiteUserFeedbackRepository.upsert 先按这个组合查询;没有记录就创建,有记录就更新 rating、reason、comment、correction 和 updated time。一个用户反复修改同一回答或同一 citation 的评价,只保留当前版本。
📷 [图片 token=T2xWbDwVioameQxtoIpcZCM6nac(未能下载,见飞书原文)]
看什么:Repository 把空 subject 规范为 "",用 owner、目标类型、目标 ID 和 subject key 查找现有行;更新分支保留原反馈 ID 和 created time。
        subject_key = subject_id or ""
        now = utc_now()
        stmt = select(UserFeedbackModel).where(
            UserFeedbackModel.owner_user_id == owner_user_id,
            UserFeedbackModel.target_type == target_type,
            UserFeedbackModel.target_id == target_id,
            # 1. 总评价与每条 citation 由 subject_key 区分。
            UserFeedbackModel.subject_key == subject_key,
        )
        async with self._session_factory() as session, session.begin():
            row = (await session.scalars(stmt)).one_or_none()
            if row is None:
                row = UserFeedbackModel(
                    id=feedback_id,
                    owner_user_id=owner_user_id,
                    target_type=target_type,
                    target_id=target_id,
                    subject_key=subject_key,
                    rating=rating,
                    # … 省略其余可选字段与时间字段赋值
                )
                session.add(row)
            else:
                # 2. 重复组合只更新当前版本,不累加一行。
                row.rating = rating
                row.reason = reason
                row.comment = comment
                row.correction = correction
                row.updated_at = now
这段代码证明重复反馈是可修改状态而非事件计数器;统计“用户改了几次”无法从当前表直接得出。数据库唯一约束为并发写提供最后防线,但当前 upsert 是先查后写,极端并发首次提交仍可能由唯一约束抛冲突而不是自动重试。
subject_key 让同一 assistant message 上的总评价与多个 citation 评价互不覆盖。回答反馈使用空 subject,引用反馈使用 citation ID。列表接口按 target 返回当前用户记录,前端 store 再以 target 与 subject 组合键合并;删除时同样带 owner 条件。
📷 [图片 token=MEQ6bODSno6exOxXmhrc8wCSnZb(未能下载,见飞书原文)]
看什么:最后用状态图理解“同一组合键更新、不同 subject 并存”的持久行为,而不是把每次 POST 都画成新反馈。
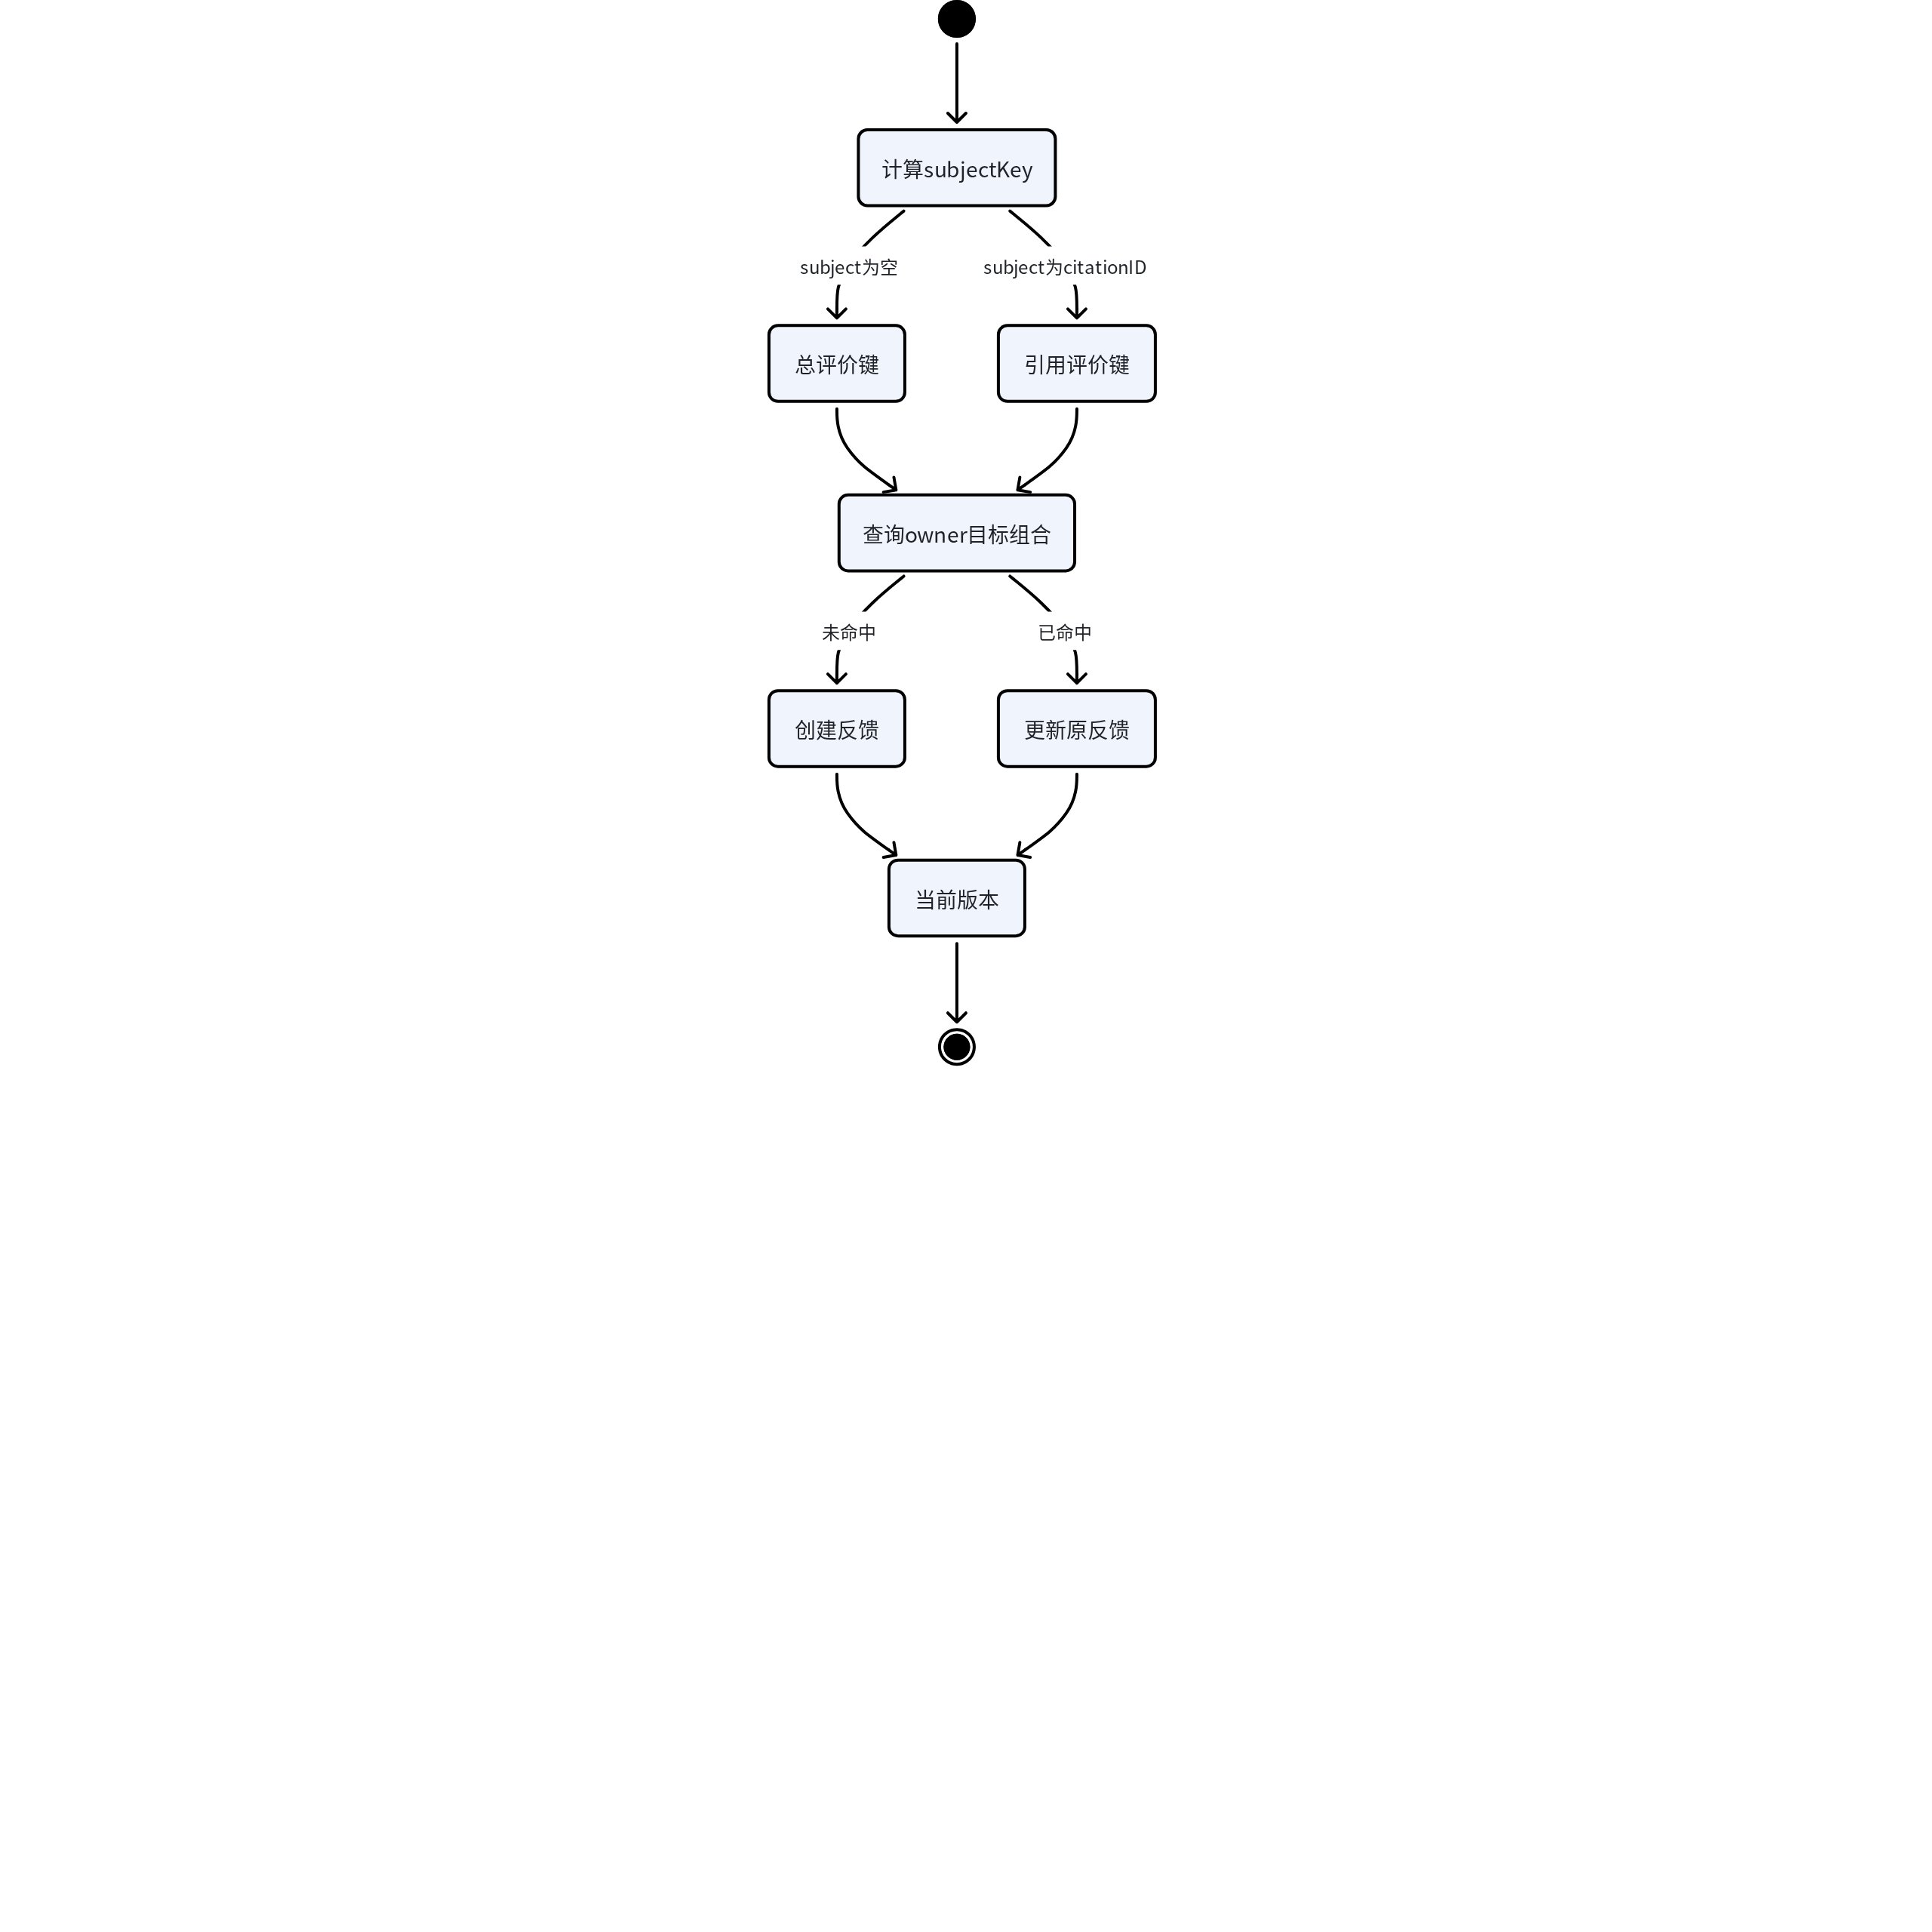
这张图证明总评价和多条 citation 评价可以并存,而同一 citation 的反复提交会覆盖旧值。删除也是 owner-scoped 当前状态变更,不会留下可由该表直接查询的历史版本。
数据、契约与状态
ToolCallAudit 包含 ID、owner、二选一父资源、工具名、状态、arguments、result summary、error message、开始与完成时间、duration 和创建时间。SSE 的 tool.call 还允许 delta,但持久契约只保存 started、completed、failed;前端遇到 delta 时不会创建新的持久态模拟记录。
UserFeedback 保存目标类型、目标 ID、可选 subject、rating、reason、comment、correction 和时间戳。API 提供列表、upsert 与删除,没有把反馈自动转化为模型训练、Prompt 修改或处置动作。反馈是可查询的质量信号,不是自动学习已经发生的证明。
两者的关联目前是间接的。例如 assistant message metadata 保存 citation 与 tool call IDs,工具审计绑定 chat session,反馈绑定 message 或 citation;AIOps evidence-chain 同时返回 steps、tool calls、evidence 和 reports,反馈则绑定 step/report。当前没有一张“反馈直接指向某条工具审计”的关系表,分析时需要通过父资源和页面上下文关联。
📷 [图片 token=DFYdbFG6voQrGBxIyqJcDh02nNd(未能下载,见飞书原文)]
权限、安全与失败边界
审计 repository 在创建时验证 chat session 或 diagnostic task 属于 owner,查询时再次验证父资源,finalize 还要求审计 ID 和 owner 同时匹配。数据库 CheckConstraint 保证一条审计不能同时属于聊天和诊断,也不能两者都为空。跨 tenant 写入会被拒绝。
反馈 service 不相信前端传入的 target type 和 ID,而是重新查询真实目标。citation 不能只凭任意 subject ID 提交;它必须出现在当前用户 assistant message 的 metadata 中。删除其他用户反馈返回 false,API 再映射为统一权限错误。
工具审计只证明调用生命周期和保存的摘要,不证明结果语义正确;用户正向反馈也不证明来源可靠。若工具没有终止事件,应保留 started;若目标不存在,反馈不能保存;若审计或反馈存储不可用,系统必须显示真实失败或保留缺口,不能生成一条看似完整的记录。
📷 [图片 token=T9aLbTpTQoLEnmxPcLPcnd54nfd(未能下载,见飞书原文)]
阅读顺序与小结
先读
packages/api-contracts/src/chat.ts和feedback.ts,建立两类数据的区别。沿聊天或 AIOps 工具事件阅读 audit 的创建、完成和回读。
进入 SQLite model/repository,核对父资源约束、owner 条件和时间计算。
再沿
UserFeedbackControl.vue、store、API 和 service 看目标校验与 upsert。最后沿 owner 条件、目标校验和日志脱敏规则,检查跨 tenant、缺失事件与重复提交边界。
可靠的 AI 工程反馈环不是一组点赞按钮,而是把“执行了什么”和“用户如何评价”分别记录,并保留它们各自的证据强度。OncallAgent 已经具备这两条基础链路,但它不会自动把反馈训练进模型,也不会把审计等同于正确性;后续改进仍需要开发者基于真实记录做判断。