一次诊断如果只停留在任务历史里,它对下一次相似故障的帮助很有限。OncallAgent 会在有最终报告且任务成功时,把诊断结果转换成当前用户拥有的结构化案例、Markdown 知识文档和普通文档索引任务。索引完成后,案例 chunk 与 SOP、普通知识文档一起进入受 tenant 约束的检索链路,后续聊天或 AIOps Planner 才有机会重新找到它。
📷 [图片 token=P9dqbjHcwopIQyx24VRcbr9onyg(未能下载,见飞书原文)]
这不是“把模型回答复制到一个列表”这么简单。自动沉淀需要同时保证成功门槛、幂等性、证据来源、文档元数据、索引状态和 owner 隔离。任何一步失败都不能被悄悄抹平:例如索引失败时,结构化案例仍然可以查询,但不能声称它已经能够被向量检索命中。
📷 [图片 token=BTzebBTQfotbujxk2bTcvueMnPf(未能下载,见飞书原文)]
学习目标
理解成功诊断如何自动生成结构化案例、知识文档和索引任务。
区分案例库记录、知识文档、向量 chunk 和手动“保存到知识库”接口。
掌握案例幂等、owner scope、索引失败和复用可追溯性边界。
能够沿引用中的
knowledgeType=diagnostic-case找回案例来源。
功能入口与完整调用链
自动入口位于 apps/backend/src/super_ai/aiops/diagnostics.py 的 AiopsDiagnosticService._report。Report 节点先持久化报告、证据链接和终态任务;只有状态为 succeeded 且服务装配了 DiagnosisCasePersistor 时,才调用 persist。诊断执行失败时仍可能保存一份解释失败的报告,但不会自动创建案例。
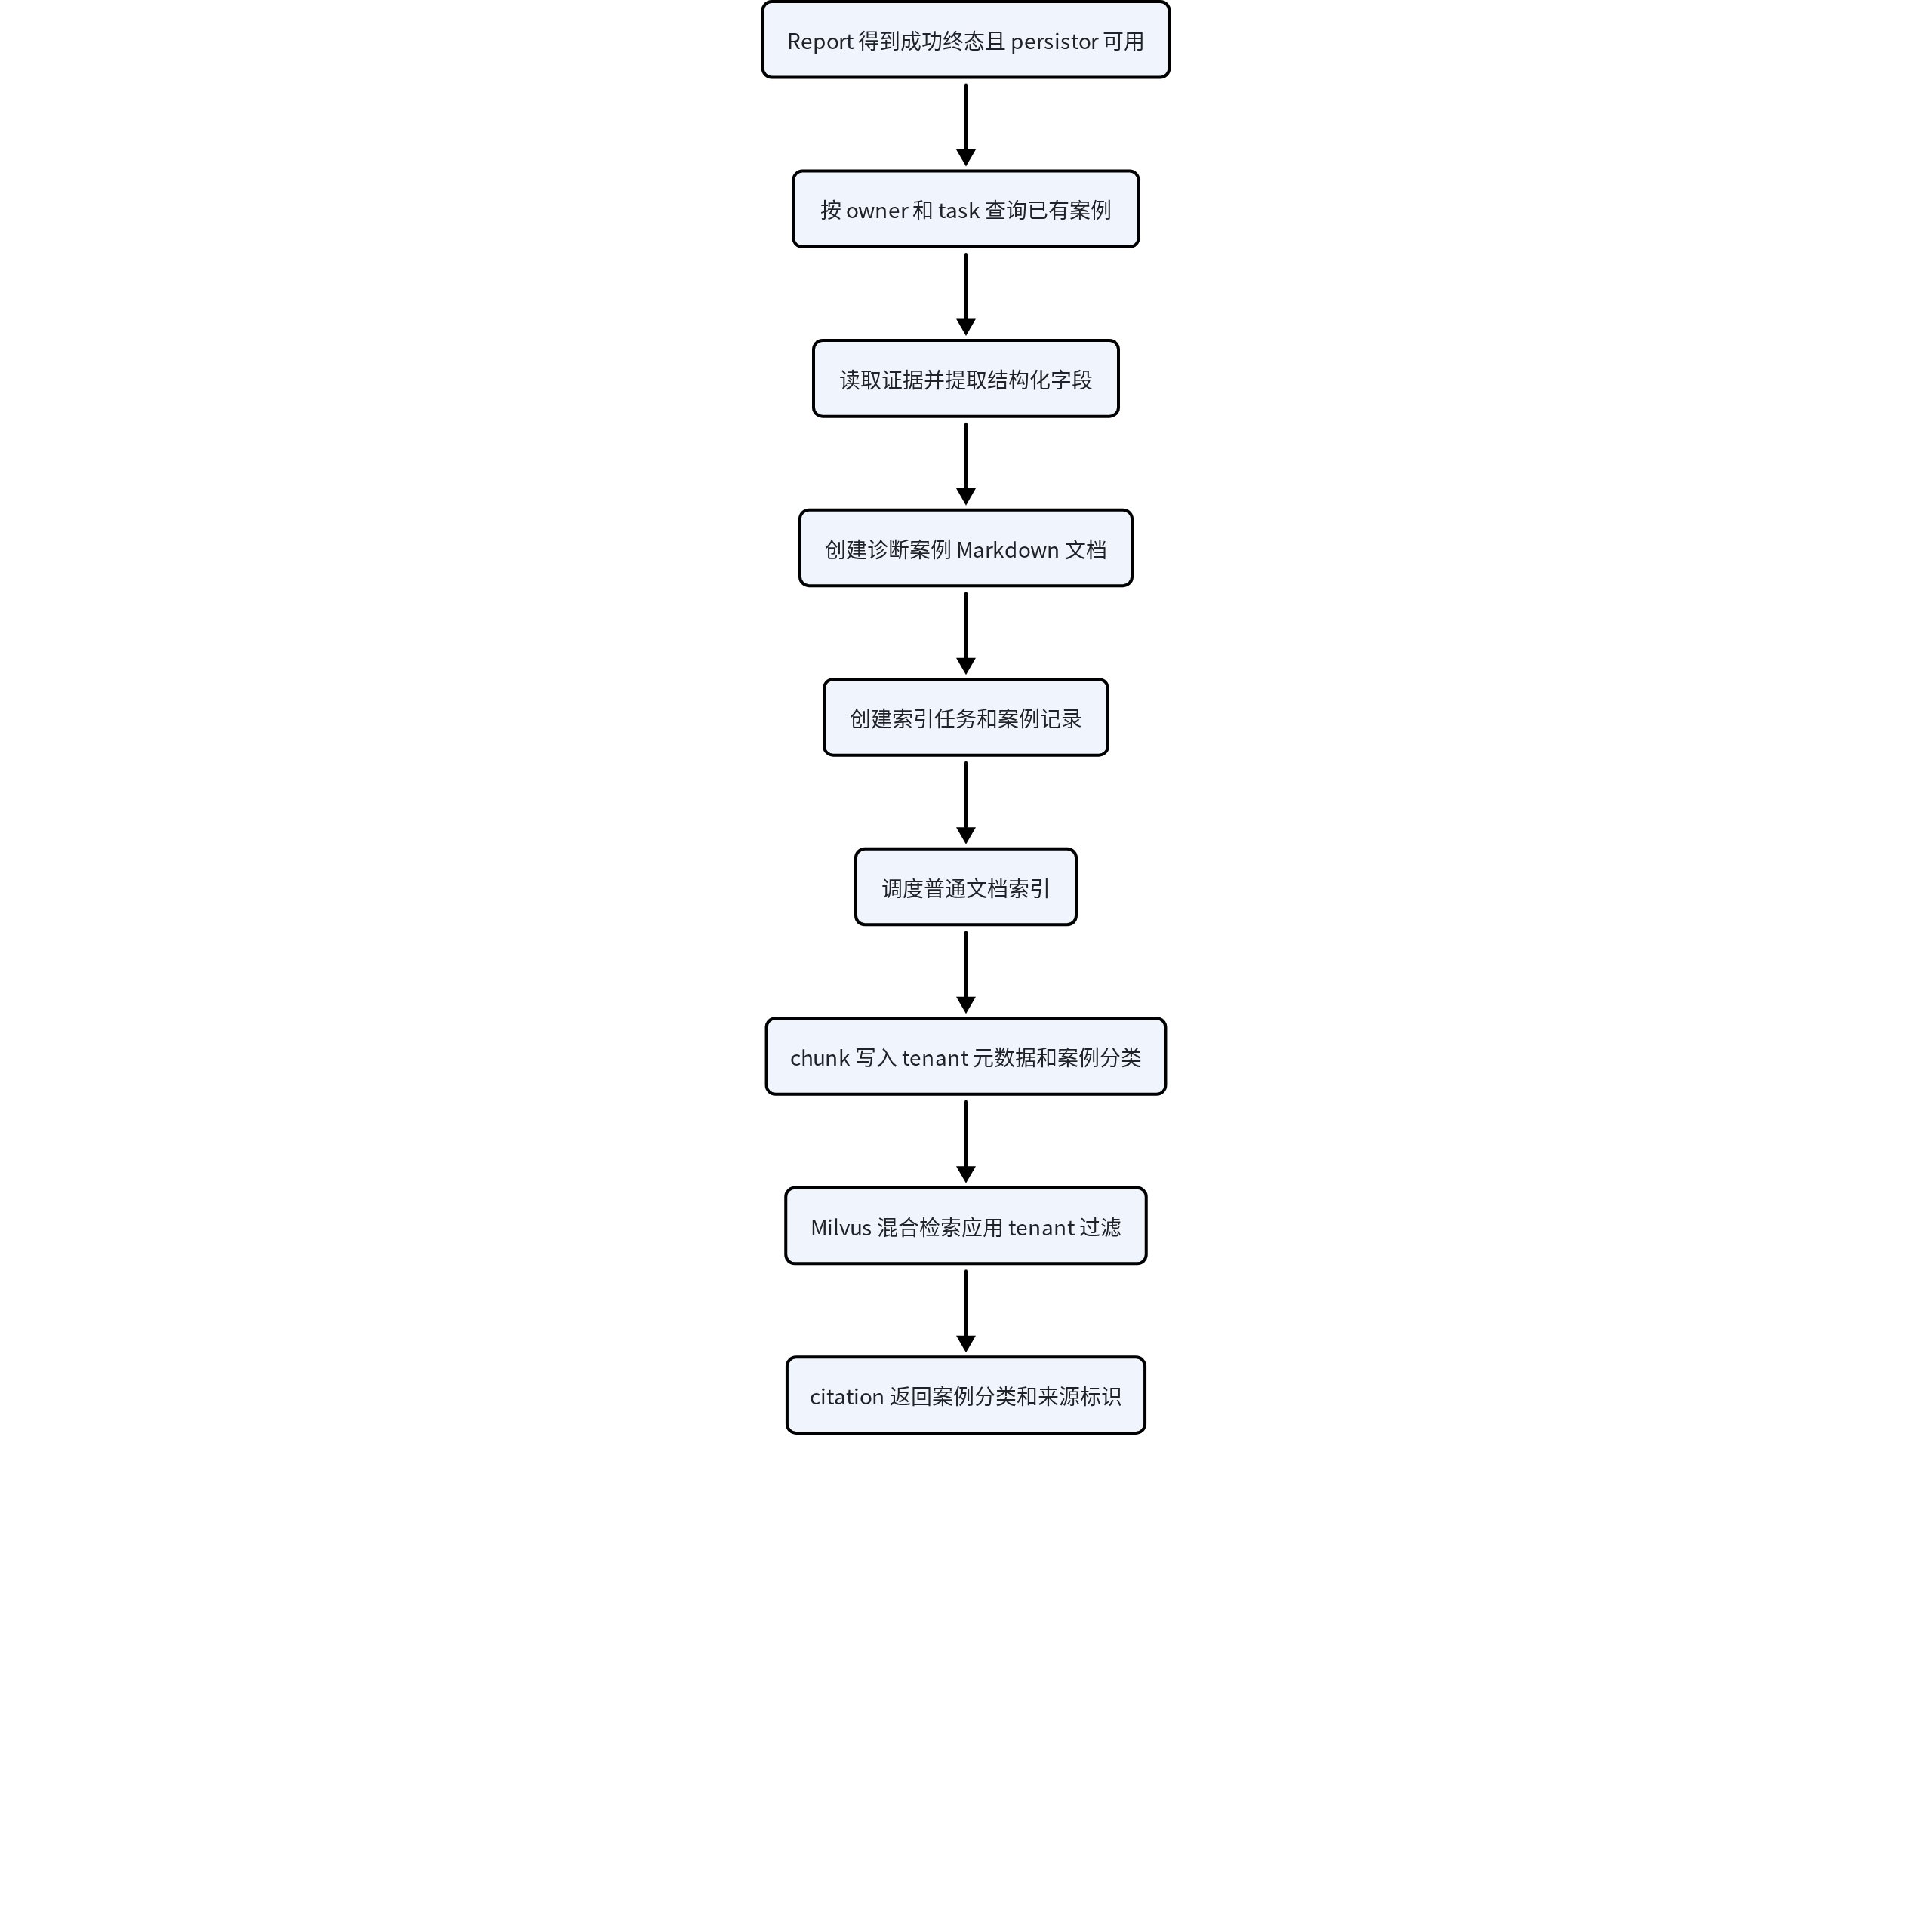
DiagnosisCasePersistor.persist 首先按 owner 和 task 查询已有案例,避免同一任务重复生成。没有已有记录时,它读取任务的全部证据,提取结构化字段,生成案例 Markdown,创建 source=aiops-diagnostic 的知识文档,创建标准 document index task,再创建关联 task、report、document、index task 和 evidence IDs 的案例记录,最后安排索引任务。
📷 [图片 token=XQ8cbfTqro4pK7xhNDmcZLCinJg(未能下载,见飞书原文)]
索引逻辑继续使用普通文档管线。apps/backend/src/super_ai/documents/indexing.py 从文档 metadata 的 indexableText 取得正文,切分并生成 embedding,写入 Milvus 时补充 owner、tenant、knowledge base、document 和 chunk 标识,并把 knowledgeType 固定为 diagnostic-case。后续 KnowledgeRetrievalTool 召回该 chunk 时,citation 会把这个分类返回给前端。
📷 [图片 token=DQHRbCPbwoyMQdxX3ouc8mHznsf(未能下载,见飞书原文)]
成功 Report
  → DiagnosisCasePersistor.persist(owner task, report)
  → 查询同任务已有案例
  → 读取 owner-scoped evidence
  → 提取 alert / service / keywords / summary 等字段
  → 创建 source=aiops-diagnostic 的 Markdown 知识文档
  → 创建标准 document index task
  → 创建结构化 DiagnosticCaseRecord
  → 调度普通索引任务
  → chunk metadata 标记 knowledgeType=diagnostic-case
  → 后续 tenant-scoped 混合检索
  → citation 展示为“故障案例”并保留文档、chunk 和排名信息
核心源码地图
| 源码位置 | 关键符号 | 职责 |
|---|---|---|
apps/backend/src/super_ai/aiops/diagnostics.py | AiopsDiagnosticService._report | 在报告与任务终态持久化后,仅为成功诊断触发自动案例沉淀。 |
apps/backend/src/super_ai/aiops/cases.py | DiagnosisCasePersistor | 生成结构化字段、知识正文、文档、索引任务和案例记录,并保证同任务幂等。 |
apps/backend/src/super_ai/memory/repositories.py | DiagnosticCaseRecord、DiagnosticMemoryRepository | 定义案例与任务、报告、文档、索引任务和证据之间的存储契约。 |
apps/backend/src/super_ai/memory/sqlite.py | SQLiteDiagnosticMemoryRepository.create_case | 校验所有父资源属于同一 owner,并按 owner/task 防止重复案例。 |
apps/backend/src/super_ai/documents/indexing.py | _vector_chunk_record、_knowledge_type | 将案例文档切分、向量化,并给 chunk 写入 diagnostic-case 分类和租户字段。 |
apps/backend/src/super_ai/retrieval/tool.py | KnowledgeRetrievalTool、_citation_from_hit | 在授权知识库内召回案例,并生成包含来源、分类和各阶段排名的 citation。 |
apps/backend/src/super_ai/api/app.py | list_aiops_diagnostic_cases、get_aiops_diagnostic_case | 提供 owner-scoped 案例列表和详情接口;另有独立的手动知识保存接口。 |
packages/api-contracts/src/protected-data.ts | AiopsDiagnosticCase | 定义案例库展示所需的结构化字段和关联 ID。 |
apps/frontend/src/components/AiopsCaseLibrary.vue | caseSummary、select、open-document | 展示当前用户案例,并允许回到原诊断或打开生成的知识文档。 |
openspec/specs/automated-diagnosis-case-library/spec.md | Automatic case persistence | 规定成功门槛、失败不创建、幂等、索引与 owner 隔离。 |
代码调用流程图
案例沉淀不是把报告直接复制到列表里,而是创建标准 Markdown 知识文档、索引任务和案例记录,再复用普通文档索引链路进入 Milvus。
关键实现拆解
只有成功报告进入自动案例库
Report 节点把 execution_failed 映射为任务终态。只要 Executor 发生失败,任务就标为 failed;即使 fallback 报告成功写入,也不会触发 DiagnosisCasePersistor。这个条件很重要:案例库面向可复用的已完成诊断,不应把“工具不可用、证据不足”的失败任务自动包装成已验证经验。
看什么:Report 先根据 execution_failed 计算任务终态,持久化报告和任务后,才用 status == "succeeded" 作为自动案例的唯一入口条件。
        status: Literal["succeeded", "failed"] = (
            "failed" if bool(state.get("execution_failed")) else "succeeded"
        )
        # … 省略报告、证据链接与 result_payload 持久化
        updated_task = await self._repositories.diagnostics.update_task(
            owner_user_id=owner_user_id,
            task_id=task_id,
            status=status,
            result_payload=result_payload,
            completed_at=_now(),
        )
        if updated_task is None:
            raise RuntimeError("Diagnostic task disappeared during report persistence.")
        # 1. 写出 fallback 报告不等于成功;失败任务不会自动沉淀案例。
        if status == "succeeded" and self._case_persistor is not None:
            case = await self._case_persistor.persist(task=updated_task, report=report)
            refreshed_task = await self._repositories.diagnostics.update_task(
                owner_user_id=owner_user_id,
                task_id=task_id,
                status=status,
                # 2. 成功沉淀后把结构化案例 ID 回写任务结果。
                result_payload={**result_payload, "diagnosticCaseId": case.id},
                completed_at=_now(),
            )
这段代码证明“有报告”和“可进入案例库”是两个条件:工具失败后仍可持久化报告,但任务终态阻断自动案例。边界是当 persistor 未注入时,即使任务成功也不会自动创建案例;文档不能把案例生成描述成 Report 模型调用自身的必然副作用。
📷 [图片 token=XCPXbUZd8oQ3WOxKyvncS2AmnsE(未能下载,见飞书原文)]
成功也不等于根因字段一定有内容。_case_fields 从告警输入提取 alert name 和 service,从诊断 query 提取最多十二个关键词,从 report payload 尝试读取 rootCause、remediation 等字段,并从 Markdown 正文生成最多 240 个字符的纯文本摘要。当前 Report payload 主要保存计划、证据和状态,并不保证存在独立的 root cause 或 remediation 字段,所以这两个字段允许为空。教学文档不能把它们描述为始终由模型准确抽取。
📷 [图片 token=AjxmbjOydoBAsjxqvq7cD1QWnDg(未能下载,见飞书原文)]
看什么:下面的状态图把“报告生成方式”和“任务终态”拆成两条维度。无论 LLM 还是 fallback,只要 Executor 失败,自动案例门都保持关闭。
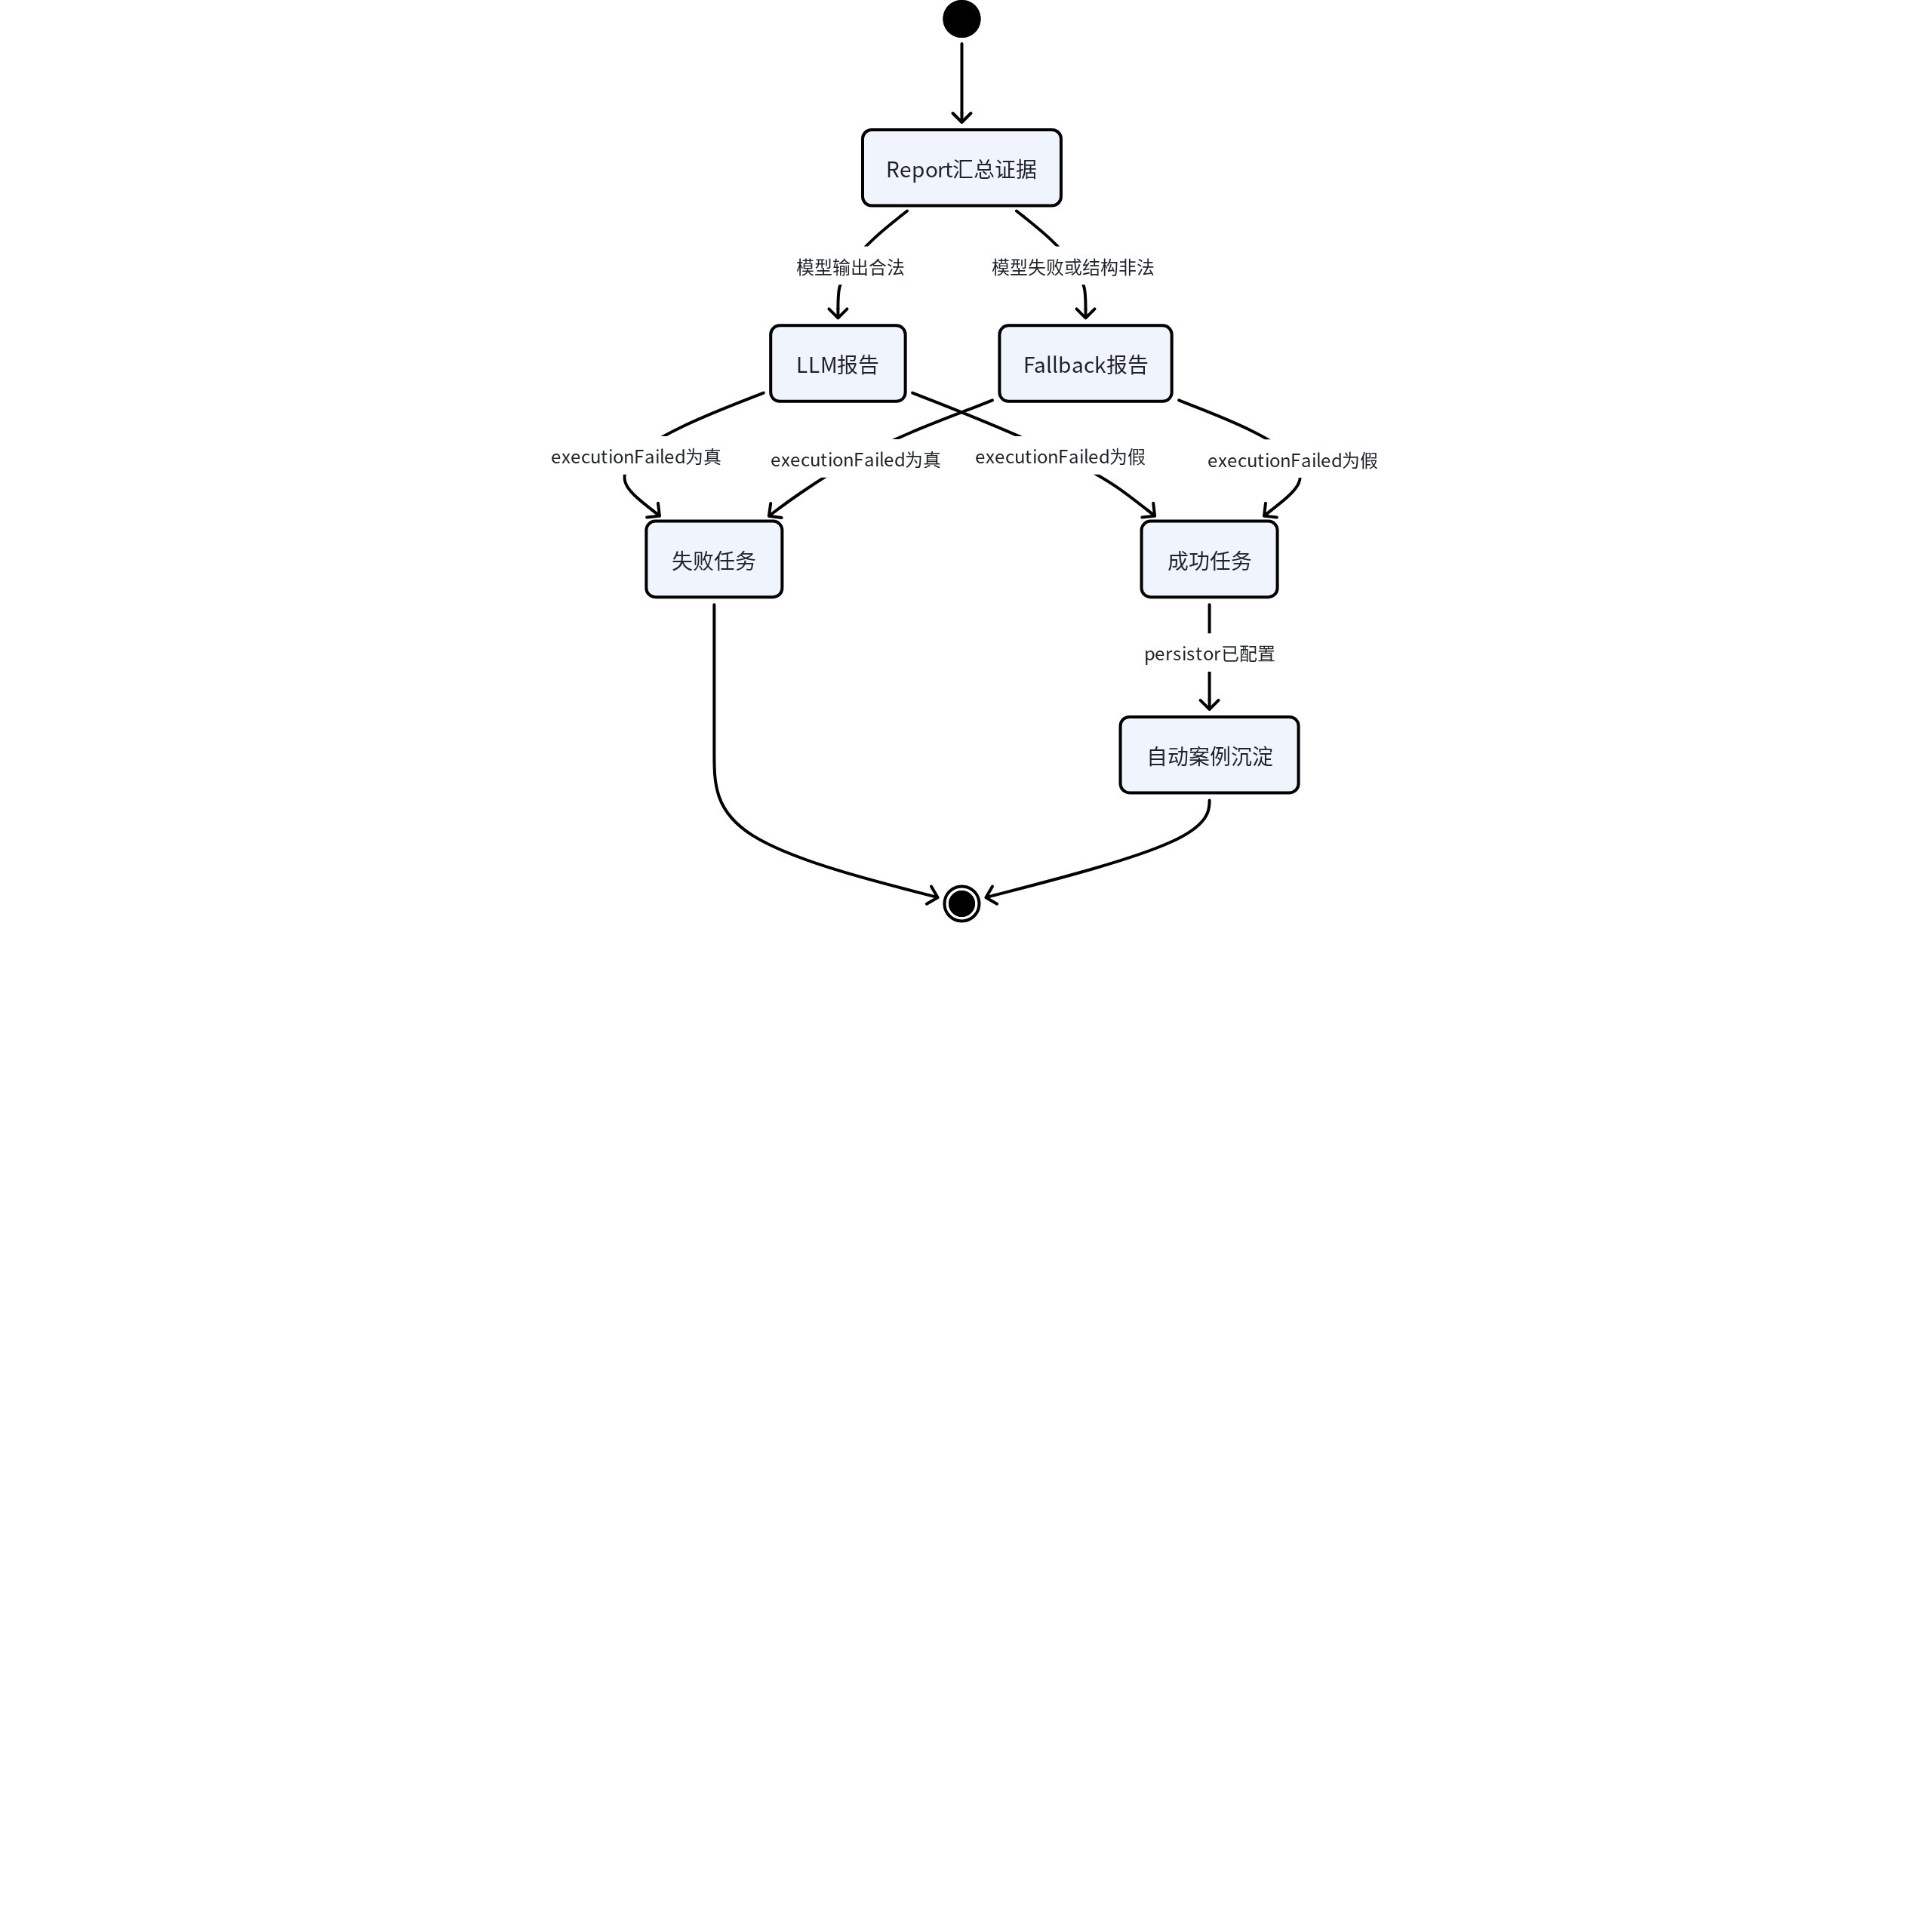
这张图证明 fallback 是报告可用性保障,不是绕过成功门槛的通道。失败任务保留报告用于解释证据缺口,但不会被包装成可复用的自动经验。
结构化案例和知识文档承担不同职责
DiagnosticCaseRecord 是案例库索引:它保存案例 ID、owner、原任务、报告、生成文档、索引任务、告警名、服务、关键词、根因、处置建议、摘要和 evidence IDs。它便于 AIOps 页面快速列出案例,并通过关联 ID 回到原任务、报告和文档。
📷 [图片 token=BklnbwusLow9ukxsDWIcDr6qnsb(未能下载,见飞书原文)]
知识文档则保存实际可索引正文。_case_content 组合任务和报告 ID、告警、服务、关键词、原查询、根因、处置建议、完整证据报告以及每条 evidence 的有限摘要。metadata 同时保存 knowledgeType=diagnostic-case、诊断和报告 ID、证据 ID 列表、结构化字段和 evidence count。这样向量 chunk 即使脱离案例表参与检索,仍能追踪回其来源。
看什么:文档创建复用普通知识 Repository;正文放入 indexableText,metadata 则携带分类、诊断、报告、证据和结构化字段,供后续标准索引链读取。
        document = await self._repositories.documents.create_document(
            owner_user_id=task.owner_user_id,
            document_id=f"doc_{uuid4().hex}",
            knowledge_base_id=knowledge_base_id,
            filename=f"diagnostic-case-{task.id[-12:]}.md",
            size_bytes=len(content.encode()),
            mime_type="text/markdown",
            content_hash=f"sha256:{sha256(content.encode()).hexdigest()}",
            source="aiops-diagnostic",
            metadata={
                # 1. 正文沿用普通文档索引入口。
                "indexableText": content,
                "knowledgeType": "diagnostic-case",
                "diagnosticTaskId": task.id,
                "diagnosticReportId": report.id,
                "evidenceIds": [item.id for item in evidence],
                # 2. 结构化字段同时留在文档 metadata。
                "alertName": fields.alert_name,
                "service": fields.service,
                "keywords": fields.keywords,
                "rootCause": fields.root_cause,
                "remediation": fields.remediation,
                "summary": fields.summary,
                "evidenceCount": fields.evidence_count,
            },
        )
这段代码证明自动案例不是直接向 Milvus 写一段向量,而是先成为 owner-scoped 标准知识文档。安全边界是文档 metadata 与正文都会持久化报告和证据来源,因此它们必须继续由知识库权限保护,不能当作公开摘要。
看什么:文档之后先创建标准索引任务,再创建结构化案例,最后调度该索引任务;案例记录保存的是关联 ID 和用于列表展示的字段,而不是替代知识正文。
        index_task = await self._repositories.document_index_tasks.create_task(
            owner_user_id=task.owner_user_id,
            task_id=f"index_task_{uuid4().hex}",
            knowledge_base_id=knowledge_base_id,
            document_id=document.id,
        )
        # 1. 结构化案例把任务、报告、文档、索引任务和证据串起来。
        case = await self._repositories.diagnostics.create_case(
            owner_user_id=task.owner_user_id,
            case_id=f"diagnostic_case_{uuid4().hex}",
            task_id=task.id,
            report_id=report.id,
            document_id=document.id,
            index_task_id=index_task.id,
            alert_name=fields.alert_name,
            service=fields.service,
            keywords=fields.keywords,
            root_cause=fields.root_cause,
            remediation=fields.remediation,
            summary=fields.summary,
            evidence_ids=[item.id for item in evidence],
        )
        # 2. 案例记录提交后才调度普通文档索引任务。
        scheduled = self._index_task_scheduler.schedule(
            owner_user_id=task.owner_user_id,
            task_id=index_task.id,
        )
它证明案例“可列出”和文档“已完成向量索引”不是同一状态:创建案例后调度任务,索引仍可能排队或失败。后续读取必须查看关联索引任务的真实状态,不能仅凭 DiagnosticCaseRecord 存在就断言 RAG 已可命中。
📷 [图片 token=ZWyDbMW5SoR8I3xLsQxc0mHonDe(未能下载,见飞书原文)]
二者不能相互替代。案例表创建成功但索引任务失败时,页面仍能列出案例及其关联文档;但 Milvus 中没有完成的 chunk,就不能说后续 RAG 已经可以命中。反过来,只保留向量而没有结构化案例,也无法在案例库中稳定关联原任务和证据。
看什么:局部数据流图强调三个持久对象及其不同状态:结构化案例负责导航,知识文档负责正文,索引任务负责把文档送入普通 chunk/向量链路。
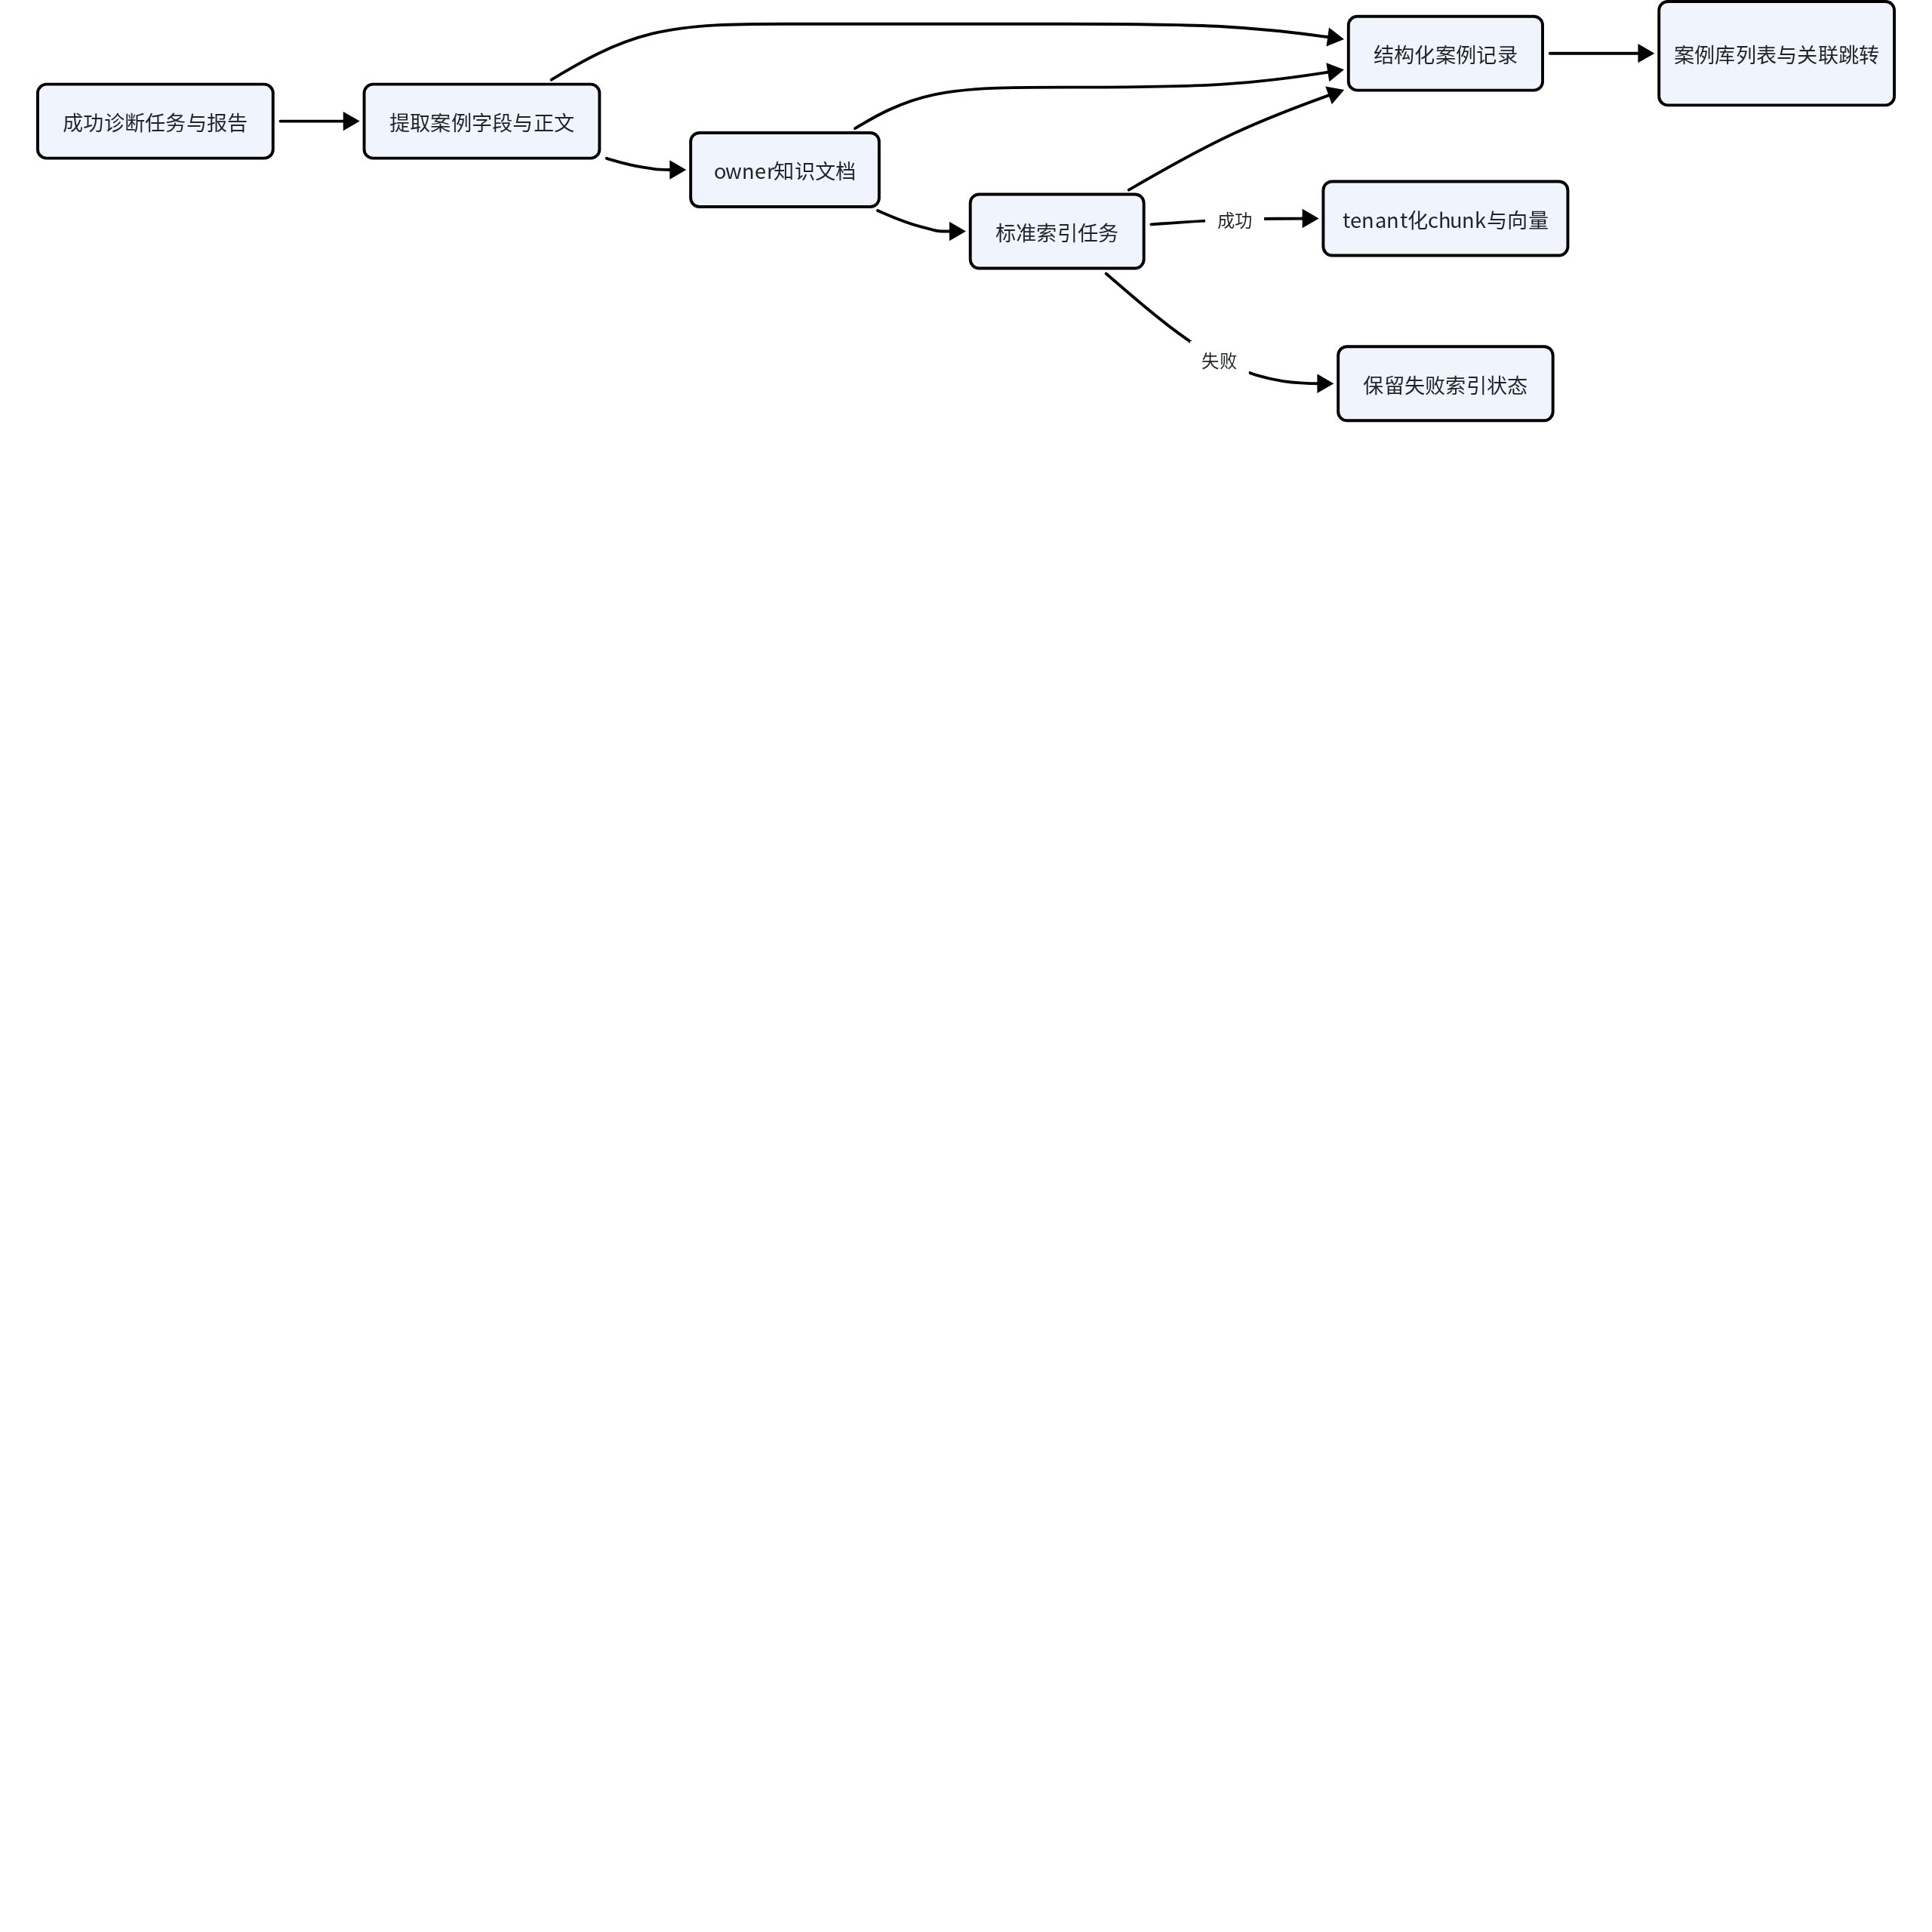
这张图证明失败索引不会自动删除结构化案例或文档;这正是可观察性边界。只有索引任务完成后,向量侧才有可检索 chunk,案例列表本身不是索引完成证明。
📷 [图片 token=A3CEbN7nnoUD2yxkwS2cTVewnqh(未能下载,见飞书原文)]
幂等性建立在 owner 与 task 上
persist 一开始调用 get_case_for_task(owner_user_id, task_id),已有记录时直接返回。SQLiteDiagnosticMemoryRepository.create_case 在写入事务中再次检查同 owner/task,并验证报告属于该任务、索引任务关联的文档 ID 一致、文档位于相同 owner 范围。双层检查防止重复进入时创建多份案例,也阻止把其他用户的报告或文档拼接成一个案例。
📷 [图片 token=KlUwbAal1oPk6zxgkf1cICZ8nWf(未能下载,见飞书原文)]
看什么:第一层检查发生在创建文档之前,适合拦截同一任务的顺序重复处理;返回的是已有案例,而不是重新生成正文或索引任务。
        # 1. 幂等查询同时携带诊断 owner 与 task。
        existing = await self._repositories.diagnostics.get_case_for_task(
            owner_user_id=task.owner_user_id,
            task_id=task.id,
        )
        if existing is not None:
            # 2. 顺序重入直接返回已有结构化案例。
            return existing

        evidence = await self._repositories.diagnostics.list_evidence(
            owner_user_id=task.owner_user_id,
            task_id=task.id,
        )
这段代码证明正常重试不会在已有案例时继续创建文档。它不是分布式锁:两个并发调用都可能在案例尚未写入时读到空,因此还必须理解 Repository 内层检查及跨资源事务边界。
看什么:第二层检查位于案例 Repository 的事务中;在真正插入前,它重新找同 owner/task 的案例,并验证报告、索引任务和文档的父子关系。
        async with self._session_factory() as session:
            # 1. 内层检查防止第二条结构化案例记录提交。
            existing = await _find_diagnostic_case_for_task(session, owner_user_id, task_id)
            if existing is not None:
                return _diagnostic_case_record(existing)
            await _require_diagnostic_report(session, owner_user_id, task_id, report_id)
            index_task = await _require_document_index_task(session, owner_user_id, index_task_id)
            if index_task.document_id != document_id:
                raise TenantScopeError(
                    f"Document index task does not match document: {index_task_id}"
                )
            # 2. 文档也必须位于相同 owner 与知识库范围。
            await _require_document(
                session,
                owner_user_id,
                index_task.knowledge_base_id,
                document_id,
            )
            session.add(row)
            await session.commit()
        return _diagnostic_case_record(row)
它证明跨 tenant 拼接报告、索引任务或文档会在 Repository 边界被拒绝,结构化案例也不会重复提交。但文档与索引任务在调用此方法之前已分别提交,所以整个 persist 不是单事务;极端并发重入仍可能产生未被最终案例引用的额外文档或索引任务,不能把内层检查描述成全流程原子幂等。
📷 [图片 token=HP9ZbuafQo55trxprBgcWN28nje(未能下载,见飞书原文)]
这里的幂等对象是“结构化自动案例”,不是任意正文哈希。不同诊断任务即使内容相近,仍可各自形成案例;同一任务重复触发则只保留一个。它与手动保存接口的 SHA-256 重复检测不是同一种规则。
📷 [图片 token=NEJDbsPZCo5vOPxdp0ScGxWunzb(未能下载,见飞书原文)]
看什么:下面的时序图把两层检查与非原子窗口放在同一张图里。教学重点不是承诺绝无多余工件,而是明确哪一层保护哪一种对象。
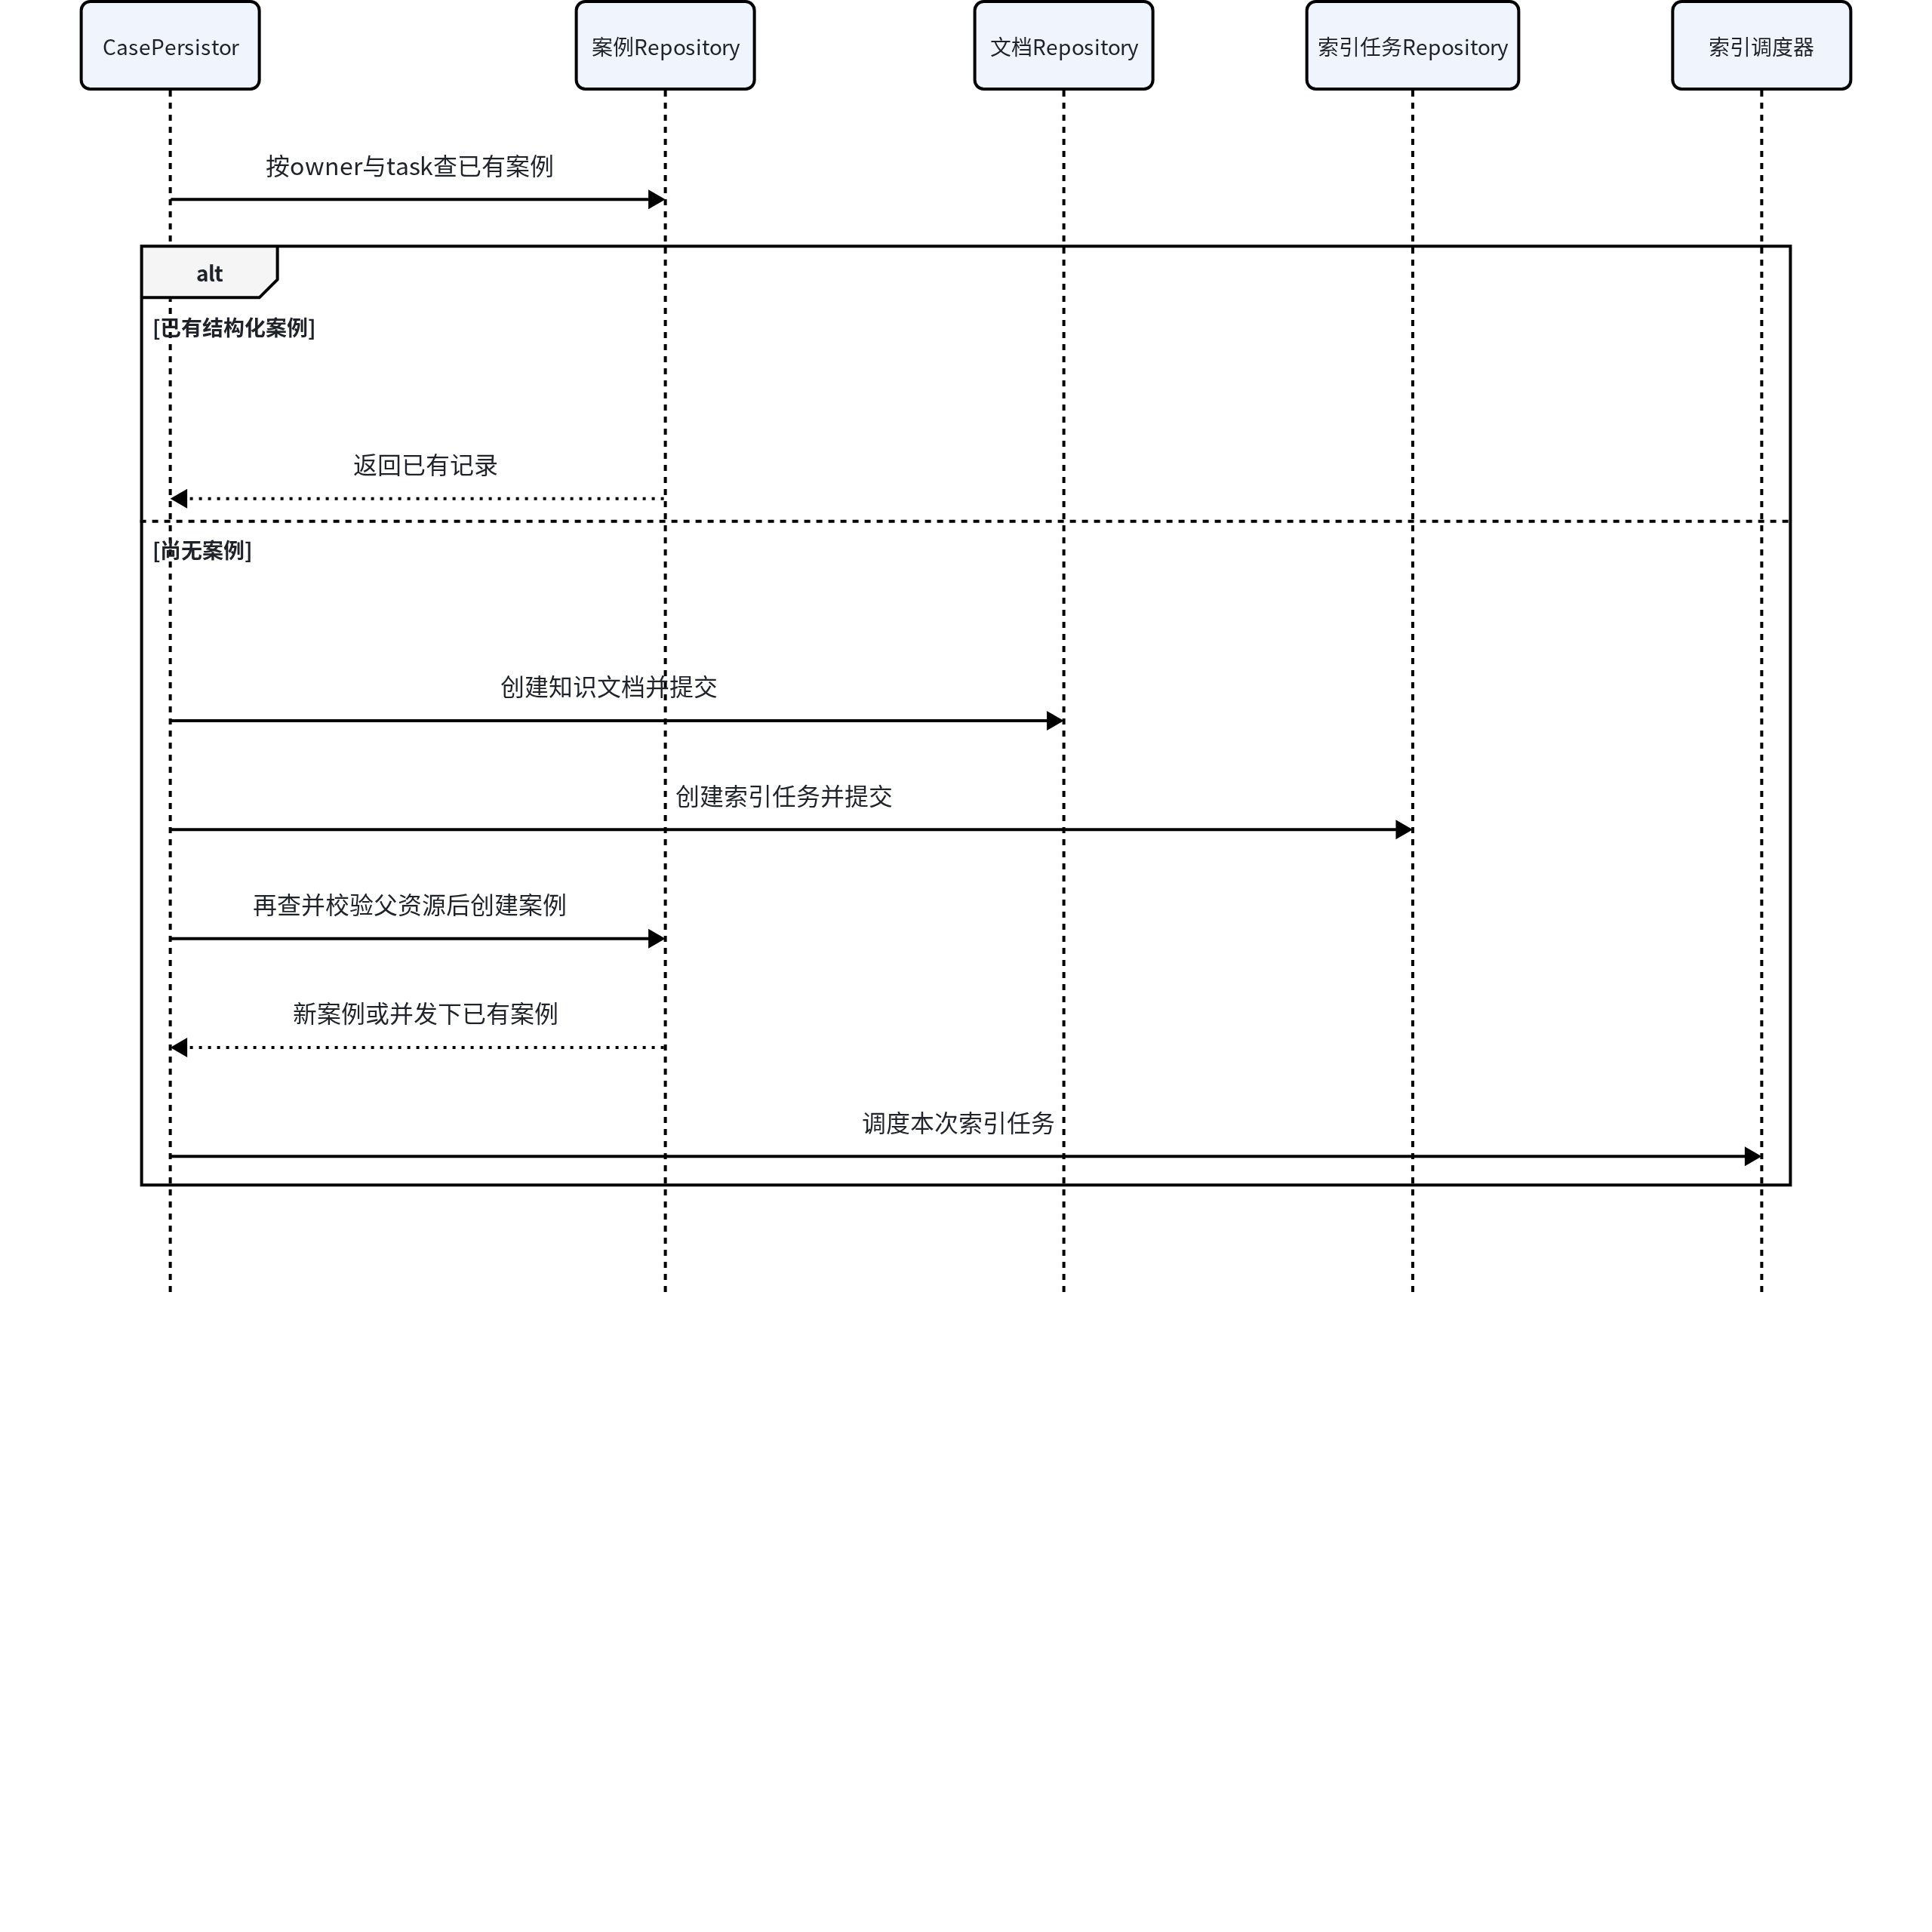
这张图证明外层检查优化顺序重入,内层检查保护结构化案例与 owner 关联;两次检查之间仍存在文档和索引任务已提交的窗口。排查重复工件时应分别查看三类表,而不是只数案例行。
自动沉淀与手动保存是两条路径
POST /aiops/diagnostics/{diagnostic_id}:save-to-knowledge 是单独的手动导出路径。它要求任务为 succeeded,读取最新报告与证据,生成另一份 Markdown,按内容哈希检查重复,然后创建知识文档和索引任务。这个路由本身不创建 DiagnosticCaseRecord;自动案例库由 Report 节点中的 DiagnosisCasePersistor 负责。
看什么:手动路由先按当前 user 读取成功任务和最新报告,再按生成正文的 SHA-256 在该用户知识库中查重;冲突时在创建文档之前返回业务错误。
        task = await repositories.diagnostics.get_task(owner_user_id=user.id, task_id=diagnostic_id)
        if task is None or task.status != "succeeded":
            raise ApiErrorException("AUTH_FORBIDDEN")
        reports = await repositories.diagnostics.list_reports(
            owner_user_id=user.id,
            task_id=task.id,
        )
        report = reports[-1] if reports else None
        if report is None:
            raise ApiErrorException("BUSINESS_NOT_FOUND")
        evidence = await repositories.diagnostics.list_evidence(
            owner_user_id=user.id,
            task_id=task.id,
        )
        content = _diagnostic_case_content(task, report, evidence)
        content_hash = f"sha256:{sha256(content.encode()).hexdigest()}"
        knowledge_base_id = f"kb_{user.id}"
        # 1. 手动保存以 owner、知识库和正文哈希查重。
        duplicate = await repositories.documents.find_active_by_hash(
            owner_user_id=user.id,
            knowledge_base_id=knowledge_base_id,
            content_hash=content_hash,
        )
        if duplicate is not None:
            # 2. 冲突不会创建第二份手动知识文档。
            raise ApiErrorException("BUSINESS_CONFLICT")
这段代码证明手动保存的幂等键是正文哈希,而非诊断 task;内容相同会冲突,内容变化后可能生成新文档。权限边界也更严格:不可访问与非成功任务都使用统一禁止响应,不向其他用户泄露任务状态。
因此页面中的“案例库”与手动“保存到知识库”不能在文档里合并成一个按钮逻辑。前者对成功诊断自动发生并带结构化案例;后者是用户显式创建知识文档的补充入口,并以内容哈希防重复。区分两条路径有助于排查“案例已经出现,但手动保存又返回冲突”或“文档已生成,但案例表没有新增”等问题。
📷 [图片 token=WiMtbIhmKo75xJxlIDhcRLWanjd(未能下载,见飞书原文)]
看什么:对照图从同一个成功诊断分成两条互不替代的路径,特别注意只有自动路径写结构化案例。
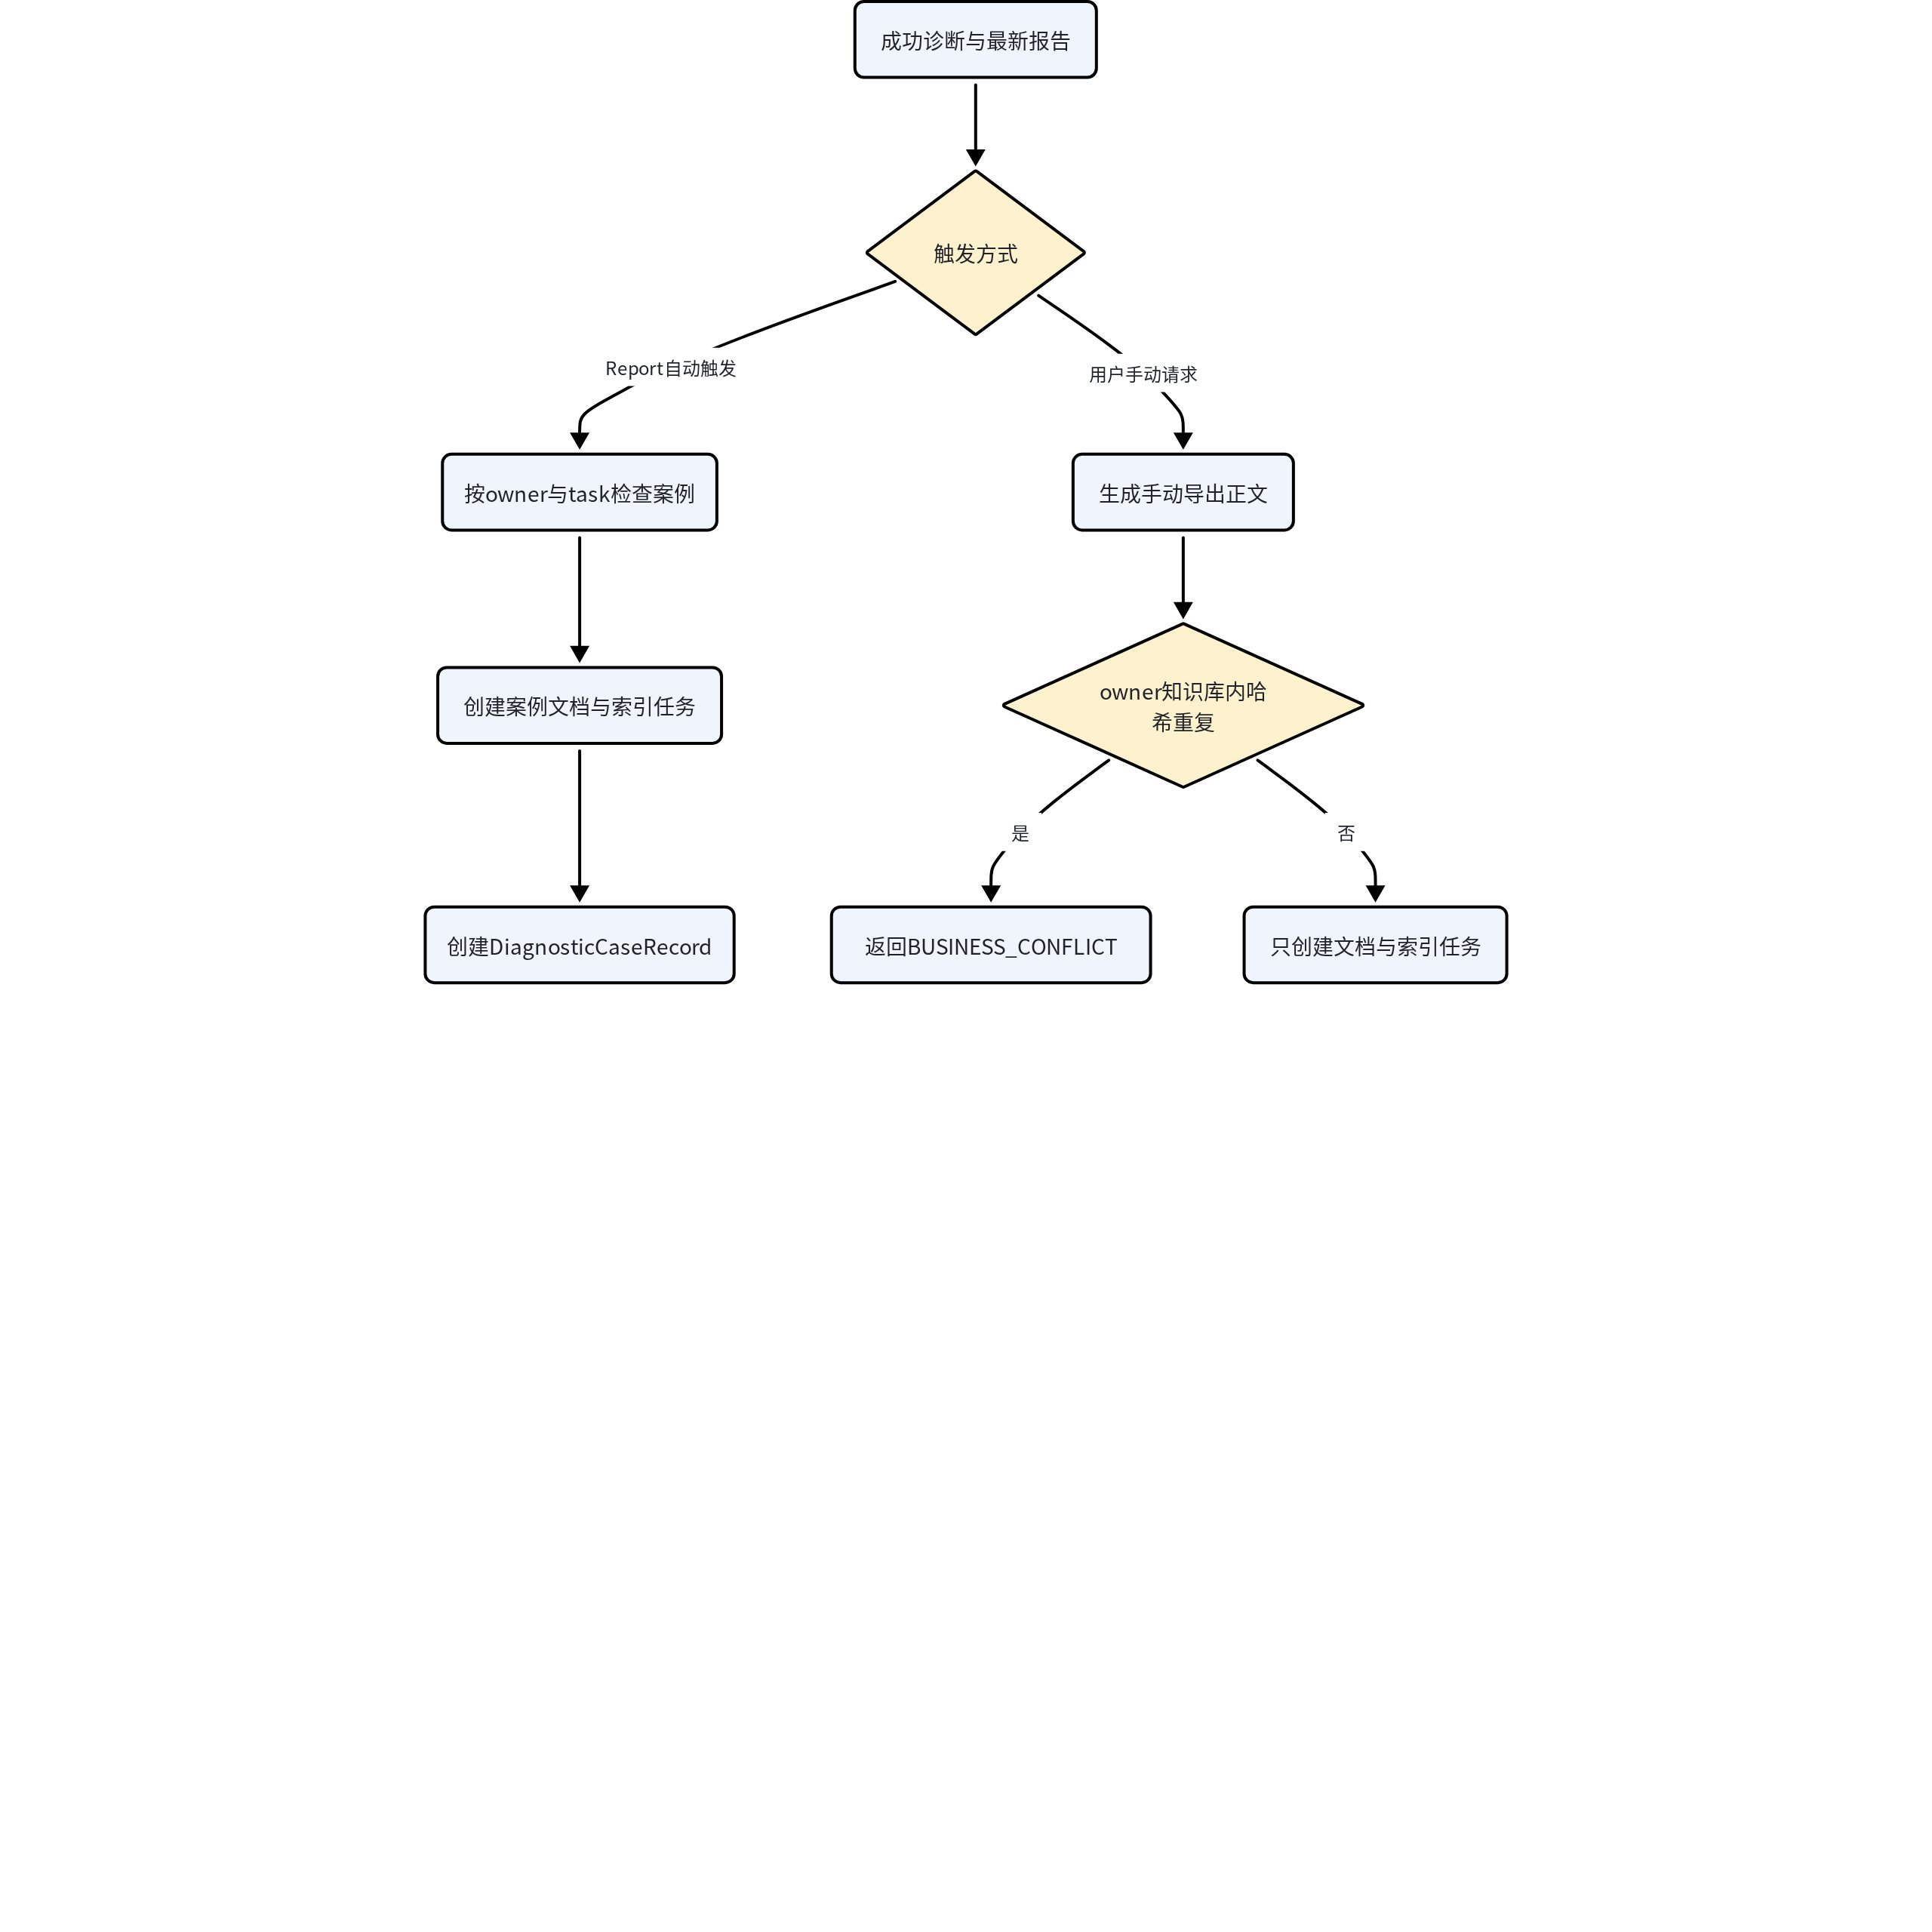
这张图证明两条路径可以同时围绕同一诊断产生不同知识文档语义,且手动路径不会补建结构化案例。查看问题时应以触发入口、幂等键和实际关联 ID 为准,不能用“都进知识库”推断它们是同一次写入。
数据、契约与状态
AiopsDiagnosticCase 共享契约向前端提供 taskId、reportId、documentId、indexTaskId 和结构化摘要字段。AiopsCaseLibrary.vue 用这些字段展示告警、服务、关键词和摘要;点击案例回到原诊断,点击文档入口跳转知识库页面。页面展示的案例来自 GET /aiops/diagnostic-cases,按当前用户和创建时间倒序查询。
生成文档进入标准文档状态机。创建时会有 document metadata 和待执行的 index task;索引服务再更新排队、执行、成功或失败状态。案例记录保存 indexTaskId,但当前案例列表契约没有直接展开索引任务最新状态,需要通过关联文档或索引 API 检查。不能仅凭案例存在就推断索引成功。
📷 [图片 token=FTjtbkhZMoL9Frx8zoRcQErtnPc(未能下载,见飞书原文)]
索引成功后,_vector_chunk_record 将 knowledgeType、owner、tenant、knowledge base、document 和 chunk ID 写入 metadata。KnowledgeRetrievalCitationSource 再把分类和完整排名阶段输出到 citation。前端 ChatCitationDetail.vue 把 diagnostic-case 显示为“故障案例”,读者可以区分它来自历史案例而不是 SOP 或普通文档。
📷 [图片 token=DNh1b5RQPommkexCzlhcWxWAnPd(未能下载,见飞书原文)]
权限、安全与失败边界
自动沉淀沿用诊断任务 owner。文档目标知识库 ID 为 kb_{owner_user_id},案例、文档、索引任务和 evidence 查询都携带相同 owner。repository 写入案例时还验证 report、index task 和 document 的父子关系;跨 tenant 拼接会抛出 TenantScopeError。列表和详情接口也只按当前用户查询,其他用户得到统一权限错误。
📷 [图片 token=SZS4bS4DAo7NRJxj9KMcPBXNnfc(未能下载,见飞书原文)]
Milvus 只保存知识 chunk 向量和用于过滤、追踪的标量/metadata,不保存案例表的完整业务关系。结构化案例、文档元数据和索引状态仍以 SQLite 为主。检索时必须同时传入 tenant ID 与授权知识库集合;授权集合为空则直接返回空结果,不能退化为无范围检索。
📷 [图片 token=C1JZbiNcUohTEix9A4Gcxc74nFg(未能下载,见飞书原文)]
案例复用也不是自动“照抄历史根因”。Planner 只是把检索结果作为 SOP/历史证据的一部分,Executor 仍需调用真实工具验证当前事故。历史案例可以提供排查方向,但不能证明当前告警具有相同根因,更不能把过去的处置结果写成当前已经执行成功。
📷 [图片 token=OWzIb2Ay5oQrHBxIjCFcNLkQnrh(未能下载,见飞书原文)]
阅读顺序与小结
先从
AiopsDiagnosticService._report找到成功门槛和自动触发点。完整阅读
apps/backend/src/super_ai/aiops/cases.py,理解结构化字段、正文和幂等规则。沿
SQLiteDiagnosticMemoryRepository.create_case检查关联资源和 owner 校验。再进入文档索引与检索工具,确认案例怎样变成可追溯 citation。
最后比较自动案例与手动保存接口,避免把两条路径混为一谈。
案例沉淀的价值不在于数量,而在于它能否保留“哪次任务、哪份报告、哪些证据、哪篇文档、哪次索引”的完整来源。OncallAgent 通过结构化案例和普通知识索引把诊断结果接回 RAG,但后续诊断仍要重新取证;历史经验提供方向,真实工具决定当前事实。