OncallAgent 的 AIOps 诊断不是把一条告警直接交给大模型,然后把生成文字当成根因。真实链路先读取外部活跃告警,再检索当前用户有权访问的知识文档,随后调用真实工具取证,并把步骤、工具审计、证据、checkpoint 和报告分别持久化。检索结果可能来自 SOP、诊断案例或普通知识文档;报告提示词要求只总结已有事实,并在证据不足时明确表达不确定性。当前结构校验并不能从语义上证明每句话都由证据支撑,阅读报告时仍要回看证据链接。
这条链路由 FastAPI、SQLite durable job、LangGraph、RAG、MCP 和 SSE 共同完成。理解它时不要只盯着 Planner → Executor → Replanner → Report 四个节点名称,而要继续追问:输入从哪里来,工具是否真实调用,哪些记录进入 SQLite,报告和证据如何关联,浏览器断开后任务是否继续,以及失败怎样被用户看到。
📷 [图片 token=YFiEbWDmfo56qGxattQcJcvTnye(未能下载,见飞书原文)]
学习目标
掌握从活跃告警到诊断任务、后台执行、证据报告和案例沉淀的完整调用链。
理解 LangGraph 四个节点在当前实现中的真实职责和边界。
区分实时 SSE 事件、持久化步骤、工具审计、证据记录与最终报告。
能够从代码判断一个根因结论是否有知识引用或真实工具结果支撑。
功能入口与完整调用链
活跃告警入口由 GET /aiops/alerts/active 提供。apps/backend/src/super_ai/alerts.py 可以读取 Alertmanager v2 或 Prometheus v1 API,只保留 active 或 firing 状态,并规范化为名称、服务、级别、开始时间、摘要和来源上下文。多个数据源中只要有一个成功,就返回成功源的真实告警;全部失败才返回统一的服务不可用错误。
📷 [图片 token=As70bI2tOocbBPxwvr2c367qn8e(未能下载,见飞书原文)]
前端 apps/frontend/src/stores/aiops.ts 的 diagnoseAlert 把规范化告警转为诊断查询,同时保留 alertSource、alertName、service、severity、status、startsAt 和原始 context。POST /aiops/diagnostics 先创建 owner-scoped 诊断任务,再入队一个 aiops_diagnosis 后台任务并返回 202。真正的 LangGraph 执行发生在后台 worker,不占住创建请求。
📷 [图片 token=UOnpbAOMFoQtotxfmzYcV9p9n3g(未能下载,见飞书原文)]
浏览器随后订阅 POST /aiops/diagnostics/{diagnostic_id}:stream。这个端点不是直接调用图,而是持续读取持久化的 background job events 并编码为 SSE。即使页面刷新或网络断开,worker 仍可继续;重新打开任务时,前端再通过 /evidence-chain 读取已经落库的步骤、审计、证据、报告、链接和 checkpoint。
📷 [图片 token=FKTMbnCLmowq8wxIWxXcK9WGnhb(未能下载,见飞书原文)]
外部 Alertmanager / Prometheus
  → GET /aiops/alerts/active
  → 规范化活跃告警并保留来源 context
  → POST /aiops/diagnostics
  → SQLite diagnostic task + background job
  → Planner:tenant 知识检索 + MCP 工具发现 + 有界计划
  → Executor:真实 knowledge_retrieval 或 MCP 调用
  → Replanner:根据计划位置和失败状态决定继续或转 Report
  → Report:证据约束的 Markdown 报告 + fallback
  → SQLite steps / audits / evidence / checkpoints / report links
  → 持久事件 SSE + evidence-chain 回读
  → 成功时自动生成诊断案例并安排普通文档索引
核心源码地图
| 源码位置 | 关键符号 | 职责 |
|---|---|---|
apps/backend/src/super_ai/alerts.py | AggregatedAlertProvider、_normalize_alert | 读取真实 Prometheus/Alertmanager API,过滤并规范化活跃告警,保留来源上下文。 |
apps/backend/src/super_ai/api/app.py | create_aiops_diagnostic、stream_aiops_diagnostic | 创建 owner-scoped 任务和后台 job,并从持久事件提供 SSE 订阅。 |
apps/backend/src/super_ai/aiops/diagnostics.py | AiopsDiagnosticService | 构建并运行 LangGraph,组织知识引用、工具证据、报告和案例触发。 |
apps/backend/src/super_ai/retrieval/tool.py | KnowledgeRetrievalTool | 在当前用户和授权知识库范围内检索已索引文档,返回结果和可追溯引用。 |
apps/backend/src/super_ai/mcp_connections.py | McpConnectionService.client_for_user | 为当前诊断 owner 装配已启用 MCP 连接。 |
apps/backend/src/super_ai/mcp_client.py | LocalMcpClient.call_tool | 调用真实 MCP 工具,执行超时、重试和明确失败。 |
apps/backend/src/super_ai/memory/repositories.py | DiagnosticMemoryRepository | 定义任务、步骤、证据、报告、链接、案例与 checkpoint 的持久化边界。 |
packages/api-contracts/src/protected-data.ts | AiopsDiagnosticEvidenceChain | 定义前端读取的完整诊断证据链结构。 |
packages/api-contracts/src/sse.ts | SseEvent | 定义任务状态、工具调用、引用、报告、完成和错误等判别事件。 |
apps/frontend/src/stores/aiops.ts | useAiopsStore | 串联告警、创建任务、消费 SSE、回载证据链和案例列表。 |
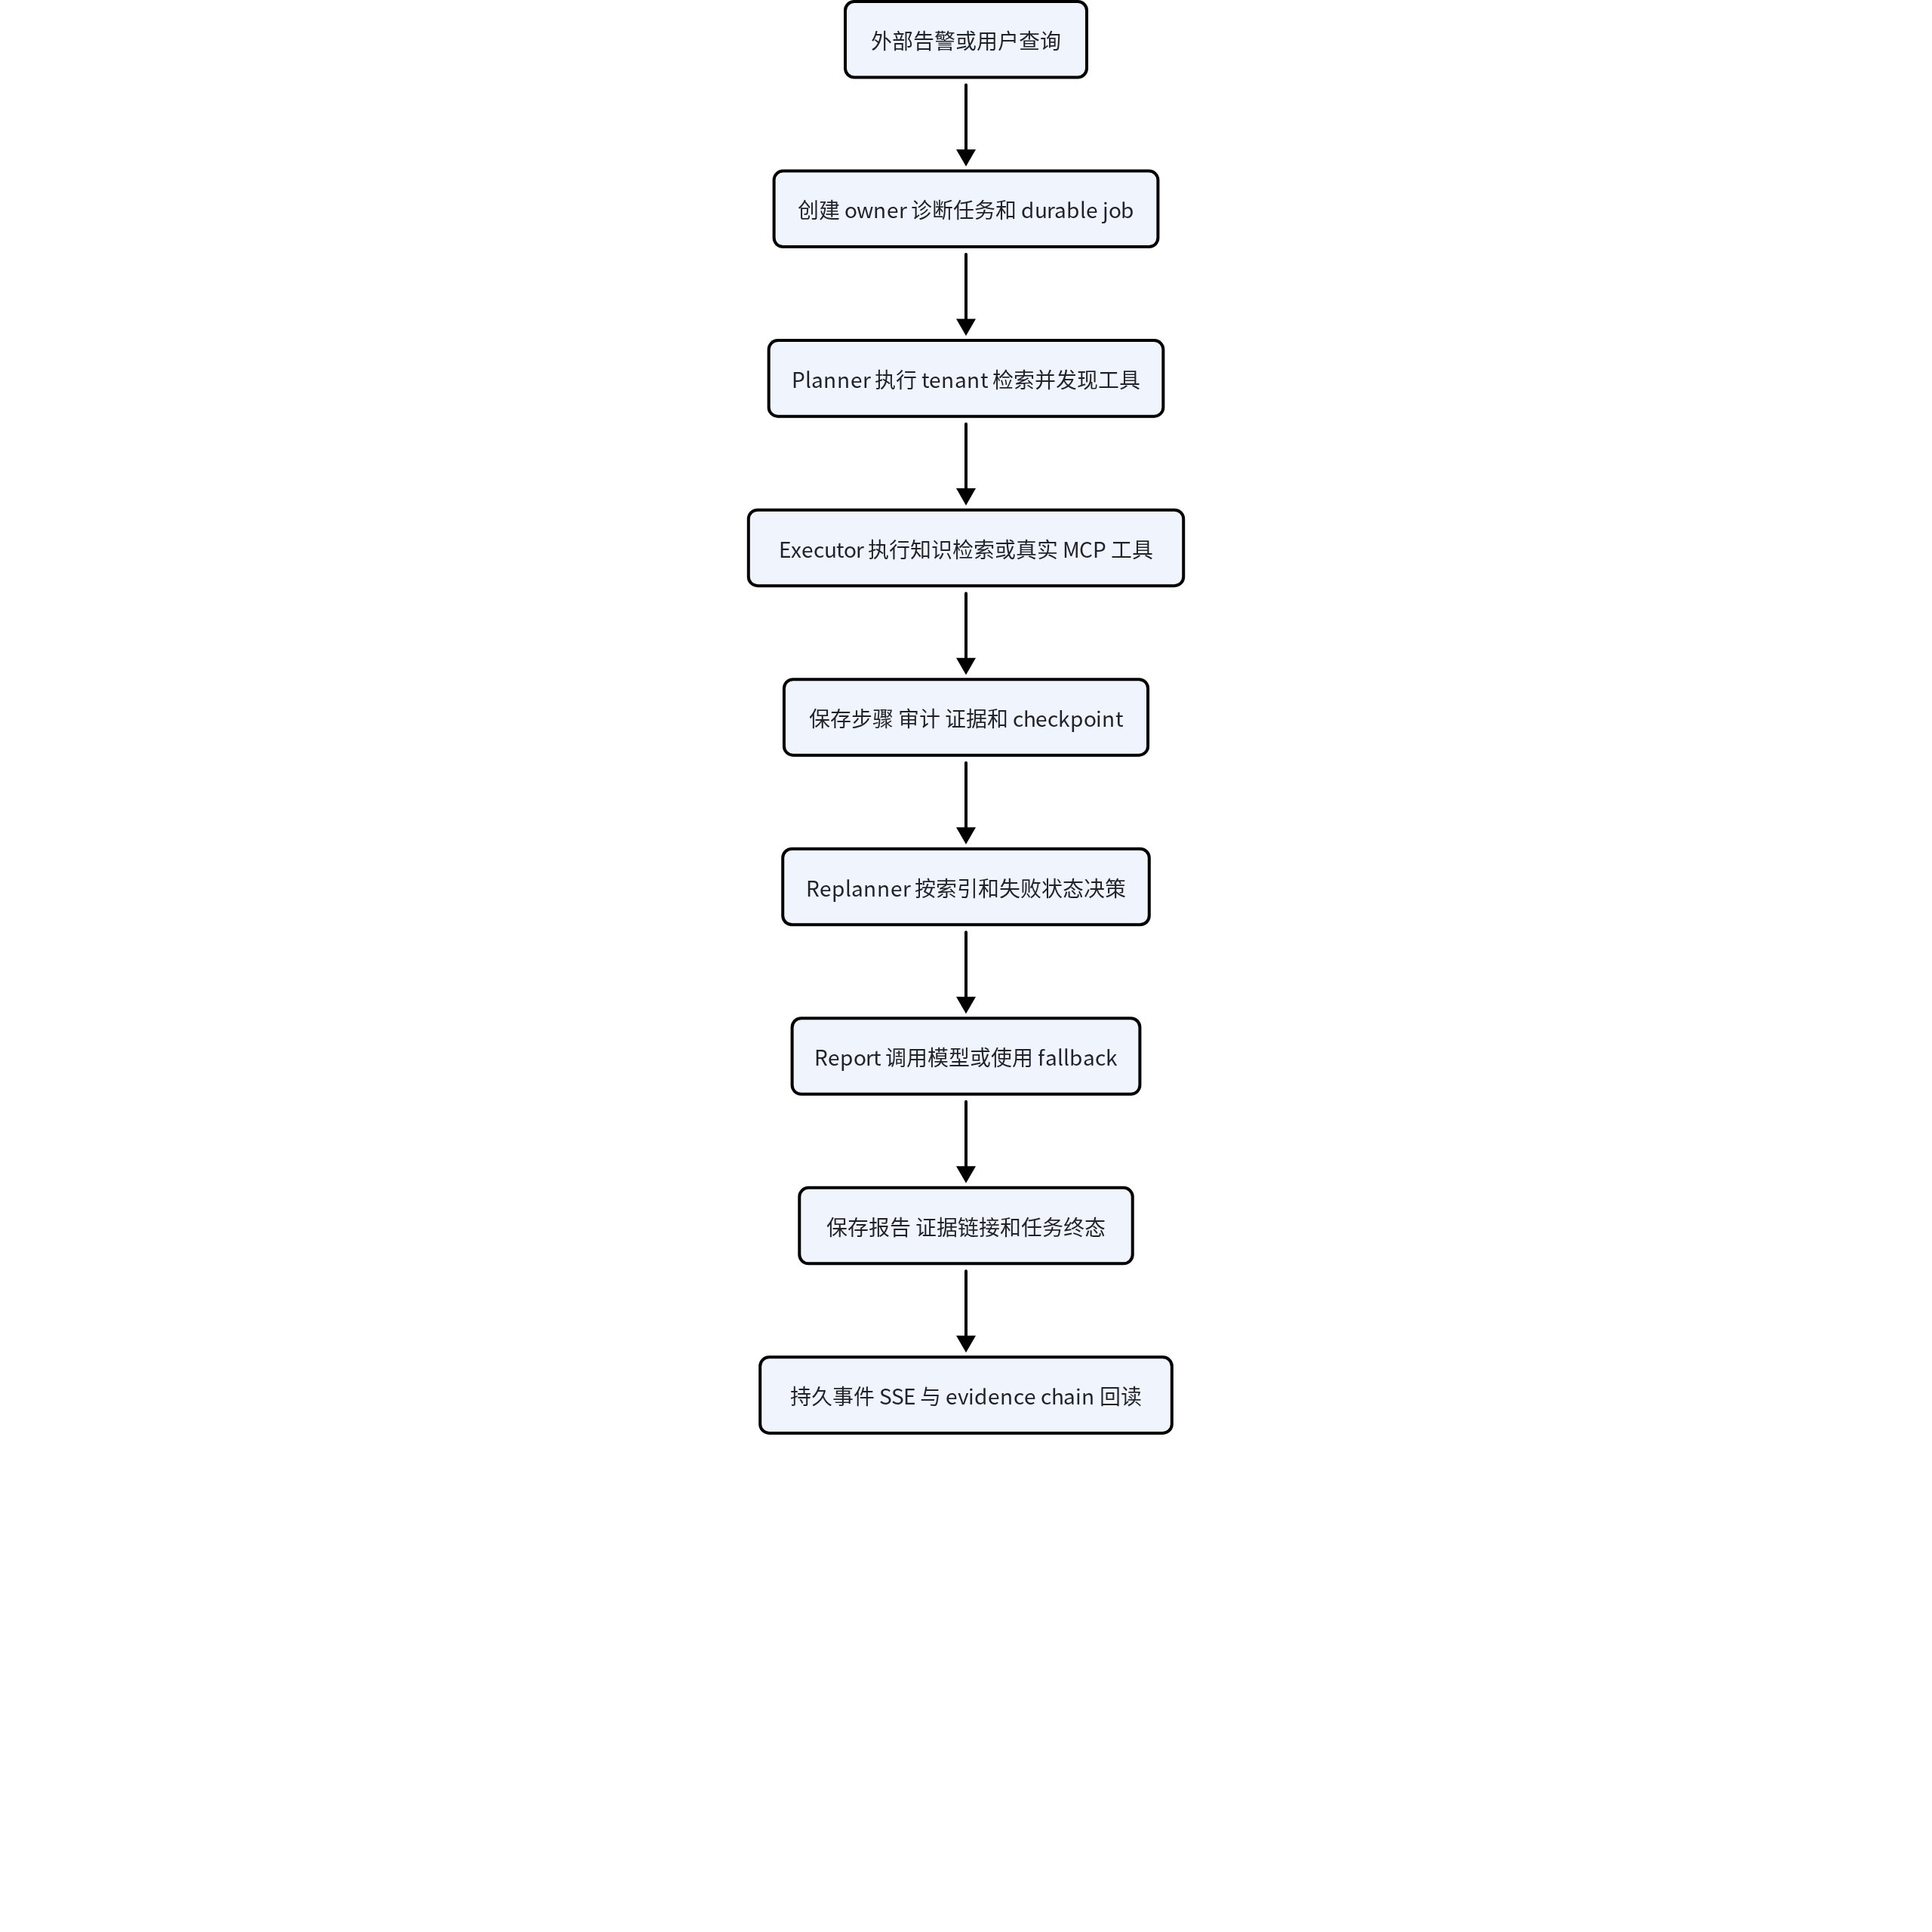
代码调用流程图
诊断链路把规划、真实执行、状态判断和报告拆成四个节点,并把每一步产生的事件、审计、证据和 checkpoint 保存下来。
📷 [图片 token=LLp3b6cxVouM24xk6eSc7ONOnmh(未能下载,见飞书原文)]
关键实现拆解
Planner 先检索授权知识,再规划真实工具步骤
AiopsDiagnosticService.stream 首先把任务状态改为 running。如果输入包含告警,它会创建一条 kind=alert 的证据,保留原始输入。随后 _planner 以当前用户 ID 和 accessible_knowledge_base_ids 调用 KnowledgeRetrievalTool,查询 top 3 结果;该调用本身也创建 knowledge_retrieval 工具审计。
📷 [图片 token=IQ0ZbccgfoltPsxHXZecV3LznjS(未能下载,见飞书原文)]
看什么:Planner 的首个真实动作不是问模型,而是创建审计并在 owner 与授权知识库集合内调用检索工具。调用参数里没有扩大范围的默认知识库。
        await self._create_audit(
            owner_user_id=owner_user_id,
            task_id=task_id,
            audit_id=retrieval_audit_id,
            tool_name="knowledge_retrieval",
            arguments={"query": query},
        )

        retrieval_result: KnowledgeRetrievalToolResult | None = None
        retrieval_error: str | None = None
        try:
            # 1. query 与 top_k 不能替代 owner 和授权知识库边界。
            retrieval_result = await self._retrieval_tool.run(
                KnowledgeRetrievalToolInput(query=query, top_k=3),
                owner_user_id=owner_user_id,
                accessible_knowledge_base_ids=cast(
                    Sequence[str], state["accessible_knowledge_base_ids"]
                ),
            )
        except KnowledgeRetrievalError as exc:
            # 2. 检索失败进入显式失败状态,不伪造命中。
            retrieval_error = exc.message
这段代码证明 tenant 范围是检索调用的必需输入,而不是报告阶段的事后过滤。失败边界也很明确:检索异常被记录为 retrieval_error,后续仍可生成受限计划和失败说明,但不能把空结果改写成一条示例 SOP。
检索成功时,Planner 记录知识命中、引用事件和 knowledge_reference 证据;无命中时设置 no_sop_matched,后续报告必须说明使用通用计划;检索失败则保存安全错误,并发出规范化错误事件。这里的 sop_hits 与 no_sop_matched 是当前内部字段名,但调用只传入 query 和 topK,并没有附加 knowledgeType=sop 过滤条件,因此这些字段可能承载 SOP、案例或普通知识文档。之后 Planner 从当前用户 MCP 客户端发现真实工具名,并把这些名称作为模型规划的白名单。
📷 [图片 token=HzXCbCy7fo6Xk4xK7cWcVFQinac(未能下载,见飞书原文)]
当前实现对模型规划做了较强约束。_validated_plan 只接受发现到的工具或 knowledge_retrieval;_create_plan 最终只保留一个 SearchLog 步骤;_normalized_search_log_step 使用项目配置的 CLS region、topic 和最近 24 小时时间窗,只允许模型在 1 到 100 之间调整 Limit。若模型响应无效或没有可执行的 SearchLog,系统回退到同样受限的通用日志查询,而不是执行模型任意生成的工具名和参数。
📷 [图片 token=XheYbWOeqoqxD8xp3Snc6rvHnJd(未能下载,见飞书原文)]
看什么:模型输出先通过“已发现工具”白名单,随后 _create_plan 又只选择第一条 SearchLog;没有可用步骤时返回本地构造的通用计划。
        generic_plan = [self._generic_search_log_step(query)]
        # … 省略 prompt 拼接
        try:
            response = await self._llm_provider.create_chat_model().ainvoke(prompt)
            # 1. 模型步骤先受真实发现工具名白名单约束。
            plan = _validated_plan(_model_text(response), available_tools)
        except Exception:
            plan = []
        search_log_steps = [step for step in plan if step.get("tool") == "SearchLog"]
        if not search_log_steps:
            # 2. 无合法 SearchLog 时使用确定性的通用步骤。
            return generic_plan, "generic"
        return [self._normalized_search_log_step(search_log_steps[0], query)], (
            "SOP-backed" if sop_hits else "generic"
        )
它证明当前 Planner 并不是开放式多工具计划器:即使白名单允许其他真实工具,最终执行计划仍被收窄为一个 SearchLog。模型不可用、JSON 无效或缺少该工具时都会回退,不会把模型原始参数直接交给 MCP。
看什么:再看参数归一化。项目侧生成 region、topic、24 小时时间窗与查询表达式,模型只可能改变合法范围内的 Limit。
        """Keep model planning bounded to an executable real CLS search step."""
        generic_step = self._generic_search_log_step(query)
        model_arguments = _json_dict(step.get("arguments"))
        limit_value = model_arguments.get("Limit")
        arguments = _json_dict(generic_step["arguments"])
        # 1. 只有 1 到 100 的整数 Limit 能覆盖本地参数。
        if isinstance(limit_value, int) and 1 <= limit_value <= 100:
            arguments["Limit"] = limit_value
        return {
            "id": str(step.get("id") or generic_step["id"]),
            "tool": "SearchLog",
            # 2. 其余 arguments 始终来自 generic_step。
            "arguments": arguments,
            "purpose": str(step.get("purpose") or generic_step["purpose"]),
        }
这段代码证明模型不能改写 CLS region、topic、时间窗或 Query。边界是:当前实现固定查询最近 24 小时且 Query 为本地通用值,这提高了可执行性,却也意味着文档不能声称模型已能根据 SOP 自由组合任意诊断参数。
看什么:下面的局部流程图把“知识检索结果”和“工具发现结果”如何共同进入受限计划画开,避免误读成一次模型调用同时完成检索和执行。
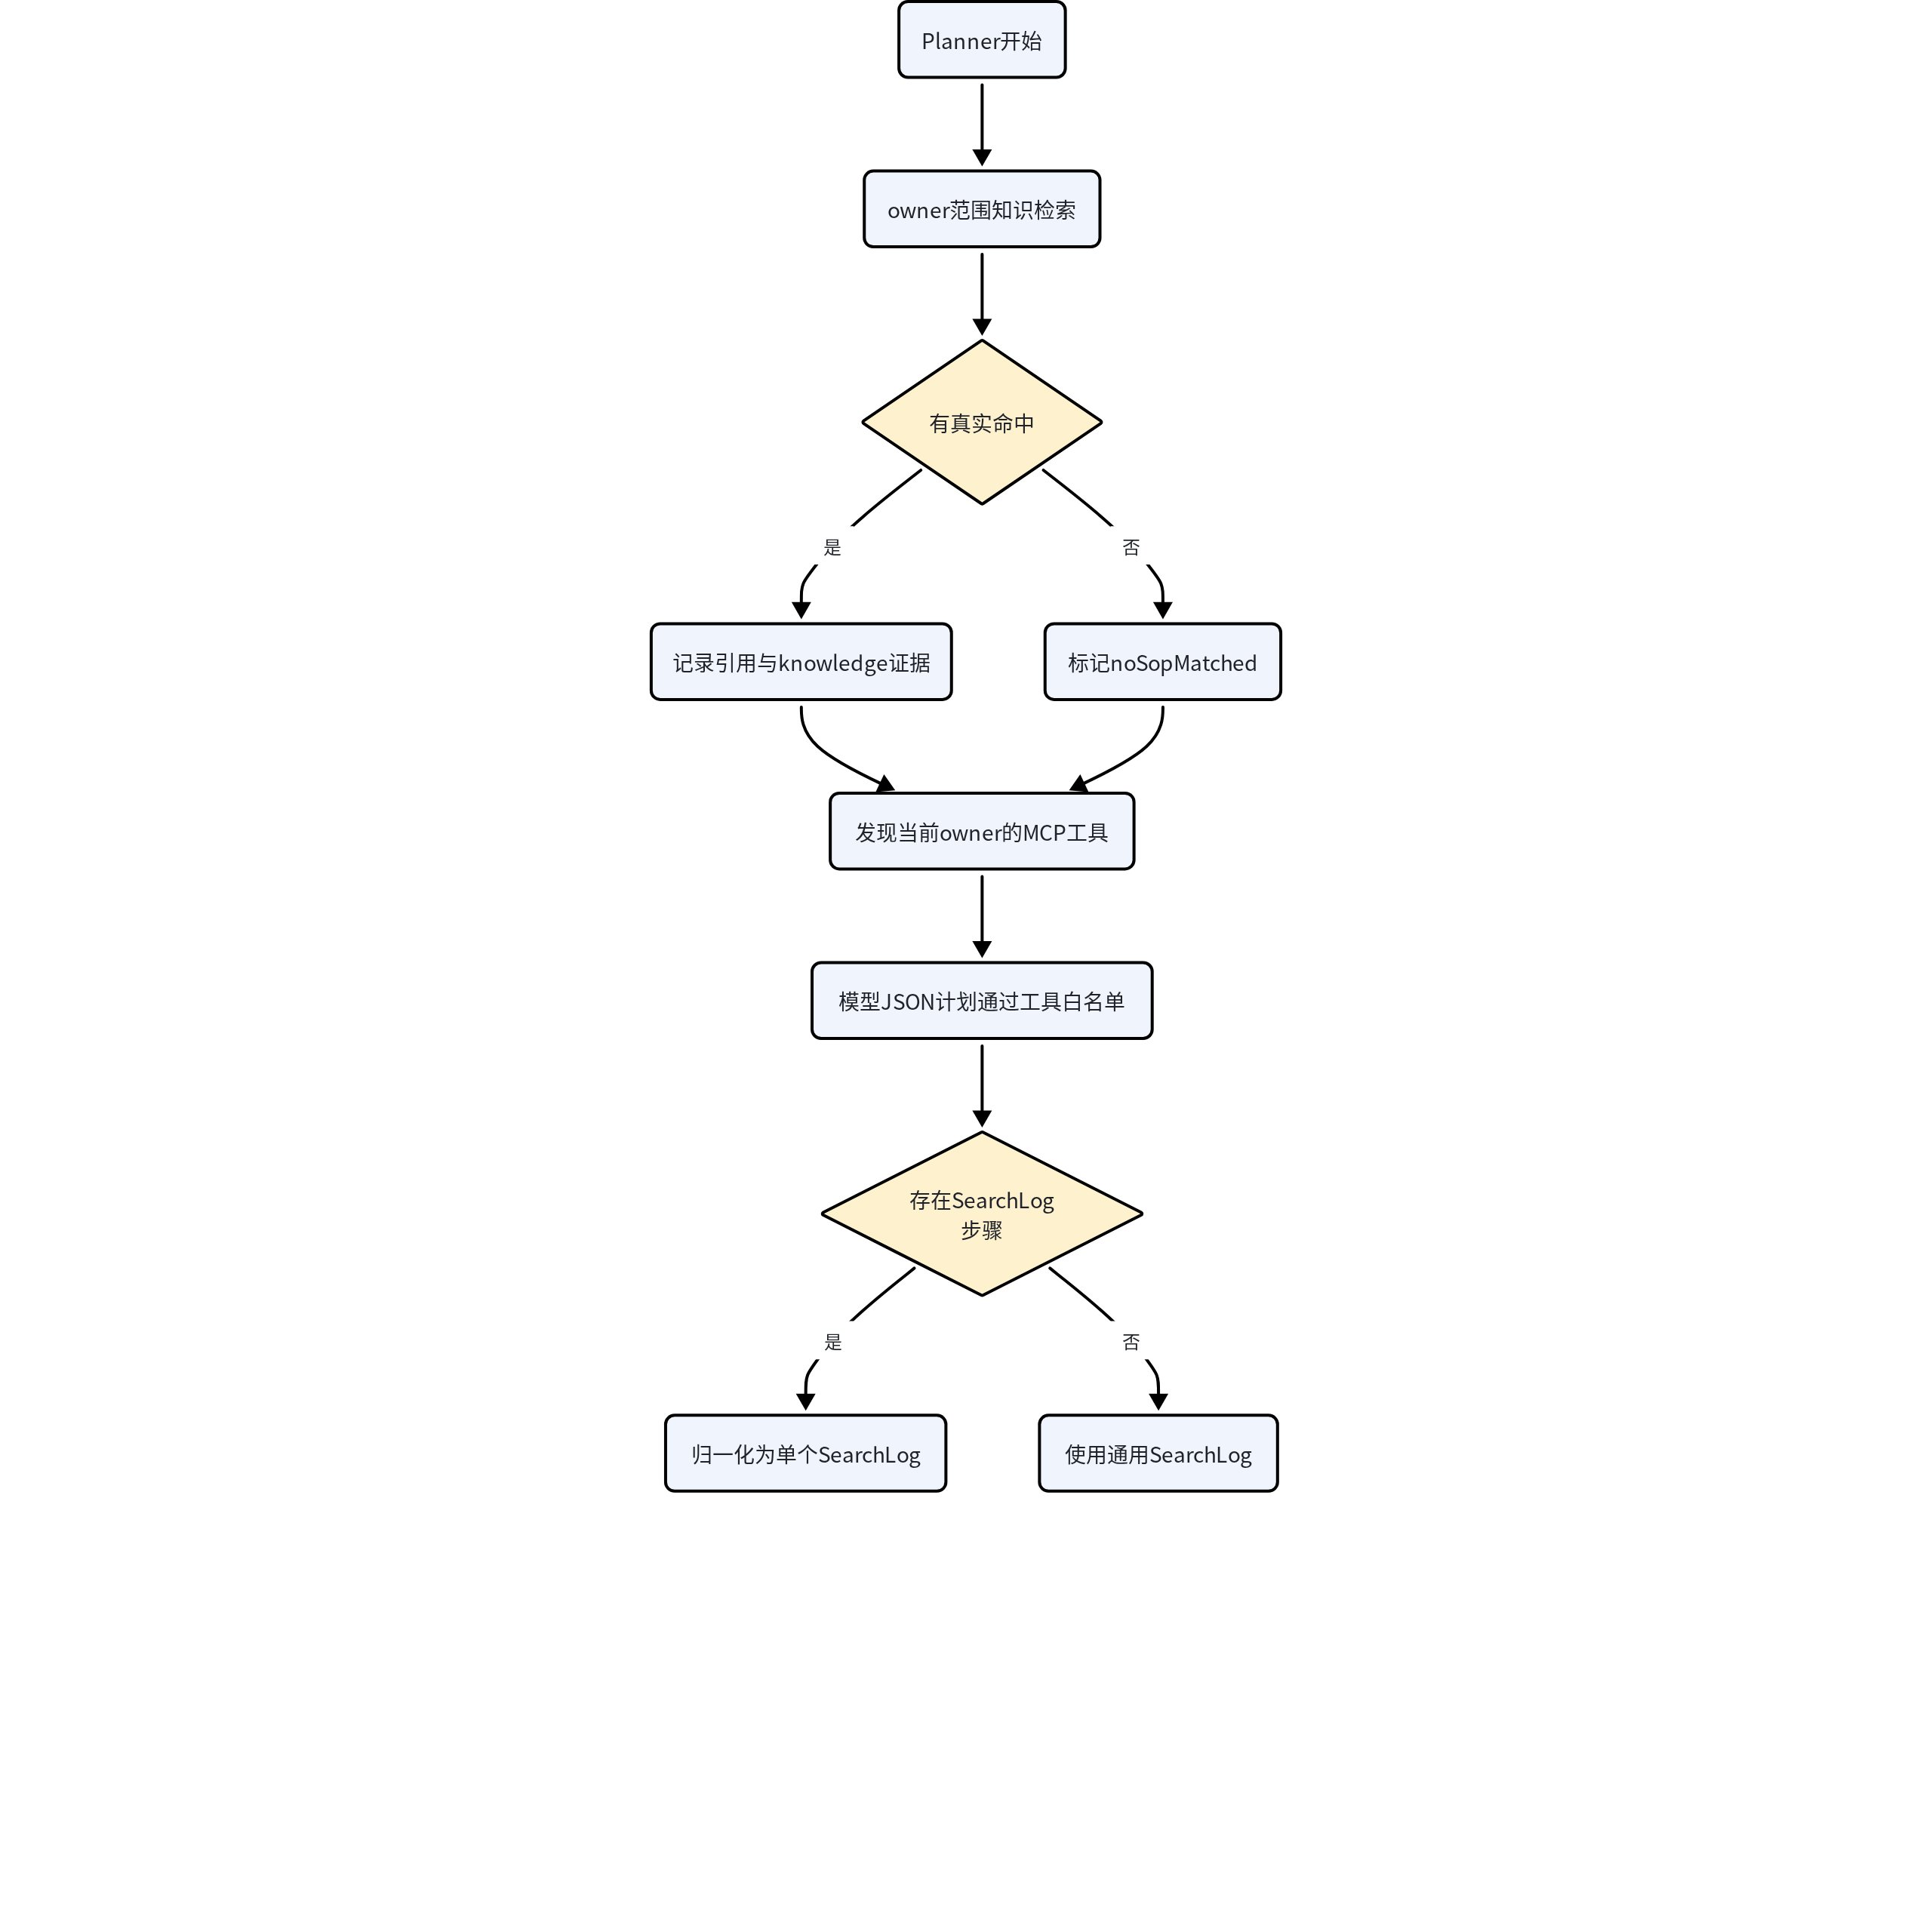
这张图证明 SOP 命中影响 planOrigin 与报告语义,但不会绕过真实工具发现或参数归一化。检索失败、无命中、发现失败和模型失败都有独立落点,任何一个都不能制造不存在的证据。
📷 [图片 token=QbLXbVrspo1n1yxZNHZcCvMOnxg(未能下载,见飞书原文)]
Executor 将工具结果转换成证据,而不是直接变成结论
_executor 读取当前计划步骤,先发出 tool.call started,并在 SQLite 创建状态为 started 的审计。知识检索步骤继续走 tenant 过滤的 KnowledgeRetrievalTool;其他非空工具名通过当前用户的 LocalMcpClient.call_tool 执行。成功结果会产生完成事件、结果摘要、executor step、带工具关联的 evidence 记录和 checkpoint。
📷 [图片 token=KveEbd2rYoTqSwxx3QxcWUkmnwg(未能下载,见飞书原文)]
看什么:Executor 保留两条不同的执行边界——知识检索必须再次携带 tenant 参数,其他工具则从当前 owner 的 MCP provider 取得客户端后真实调用。
        try:
            if tool_name == "knowledge_retrieval":
                result = await self._retrieval_tool.run(
                    KnowledgeRetrievalToolInput(
                        query=str(arguments.get("query") or state["query"]),
                        top_k=_optional_int(arguments.get("topK")),
                    ),
                    # 1. 诊断内的再次检索仍显式携带 owner 与授权知识库。
                    owner_user_id=owner_user_id,
                    accessible_knowledge_base_ids=cast(
                        Sequence[str], state["accessible_knowledge_base_ids"]
                    ),
                )
                output: object = {
                    "results": [_sop_hit_payload(hit) for hit in result.results],
                    "citations": [_citation_payload(citation) for citation in result.citations],
                }
            elif tool_name:
                # 2. MCP 客户端同样按当前诊断 owner 装配。
                mcp_client = await self._mcp_client_for(owner_user_id)
                output = await mcp_client.call_tool(tool_name, arguments)
            else:
                raise ValueError("Diagnostic plan did not specify a tool.")
它证明 Executor 不会从全局工具池执行计划,也不会因为计划里出现 knowledge_retrieval 就跳过知识库授权。失败或空工具名进入异常分支,不能被转换为 completed 证据。
SearchLog 的摘要并不是把 MCP 原始返回全文无限保存。_search_log_records 只解析可识别的日志列表,并抽取 timestamp、level、service、host、event、message、latency、exception 和 request ID 等有限字段;_tool_result_summary 最多保留十条记录。若没有可解析日志,它明确记录“CLS 未返回可解析日志”,不会创造一条示例异常。
看什么:摘要函数只为 SearchLog 进入字段级解析,返回记录最多取前十条;其他工具仍走长度受限的 JSON 编码。
def _tool_result_summary(tool_name: str, output: object) -> str:
    if tool_name != "SearchLog":
        return _bounded_json(output)
    records = _search_log_records(output)
    if not records:
        # 1. 无法解析时保存明确的零记录事实。
        return json.dumps(
            {"recordCount": 0, "records": [], "message": "CLS 未返回可解析日志。"},
            ensure_ascii=False,
            separators=(",", ":"),
        )
    # 2. 审计与证据摘要最多保留十条结构化记录。
    return json.dumps(
        {"recordCount": len(records), "records": records[:10]},
        ensure_ascii=False,
        separators=(",", ":"),
    )
这段代码证明“没有可解析日志”与“工具调用失败”是不同事实:前者可形成 completed 的零记录摘要,后者进入 failed 分支。它也说明十条是摘要上限而非 MCP 查询上限,原始工具 payload 与摘要的保留范围不同。
📷 [图片 token=MjjUbrvchot8TzxkirQcZl3YnZk(未能下载,见飞书原文)]
调用抛错时,Executor 通过 _safe_error 清理常见凭据格式,完成失败审计,创建失败步骤和失败 evidence,并把 execution_failed 设为真。工具失败之后仍会进入 Report,目的是输出一份说明失败和证据缺口的报告,而不是让界面停在无解释的空白状态。
📷 [图片 token=U8AubzL6go0Tiyxh27Gc1e2Tnyd(未能下载,见飞书原文)]
看什么:失败分支同时写四类事实——失败 SSE、审计终态、executor step 与 evidence;返回状态中的 execution_failed=True 决定后续 Replanner 不再继续。
        except Exception as exc:
            safe_error = _safe_error(exc)
            evidence: JsonDict = {
                "stepId": str(step.get("id") or f"step_{plan_index + 1}"),
                "tool": tool_name or "unknown",
                "status": "failed",
                "summary": safe_error,
            }
            # … 省略失败事件和审计 finalize
            executor_step = await self._create_step(
                owner_user_id=owner_user_id,
                task_id=task_id,
                phase="executor",
                status="failed",
                payload={"planStep": step, "tool": tool_name, "error": safe_error},
            )
            # … 省略同 owner/task 的失败 evidence 创建
            # 1. 失败仍推进索引,但设置终止后续执行的状态。
            return {
                "plan_index": plan_index + 1,
                "execution_failed": True,
                "evidence": [evidence],
                "evidence_ids": [evidence_record.id],
                "events": events,
            }
它证明失败不是静默丢弃,也不会被包装成成功结果。安全边界是 _safe_error 只清理当前规则识别的常见 key 形式并截断到 500 字符;调用方仍不应把凭据放进异常文本。
看什么:下面的时序图强调工具输出先转为审计、步骤和 evidence,Report 最后才消费这些来源;这正是“证据不等于结论”的代码结构。
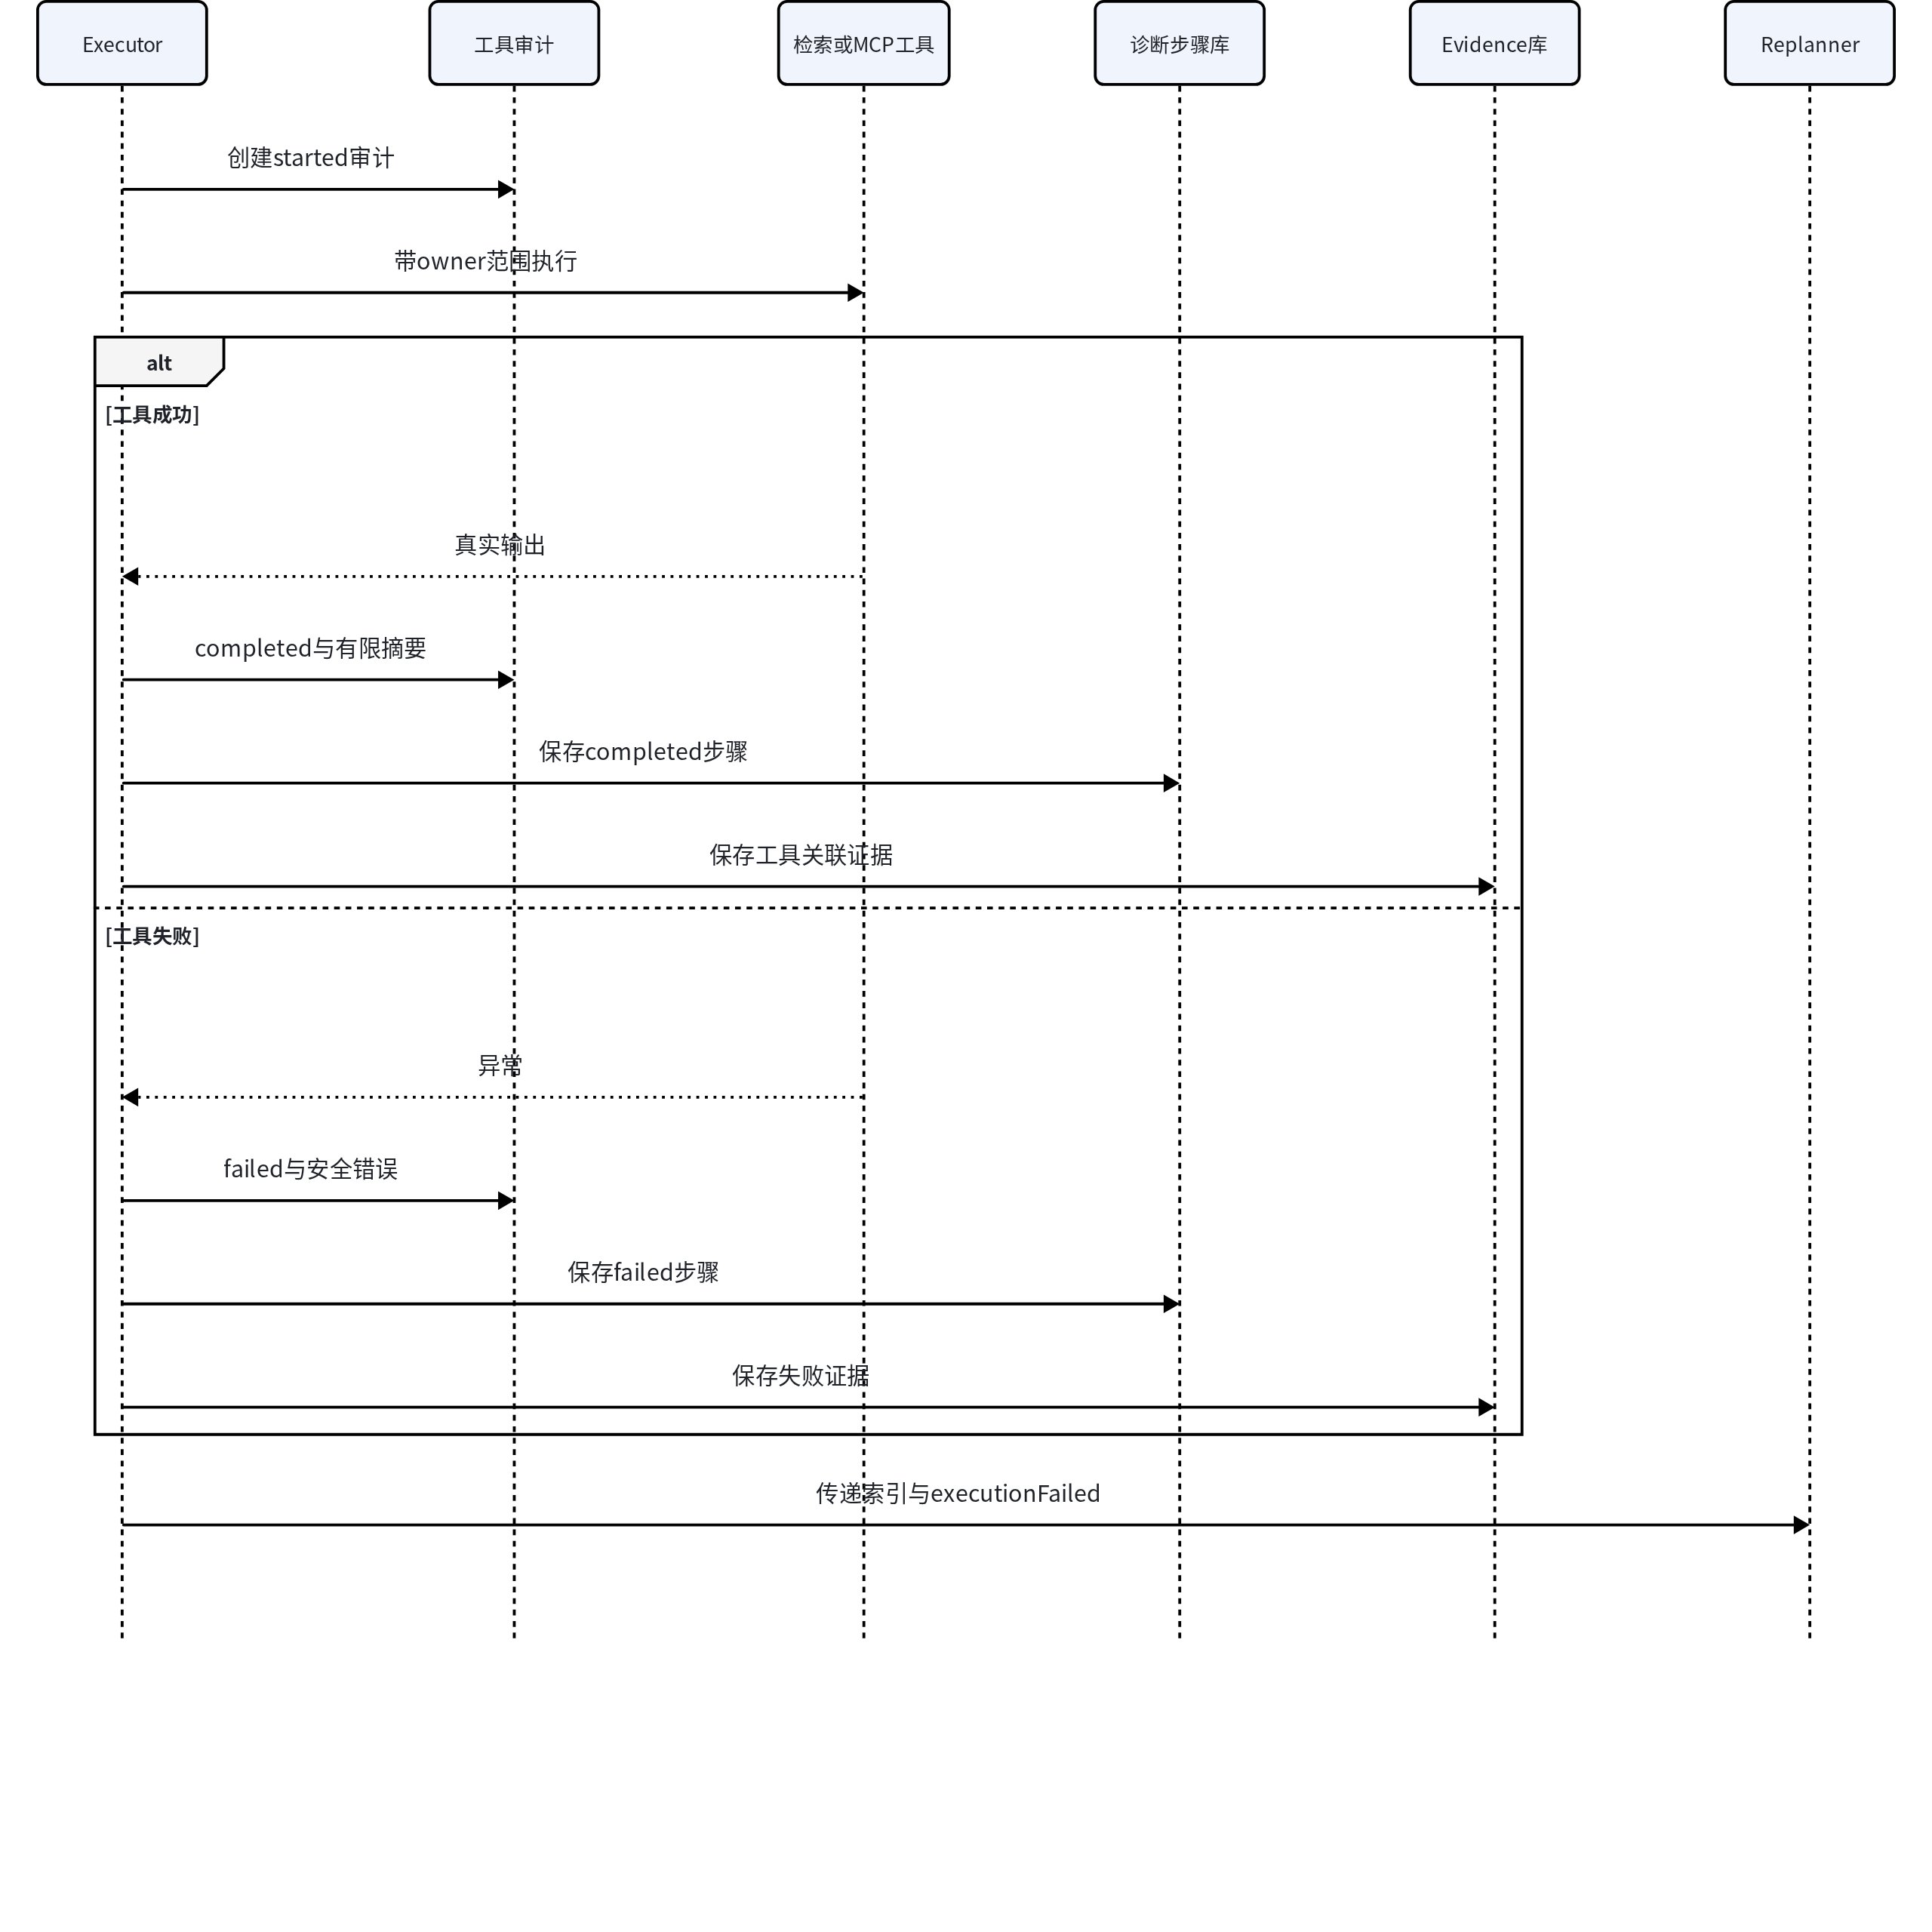
这张图证明报告之前存在可独立查询的持久化执行轨迹。若某次写入本身异常,图节点可能整体失败并由外层任务处理;文档不能假设 SSE、审计、步骤和 evidence 在任意基础设施故障下仍必然同时成功。
📷 [图片 token=UkwvbudSKo5f7Wx84R1cvmDGnXe(未能下载,见飞书原文)]
Replanner 和 Report 的实际边界
当前 _replanner 并不会重新调用模型生成一份新计划。它根据 plan_index、计划长度和 execution_failed 判断是否继续下一个既有步骤;存在失败或步骤执行完毕时转入 Report。由于当前计划又被归一化为单个 SearchLog,常见路径是执行一次真实日志查询后进入报告。阅读文档时必须以这段现有代码为准,不能把它描述成已经实现任意多轮动态改写计划。
📷 [图片 token=XiWdbscwYoqb30xsR5JcyG9dnAg(未能下载,见飞书原文)]
看什么:Replanner 只有一个布尔判断;它保存决策步骤与 checkpoint,但代码中没有第二次 ainvoke 或计划内容更新。
        plan = cast(list[JsonDict], state.get("plan") or [])
        plan_index = int(state.get("plan_index") or 0)
        execution_failed = bool(state.get("execution_failed"))
        # 1. 仅当还有既有步骤且此前未失败时继续。
        continue_execution = plan_index < len(plan) and not execution_failed
        decision = (
            "continuing with the next bounded step" if continue_execution else "moving to Report"
        )
        # … 省略 task.status 事件
        await self._create_step(
            owner_user_id=str(state["owner_user_id"]),
            task_id=task_id,
            phase="replanner",
            status="completed",
            payload={
                "planIndex": plan_index,
                "planLength": len(plan),
                "executionFailed": execution_failed,
                # 2. 决策只在 executor 与 report 之间选择。
                "decision": "executor" if continue_execution else "report",
            },
        )
它证明“Replan”在当前实现中是对既有有界计划的路由判断,而不是动态生成新步骤。失败边界也很保守:一旦 execution_failed 为真,即使计划中仍有步骤,也会直接进入 Report。
_report 先构造确定性的 fallback,再请求配置的聊天模型生成规定结构的中文 Markdown。_report_prompt 明确禁止编造告警、日志、根因和执行结果;缺失字段要写“未获取”,证据不足要写“证据不足,无法确认根因”。_clean_markdown_report 还会拒绝 JSON 或缺少必要标题的输出。模型异常或结构不合格时,系统持久化 fallback 报告,保留知识未命中、工具失败和证据不足状态。
📷 [图片 token=RTtdbpH5ho3orTxxO5tcVoNEnFd(未能下载,见飞书原文)]
看什么:报告生成先算出 fallback,再尝试模型;模型异常、空结构、JSON 或缺标题最终都会落回同一份确定性 Markdown。
        fallback = _fallback_report_content(
            alert=_json_dict(state.get("alert")),
            no_sop_matched=bool(state.get("no_sop_matched")),
            sop_hits=cast(list[JsonDict], state.get("sop_hits") or []),
            evidence=cast(list[JsonDict], state.get("evidence") or []),
            execution_failed=bool(state.get("execution_failed")),
        )
        prompt = _report_prompt(state)
        try:
            # 1. 模型失败不阻止已有证据形成报告。
            response = await self._llm_provider.create_chat_model().ainvoke(prompt)
        except Exception:
            return fallback, "fallback"
        report = _clean_markdown_report(_model_text(response))
        return (report, "llm") if report is not None else (fallback, "fallback")

# … 省略其他报告辅助函数
    # 2. JSON 或缺少必需标题的内容不进入持久报告。
    if report.startswith(("{", "[")):
        return None
    if not all(heading in report for heading in AIOPS_REPORT_REQUIRED_HEADINGS):
        return None
    return report
这段代码证明模型只是报告呈现的一种实现,持久化完成并不依赖模型一定成功。它不证明 fallback 已确认根因;相反,fallback 会根据 execution_failed 和证据缺口明确保留“未获取”与“无法确认”。
看什么:最后用状态图读取真实图路由。当前单步计划通常一次执行后就报告;图中保留回到 Executor 的通路,是为了既有计划长度大于当前索引时使用,而不是模型重新规划。
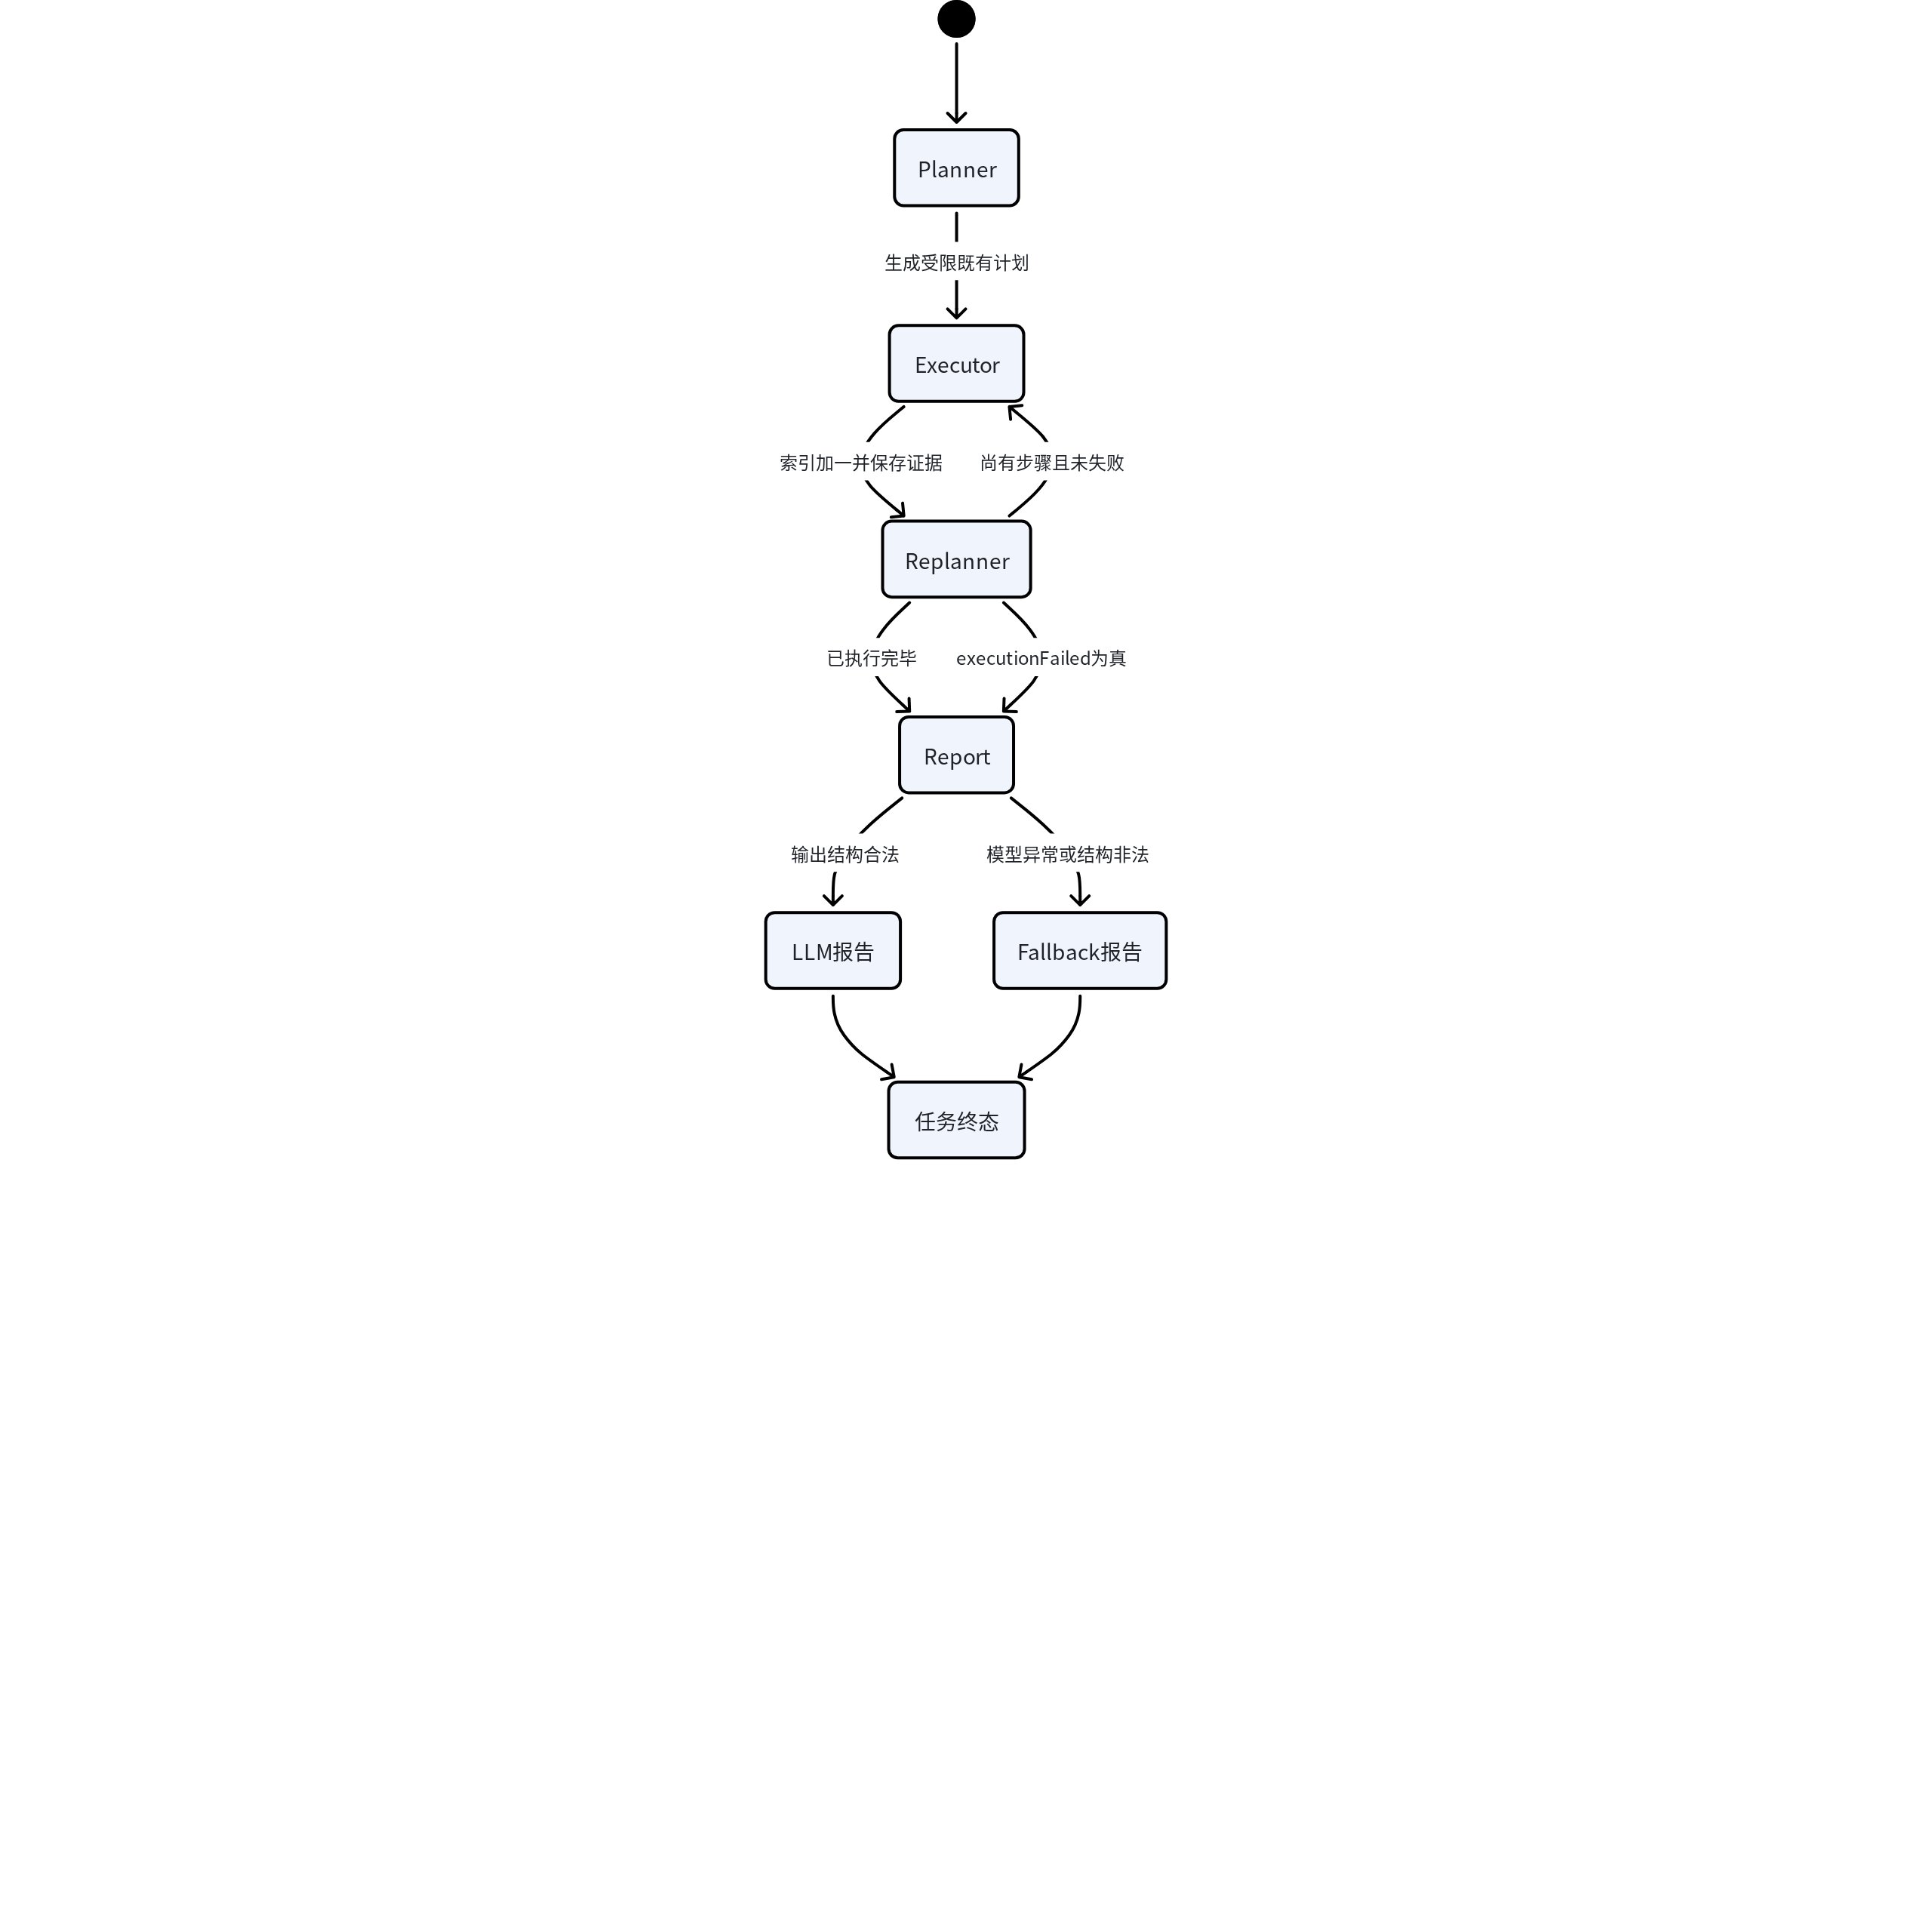
这张图证明终态由 Executor 是否失败决定,而不是“最终是否成功写出一篇报告”决定;失败任务仍可拥有 fallback 报告。只有状态为 succeeded 时,后续自动案例沉淀才会被触发。
数据、契约与状态
一项诊断同时存在多个不同粒度的记录。DiagnosticTaskRecord 保存总体状态、查询、输入和结果;DiagnosticStepRecord 保存 Planner、Executor、Replanner、Report 的顺序和结构化 payload;AgentToolCallAuditRecord 保存工具调用生命周期;DiagnosticEvidenceRecord 保存 alert、knowledge reference 或 log 等证据;ReportEvidenceLinkRecord 将报告和证据显式关联;GraphCheckpointRecord 保存每个图节点的 checkpoint。
📷 [图片 token=UNBnbJV5eoT7PsxXKg6cIhRen1g(未能下载,见飞书原文)]
SSE 是实时传输协议,不是唯一事实来源。packages/api-contracts/src/sse.ts 用 type 和 channel 区分 task.status、tool.call、reference.source、report、complete 和 error。后台运行时先把这些 payload 存入 job event,再由订阅接口按 sequence 读取。浏览器断开不会删除任务;重连后的最终状态通过 SQLite 证据链恢复。
📷 [图片 token=VY2DblDwCocymtxwyVZcIjmLnih(未能下载,见飞书原文)]
报告完成时,任务只有在未发生执行失败时才标为 succeeded;否则为 failed,但仍可能有一份 fallback 报告解释失败。成功报告会逐一创建 report-evidence link,并可触发自动案例沉淀。因而“有报告”不必然表示诊断成功,“任务成功”也不表示系统已经执行处置动作:当前链路负责取证和建议,不会把建议写成已经执行的变更。
权限、安全与失败边界
诊断 task、历史、流、证据链、报告、案例和工具审计都以 owner_user_id 查询。访问其他用户的 diagnostic ID 会得到统一权限错误。知识检索还必须携带当前用户可访问的知识库集合;授权集合为空时应返回空结果,而不是扩大到全局搜索。MCP 工具同样从当前用户启用连接装配。
📷 [图片 token=HmJmbJ2mAoLegJxlUoscQebHnie(未能下载,见飞书原文)]
外部告警列表是配置数据源的实时视图,不是每个用户独立保存的资源,但该接口仍要求认证。数据源部分成功时只返回成功来源;全部失败时不展示旧告警或模拟告警。普通启动流程也不会自动发布演示告警、上传 CLS 日志或写入 SOP,这些都必须由开发者显式执行。
最重要的可信边界是:工具结果、日志、根因和成功状态都不应被伪造。检索失败、MCP 发现失败、工具调用失败、模型报告失败都在代码中有独立分支。_report_prompt 明确要求模型只使用已有事实,处置建议也不代表真实操作已经执行;但 _clean_markdown_report 只检查基本 Markdown 结构,不执行基于 evidence 的语义 grounding 校验。只要必要标题齐全,一段内容并不会因为通过结构校验就自动成为可信事实,因此最终结论必须与持久证据逐项对照。
阅读顺序与小结
从
alerts.py和useAiopsStore.diagnoseAlert看告警输入如何保留来源。阅读
api/app.py的创建、流和证据链路由,理解后台任务与 SSE 的分离。按
_planner、_executor、_replanner、_report顺序阅读诊断服务。最后对照 repository 与共享契约,核对每项用户可见结果是否都有持久证据。
OncallAgent 的诊断闭环真正有价值的部分,是把“模型给出的文字”拆回一条可查询的事实链。告警有来源,知识命中有引用,工具有审计,日志有摘要,报告有证据链接,失败也有状态。只有这些对象能够互相对应,AIOps Agent 才能成为工程系统,而不只是一次性问答。