OncallAgent 作为本地优先 AIOps Agent 工作台,需要同时解决三类上下文问题:Prompt 决定 Agent 的长期行为约束,Skill 提供按任务启用的专业操作说明,会话记忆控制历史在模型窗口中的占用。它们都会影响下一次 Agent 执行,但数据生命周期不同,不能混成一个“大字符串配置”。
📷 [图片 token=Ns0ybOKpzoeoY1x62MTcPCrLnCz(未能下载,见飞书原文)]
当前实现把用户可编辑 Prompt、上传的标准 SKILL.md、Prompt 与 Skill 选择持久化在 user scope 下;每次流式请求由服务端重新装配。Skill 采用渐进式披露:system prompt 只出现 name 和 description,完整正文必须由模型通过 load_skill 工具按需读取。
会话记忆则是 session scope。压缩不会删除 SQLite 原始消息,而是写入摘要、推进已压缩消息边界,并只把摘要与边界后的消息交给模型。这让“模型看到什么”和“用户历史里保存什么”保持可解释的分离。
📷 [图片 token=QWWAb2CiHovfMmxuaMvcBSlwn0f(未能下载,见飞书原文)]
学习目标
理解 user-scoped Prompt、Skill 资产和选择配置的持久化模型。
掌握标准 Skill 上传校验与
load_skill渐进式加载。理解强制系统指令、用户 Prompt 和轻量 Skill catalog 的装配顺序。
区分三种 session memory mode、70% 自动阈值与 95% 硬上限。
理解摘要、压缩边界、token 占用和完整聊天历史之间的关系。
功能入口与完整调用链
配置入口由 GET /chat/configuration 和 PUT /chat/configuration 提供。首次读取时,服务为当前用户创建默认 Prompt 和空 Skill 选择。用户可通过 POST /chat/prompts、PUT /chat/prompts/{prompt_id}、删除路由维护 Prompt,通过 POST /chat/skills 上传一个严格命名为 SKILL.md 的文件,再选择零个或多个属于自己的 Skill。
📷 [图片 token=GAh3b0P0ZosC39xblNMcHJs9nOb(未能下载,见飞书原文)]
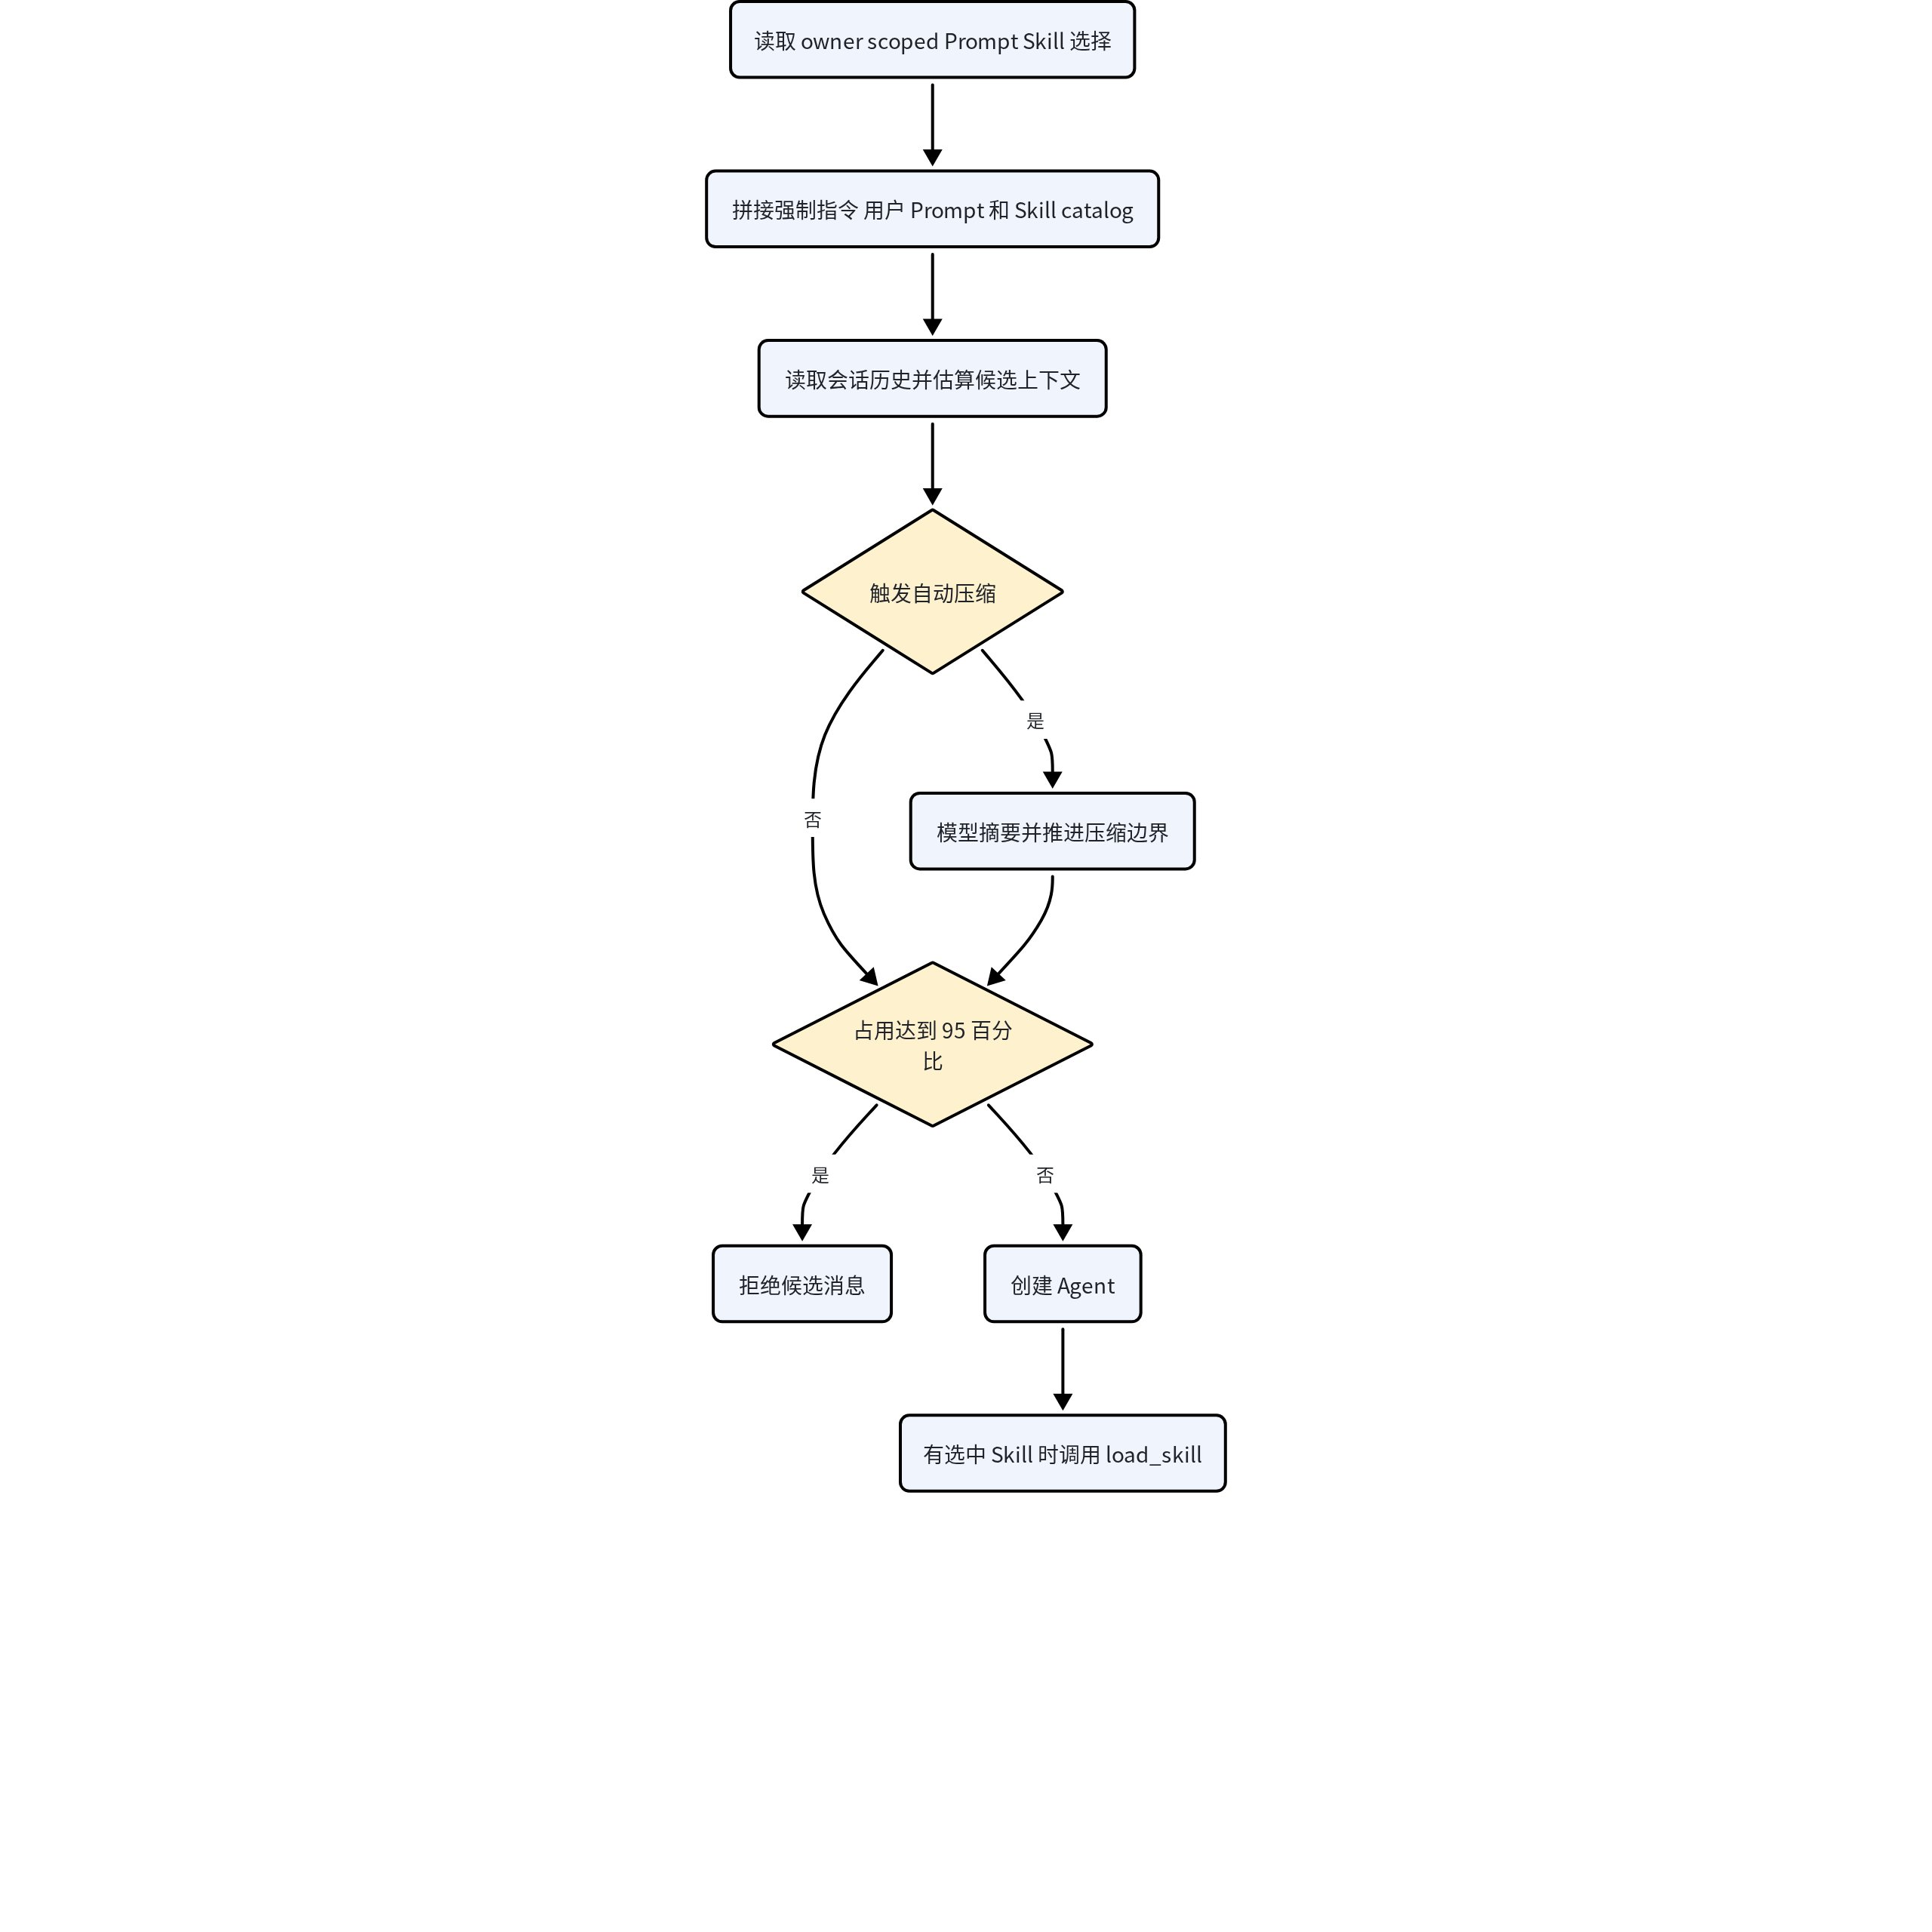
发送消息时,ChatStreamingService.build_agent_configuration 读取 user-scoped 配置、Prompt 和 Skills。build_chat_system_prompt 拼接不可省略的安全与工具指令、用户选中的 Prompt 正文,以及只含 Skill name 和 description 的 Available Skills catalog。LangChainChatAgentRunner 只有在存在选中 Skills 时才注册 load_skill 工具。
进入 Agent 之前,ChatMemoryService.prepare_message 读取当前会话的 memory_mode、memory_summary、compacted_message_count 和历史。它估算候选上下文,必要时调用模型生成新摘要;达到 95% 硬上限则在用户消息落库前拒绝。成功时只把压缩边界后的消息、候选用户消息和摘要化 system prompt 交给 Agent。
📷 [图片 token=JIsLb0lyboxjDjxHcbocRVy3nEe(未能下载,见飞书原文)]
配置阶段:
  Prompt CRUD + SKILL.md upload
  → owner-scoped Repositories
  → user_chat_configurations 选择 promptId / skillIds

聊天阶段:
  build_agent_configuration
  → 强制指令 + 用户 Prompt + 轻量 Skill catalog
  → ChatMemoryService.prepare_message
  → 可选摘要 + 未压缩消息
  → create_agent
  → 需要时 load_skill(name) 取得选中 Skill 正文
核心源码地图
| 源码位置 | 关键符号 | 职责 |
|---|---|---|
apps/backend/src/super_ai/chat/configuration.py | build_chat_system_prompt、validate_skill_upload、validate_chat_prompt_content | Prompt 校验、Skill 标准校验与服务端 system prompt 装配。 |
apps/backend/src/super_ai/chat/streaming.py | build_agent_configuration、create_load_skill_tool | 加载当前用户资产并注册仅含选中 Skills 的运行时工具。 |
apps/backend/src/super_ai/chat/memory.py | ChatMemoryService、estimate_context_tokens、memory_payload | 会话压缩策略、token 估算、硬上限和状态序列化。 |
apps/backend/src/super_ai/api/app.py | get_chat_configuration、Prompt/Skill 路由、update_chat_memory、compact_chat_memory | 受保护配置和会话记忆 HTTP 表面。 |
apps/backend/src/super_ai/memory/sqlite.py | SQLiteUserChatPromptRepository、SQLiteUserChatSkillRepository、SQLiteChatMemoryRepository | owner 与 session 范围的 SQLite 实现。 |
apps/backend/src/super_ai/memory/models.py | UserChatConfigurationModel、UserChatPromptModel、UserChatSkillModel、ChatSessionModel | 选择、资产、摘要、边界与 token 状态模式。 |
packages/api-contracts/src/chat-configuration.ts | ChatAssemblyConfigurationResponse、ChatSkillAsset | 共享 Prompt、Skill 和选择 DTO。 |
packages/api-contracts/src/chat.ts | ChatMemoryMode、ChatMemoryState | 共享三种模式、token、窗口、占用率和压缩状态。 |
apps/backend/tests/test_chat_memory.py | test_thirty_turn_mode_compacts_without_deleting_history | 证明压缩推进边界但保留所有原始消息。 |
apps/backend/tests/test_stream_rag_chat_api.py | test_chat_configuration_is_validated_and_isolated_by_owner、test_load_skill_tool_progressively_discloses_only_selected_content | 验证资产隔离、装配和渐进式正文披露。 |
openspec/specs/chat-memory-management/spec.md | Compression preserves full history | 规定 session 模式、自动阈值、手动压缩与硬上限。 |
代码调用流程图
Prompt、Skill 与 memory 分别属于用户配置、按需工具和会话状态。流程图展示它们如何在一次请求中汇合,同时保留各自的权限和生命周期。
关键实现拆解
Prompt 不是唯一系统指令
**看什么:**看 system prompt 的拼接顺序:强制指令始终在前,用户 Prompt 是独立段落,Skill 目录只含 name 与 description。
    # 1. 强制指令不会被用户 Prompt 替换。
    sections = [
        MANDATORY_CHAT_SYSTEM_PROMPT,
        "用户选择的系统提示词:\n" + prompt_content.strip(),
    ]
    if skills:
        # 2. 初始 prompt 只披露 Skill name 与 description。
        skill_catalog = "\n".join(
            f"- **{skill.name}**: {skill.description}" for skill in skills
        )
        sections.append(
            "\n".join(
                [
                    "## Available Skills",
                    skill_catalog,
                    "以上仅为当前会话允许使用的 Skill。判断用户任务与某个 Skill 的描述匹配时,"
                    "必须先调用 `load_skill` 并传入该 Skill 的 name,再依据返回的完整指令回答。"
                    "不要猜测或声称已加载未调用的 Skill。",
                ]
            )
        )
    return "\n\n".join(section for section in sections if section.strip())
这段装配证明用户 Prompt 是偏好层,不是删除强制安全、引用和时间工具约束的覆盖层。完整 Skill Markdown 没有被预先拼入 system prompt;配置只影响后续请求,既有 SQLite 消息和工具审计不会被重写。
📷 [图片 token=XdRcbDyU5oN6qCxgRHJckjtjncf(未能下载,见飞书原文)]
用户 Prompt 名称与正文都会 trim,不能为空;名称最长 160 字符,正文最长 12000 字符。默认 Prompt 由 ensure_default 为每个 owner 单独创建。UserChatConfigurationModel 以 owner_user_id 为主键,保存 system_prompt_id 和 JSON skill_ids,因此每个用户只有一份当前装配选择,但可以拥有多份 Prompt 和 Skill 资产。
build_chat_system_prompt 始终先加入 MANDATORY_CHAT_SYSTEM_PROMPT。其中包含按需使用工具、引用知识来源、不编造工具结果、CLS 查询参数和时间查询前调用 get_current_time 等约束;用户 Prompt 被放在“用户选择的系统提示词”段落中。用户自定义内容不会覆盖或删除这些强制指令。
修改配置只影响后续 Agent 请求。SQLite 中既有消息、引用和工具审计不会被改写。删除当前选择的 Skill 时,API 从 selection 中移除它;删除当前 Prompt 后,配置回退到该用户重新确保存在的默认 Prompt。提交配置前,后端逐个按 owner 读取 prompt 和 skill,未知或跨用户 ID 返回统一参数错误。
📷 [图片 token=XjDtbhqvwoRPsZxYw0Dce0gmnab(未能下载,见飞书原文)]
标准 Skill 校验与渐进式披露
**看什么:**先看上传校验在 Repository 写入前如何固定文件名、字节上限、UTF-8 和 YAML frontmatter 边界。
    normalized_filename = PurePath(filename or "").name
    # 1. basename 与原始文件名都必须严格等于 SKILL.md。
    if normalized_filename != (filename or "") or normalized_filename != "SKILL.md":
        raise ValueError("Skill 文件名必须严格为 SKILL.md。")
    if not content:
        raise ValueError("Skill 文件不能为空,请上传 UTF-8 Markdown 文本。")
    if len(content) > MAX_CHAT_SKILL_BYTES:
        raise ValueError("Skill 文件不能超过 64 KB。")
    try:
        decoded = content.decode("utf-8")
    except UnicodeDecodeError as exc:
        raise ValueError("Skill 文件必须是 UTF-8 编码的 Markdown 文本。") from exc
    normalized_content = decoded.strip()
    if not normalized_content:
        raise ValueError("Skill 文件不能为空,请写入可读的 Markdown 指令。")
    # 2. frontmatter 必须位于正文开头并可解析成键值对象。
    match = _SKILL_FRONTMATTER_PATTERN.match(normalized_content)
    if match is None:
        raise ValueError("SKILL.md 必须以包含 name 和 description 的 YAML frontmatter 开头。")
    try:
        parsed_metadata: object = yaml.safe_load(match.group(1))
    except yaml.YAMLError as exc:
        raise ValueError("SKILL.md 的 YAML frontmatter 格式无效。") from exc
这里校验的是结构与 metadata,不是对 Skill 正文做语义安全认证。未知格式会在保存前失败;通过校验的完整正文仍是用户可影响 Agent 的指令文本,所以后续必须继续依赖 owner scope、选择范围和服务端工具权限。
**看什么:**再看运行时 registry 的闭包范围;只有本次配置已加载的 SelectedChatSkill 能被按 name 取回。
    # 1. registry 只由当前请求已选中的 Skills 构建。
    skill_registry = {skill.name: skill for skill in skills}
    available_names = ", ".join(skill_registry)

    async def load_skill(skill_name: str) -> str:
        requested_name = skill_name.strip()
        skill = skill_registry.get(requested_name)
        if skill is None:
            # 2. 未选择的名称不会回退查询全局目录。
            return (
                f"Skill '{requested_name}' 不可用。当前可加载的 Skill: {available_names or '无'}。"
            )
        return f"Loaded skill: {skill.name}\n\n{skill.content}"
渐进式披露减少初始上下文,但不构成代码沙箱:成功调用后完整正文会进入模型工具上下文。未选择、已删除或属于其他用户的 Skill 不会出现在 registry;UI 可见工具摘要又会压缩成首行,避免把全文直接展示为审计结果。
validate_skill_upload 要求文件 basename 与原文件名都精确等于 SKILL.md,非空、UTF-8、最大 65536 bytes。正文必须以 YAML frontmatter 开头,并包含字符串 name 与 description。name 长度 1 到 64,只允许小写字母、数字和单连字符,不能以连字符开头或结尾,也不能含连续双连字符;description 非空且不超过 1024 字符。
📷 [图片 token=EeakbDlsqobaMyxsZWbcwkYNnAd(未能下载,见飞书原文)]
Repository 对 owner 与 name 建唯一约束,同一用户重复 name 会转成明确 ValueError。不同用户可以拥有同名 Skill,因为唯一键包含 owner。服务保存完整标准 Markdown,但配置响应只暴露 filename、name、description、label、contentPreview、大小和时间,不把完整 content 放进共享 ChatSkillAsset。
装配时 SelectedChatSkill 在服务端携带正文,但 system prompt 只渲染 name 与 description,并要求模型先调用 load_skill。create_load_skill_tool 用当前请求的选中 Skills 构建 registry;传入未选择或其他用户的 name,只返回“不可用”以及当前可用 names,不访问全局目录。成功调用才返回 Loaded skill: name 和完整 content。
📷 [图片 token=I0jzbMt8jo1MN4xiACEc2HQknty(未能下载,见飞书原文)]
工具的 SSE output 对 load_skill 特别处理,只给 UI 一个首行摘要,不把完整 Skill 正文直接作为工具结果展示。需要注意,正文会进入模型工具上下文,这是渐进加载的目的;“不预先注入 system prompt”不等于正文永远不进入模型。
📷 [图片 token=CoQRbECrhoi1VkxME1Ichlgsnrc(未能下载,见飞书原文)]
三种会话记忆模式
**看什么:**看切换 memory mode 时的真实分支:manual 会立即调用 compact,另外两种只刷新使用量,自动压缩要等下一次 prepare_message。
        # 1. mode 先持久化到当前 owner 的 session。
        updated = await self._repositories.chat.update_memory_state(
            owner_user_id=owner_user_id,
            session_id=session.id,
            memory_mode=mode,
        )
        current = updated or session
        if mode == "manual":
            # 2. 切换 manual 时立即尝试压缩现有未压缩历史。
            return await self.compact(
                owner_user_id=owner_user_id,
                session=current,
                history=history,
                system_prompt=system_prompt,
            )
        return await self.refresh_usage(
            owner_user_id=owner_user_id,
            session=current,
            history=history,
            system_prompt=system_prompt,
        )
manual 没有未压缩消息时,compact 只刷新 token 使用量,不调用摘要模型。memory_mode 存在 session 上,所以同一用户不同会话可以不同;默认 every_30_turns 与 context_70_percent 的触发判断发生在候选 user message 进入 Agent 之前。
新会话默认 every_30_turns。prepare_message 从 compacted_message_count 切出未压缩历史,把候选 user message 加入估算,并统计未压缩区间的 assistant 数量。达到 30 条 assistant 消息时,在下一次 Agent 调用前压缩这一段。context_70_percent 则在候选上下文达到或超过窗口 70% 时先压缩。
manual 不按轮数或 70% 自动触发。当前 API 的 set_mode 在切换为 manual 时会立即调用一次 compact;以后可通过 POST /chat/sessions/{session_id}/memory:compact 再次压缩新增历史。另一个容易忽略的边界是:如果切换 manual 时没有未压缩消息,服务只刷新使用量,不调用摘要模型。
📷 [图片 token=Qk2IbuCrZo9BNGxkdJ0cqjWdnCb(未能下载,见飞书原文)]
摘要 prompt 要求保留用户目标、事实、偏好、决策、未完成事项、工具结果和引用,最多 1200 汉字。模型返回非空摘要后,服务把 compacted_message_count 增加当前批次的消息数,更新 memory_summary、context_tokens 和 last_compacted_at。下一次上下文由强制和用户 system prompt、摘要指令、边界后的消息组成。
📷 [图片 token=FdzHbibBNogrMJxwZe1c0j9snfg(未能下载,见飞书原文)]
token 估算与 95% 硬上限
**看什么:**看 memory 服务先判自动压缩,再用摘要和候选消息重新估算;95% 检查位于 user message 持久化之前。
        # 1. 默认模式按 assistant 数,阈值模式按候选上下文占用。
        completed_turns = sum(message.role == "assistant" for message in uncompressed)
        should_compact = (
            current.memory_mode == "every_30_turns" and completed_turns >= 30
        ) or (
            current.memory_mode == "context_70_percent"
            and _usage_percent(candidate_tokens, self.context_window_tokens)
            >= AUTO_CONTEXT_THRESHOLD_PERCENT
        )
        if should_compact and uncompressed:
            current = await self._compact_messages(
                owner_user_id=owner_user_id,
                session=current,
                messages=uncompressed,
                system_prompt=system_prompt,
            )
            candidate_messages = [candidate]
            candidate_tokens = estimate_context_tokens(
                system_prompt=system_prompt,
                memory_summary=current.memory_summary,
                messages=candidate_messages,
            )
        # 2. 压缩后仍达到硬上限就明确拒绝,不截断输入。
        if (
            _usage_percent(candidate_tokens, self.context_window_tokens)
            >= HARD_CONTEXT_THRESHOLD_PERCENT
        ):
            raise ChatContextLimitReached
硬上限以当前 chat model 对应的 context window 计算,后端才是最终门槛;前端的 95% 快速阻止可能基于上一次刷新而略有滞后。拒绝发生在 append user message 之前,且代码不会继续压缩摘要本身或静默截断用户输入。
estimate_context_tokens 使用 LangChain 的 count_tokens_approximately 对 system、摘要和 user/assistant 消息估算。窗口大小由应用当前 chat model 的能力配置传入 ChatMemoryService,并在响应中返回 contextWindowTokens。占用率保留一位小数且最多 100。
prepare_message 会先尝试适用的自动压缩,再重新计算。若候选上下文仍达到或超过 95%,抛出 ChatContextLimitReached。ChatStreamingService 在写用户消息前捕获它并发出 CHAT_CONTEXT_LIMIT_REACHED SSE,所以绕过前端也不能把被拒绝消息持久化。前端 store 也在已有 session 占用率达到 95% 时阻止 send 并提示手动压缩。
📷 [图片 token=OCpJbQksioWtBtxT6J6cVqr3nmc(未能下载,见飞书原文)]
用一次配置变更观察服务端装配
**看什么:**看配置更新先逐个以当前 owner 读取资产,全部验证通过后才写 selection;不存在部分保存。
        prompt_repository = _chat_prompt_repository(request)
        skill_repository = _chat_skill_repository(request)
        configuration_repository = _chat_configuration_repository(request)
        # 1. Prompt 必须能在当前 owner 范围内读取。
        prompt = await prompt_repository.get(
            owner_user_id=user.id,
            prompt_id=body.system_prompt_id,
        )
        if prompt is None:
            raise ApiErrorException("VALIDATION_INVALID_ARGUMENT")
        skill_ids = list(dict.fromkeys(body.skill_ids))
        # 2. 所有 Skill 逐个验证后才更新配置记录。
        for skill_id in skill_ids:
            skill = await skill_repository.get(owner_user_id=user.id, skill_id=skill_id)
            if skill is None:
                raise ApiErrorException("VALIDATION_INVALID_ARGUMENT")
        await configuration_repository.update(
            owner_user_id=user.id,
            system_prompt_id=prompt.id,
            skill_ids=skill_ids,
        )
        prompts, skills, record = await _read_chat_configuration(request, owner_user_id=user.id)
        return success_response(request, _chat_configuration_payload(prompts, skills, record))
配置表只保存资产 ID,下一次发送消息时才读取最新正文;因此编辑 Prompt 不需要重存 selection。任一未知或跨用户 ID 会在 update 前失败并保留旧配置,运行时还会过滤遗留的无效 Skill ID 并回写有效列表。
假设用户创建“故障排查回答规范”Prompt,上传一个 name 为 log-analysis 的 Skill,并保存选择。PUT 配置时,后端先在当前 owner 的 Prompt 表中读取 prompt ID,再逐个读取 Skill ID;任何一个不存在就立即返回验证错误,旧 selection 不会被部分更新。验证通过后,配置表只保存 ID,不复制资产正文。
下一次发送消息时,stream service 才读取 selection 和资产。这意味着修改 Prompt 正文后,不必重存 selection,后续请求会取得新正文;删除 Skill 后,删除路由同时把 ID 从 selection 移除。若数据库中因旧数据仍有无效 ID,装配代码也会过滤并修复。多层校验让请求运行时不会把空引用悄悄当成已启用能力。
📷 [图片 token=SJSdbH6XxoBy5UxAtbrcLYFznxf(未能下载,见飞书原文)]
Agent 初始 system prompt 能看到 log-analysis 的 description,却看不到正文。只有模型判断当前问题与 description 匹配并调用 load_skill,完整指令才作为工具结果加入当前轮次上下文。若问题只是普通寒暄,Skill 正文不会消耗 token,也不会干扰回答。配置是用户级的,所以同一用户所有会话的后续执行都共享选择;当前实现没有会话级 Prompt 或 Skill 覆盖。
📷 [图片 token=KtAJbHzr6oZqf8xyVCXcAUojnrw(未能下载,见飞书原文)]
压缩边界如何改变模型视野
**看什么:**看摘要生成如何同时接收已有摘要与新增 transcript,并只推进边界计数,不删除原始 messages。
        transcript = "\n".join(
            f"{message.role}: {message.content}" for message in messages
        )
        # 1. 新摘要显式合并已有摘要与本批未压缩历史。
        prompt = (
            "请将以下对话压缩为可供后续模型继续对话的中文记忆摘要。保留用户目标、"
            "明确事实、偏好、决策、未完成事项、工具结果和引用来源;删除寒暄与重复内容。"
            "只输出摘要正文,不超过 1200 个汉字。\n\n"
            f"已有摘要:\n{session.memory_summary or '无'}\n\n"
            f"新增对话:\n{transcript}"
        )
        response = await self._llm_provider.create_chat_model().ainvoke(prompt)
        summary = _extract_model_text(response).strip()
        if not summary:
            raise RuntimeError("The model returned an empty memory summary.")
        # 2. 边界累加本批数量,原始消息表没有删除操作。
        compacted_count = session.compacted_message_count + len(messages)
        tokens = estimate_context_tokens(
            system_prompt=system_prompt,
            memory_summary=summary,
            messages=[],
        )
模型摘要为空会失败且不推进边界。成功后只更新 session 的 memory_summary、compacted_message_count、token 和时间;完整历史 API 仍读取所有原消息。摘要是模型生成的压缩表达,不应被当作新的独立证据或用户逐字原话。
设一个会话已有 60 条未压缩消息,也就是 30 次 user-assistant 往返,默认模式下用户再发第 31 个问题。prepare_message 先构造一个尚未持久化的 candidate,统计未压缩区域中的 assistant 条数为 30,于是把 60 条历史交给摘要模型。摘要成功后,compacted_message_count 变为 60,candidate 成为当前传给 Agent 的唯一普通消息,memory_summary 通过额外 system 指令加入。
服务随后才把真实用户消息保存到 SQLite,并用 candidate 所在位置替换为真实 message record 交给 Agent。完整历史 API 仍能返回此前 60 条加上新消息;只有模型上下文缩短。回答完成后 refresh_usage 再按摘要和边界后的真实消息估算 token。因此 contextTokens 是当前模型上下文的估算状态,不是数据库全部历史的 token 总和。
📷 [图片 token=JFLFbjyIDoFAdoxiSXKc2IhnnMh(未能下载,见飞书原文)]
下一次压缩不会丢掉旧摘要。_compact_messages 的 prompt 同时包含已有摘要和新增未压缩 transcript,要求模型合并。边界增加的是当前批次的 messages 数量,而不是重置为列表长度。这个累积规则使多轮手动压缩可持续推进;如果消息被清空,Repository 则显式把摘要和边界一起归零,防止旧记忆污染空会话。
📷 [图片 token=ATq4bVhSNoUiq8x9br7cYrMqnac(未能下载,见飞书原文)]
阈值模式的细微差别
**看什么:**这张状态图把候选消息、70% 自动压缩与 95% 硬拒绝放在同一请求内,突出两次估算的先后顺序。
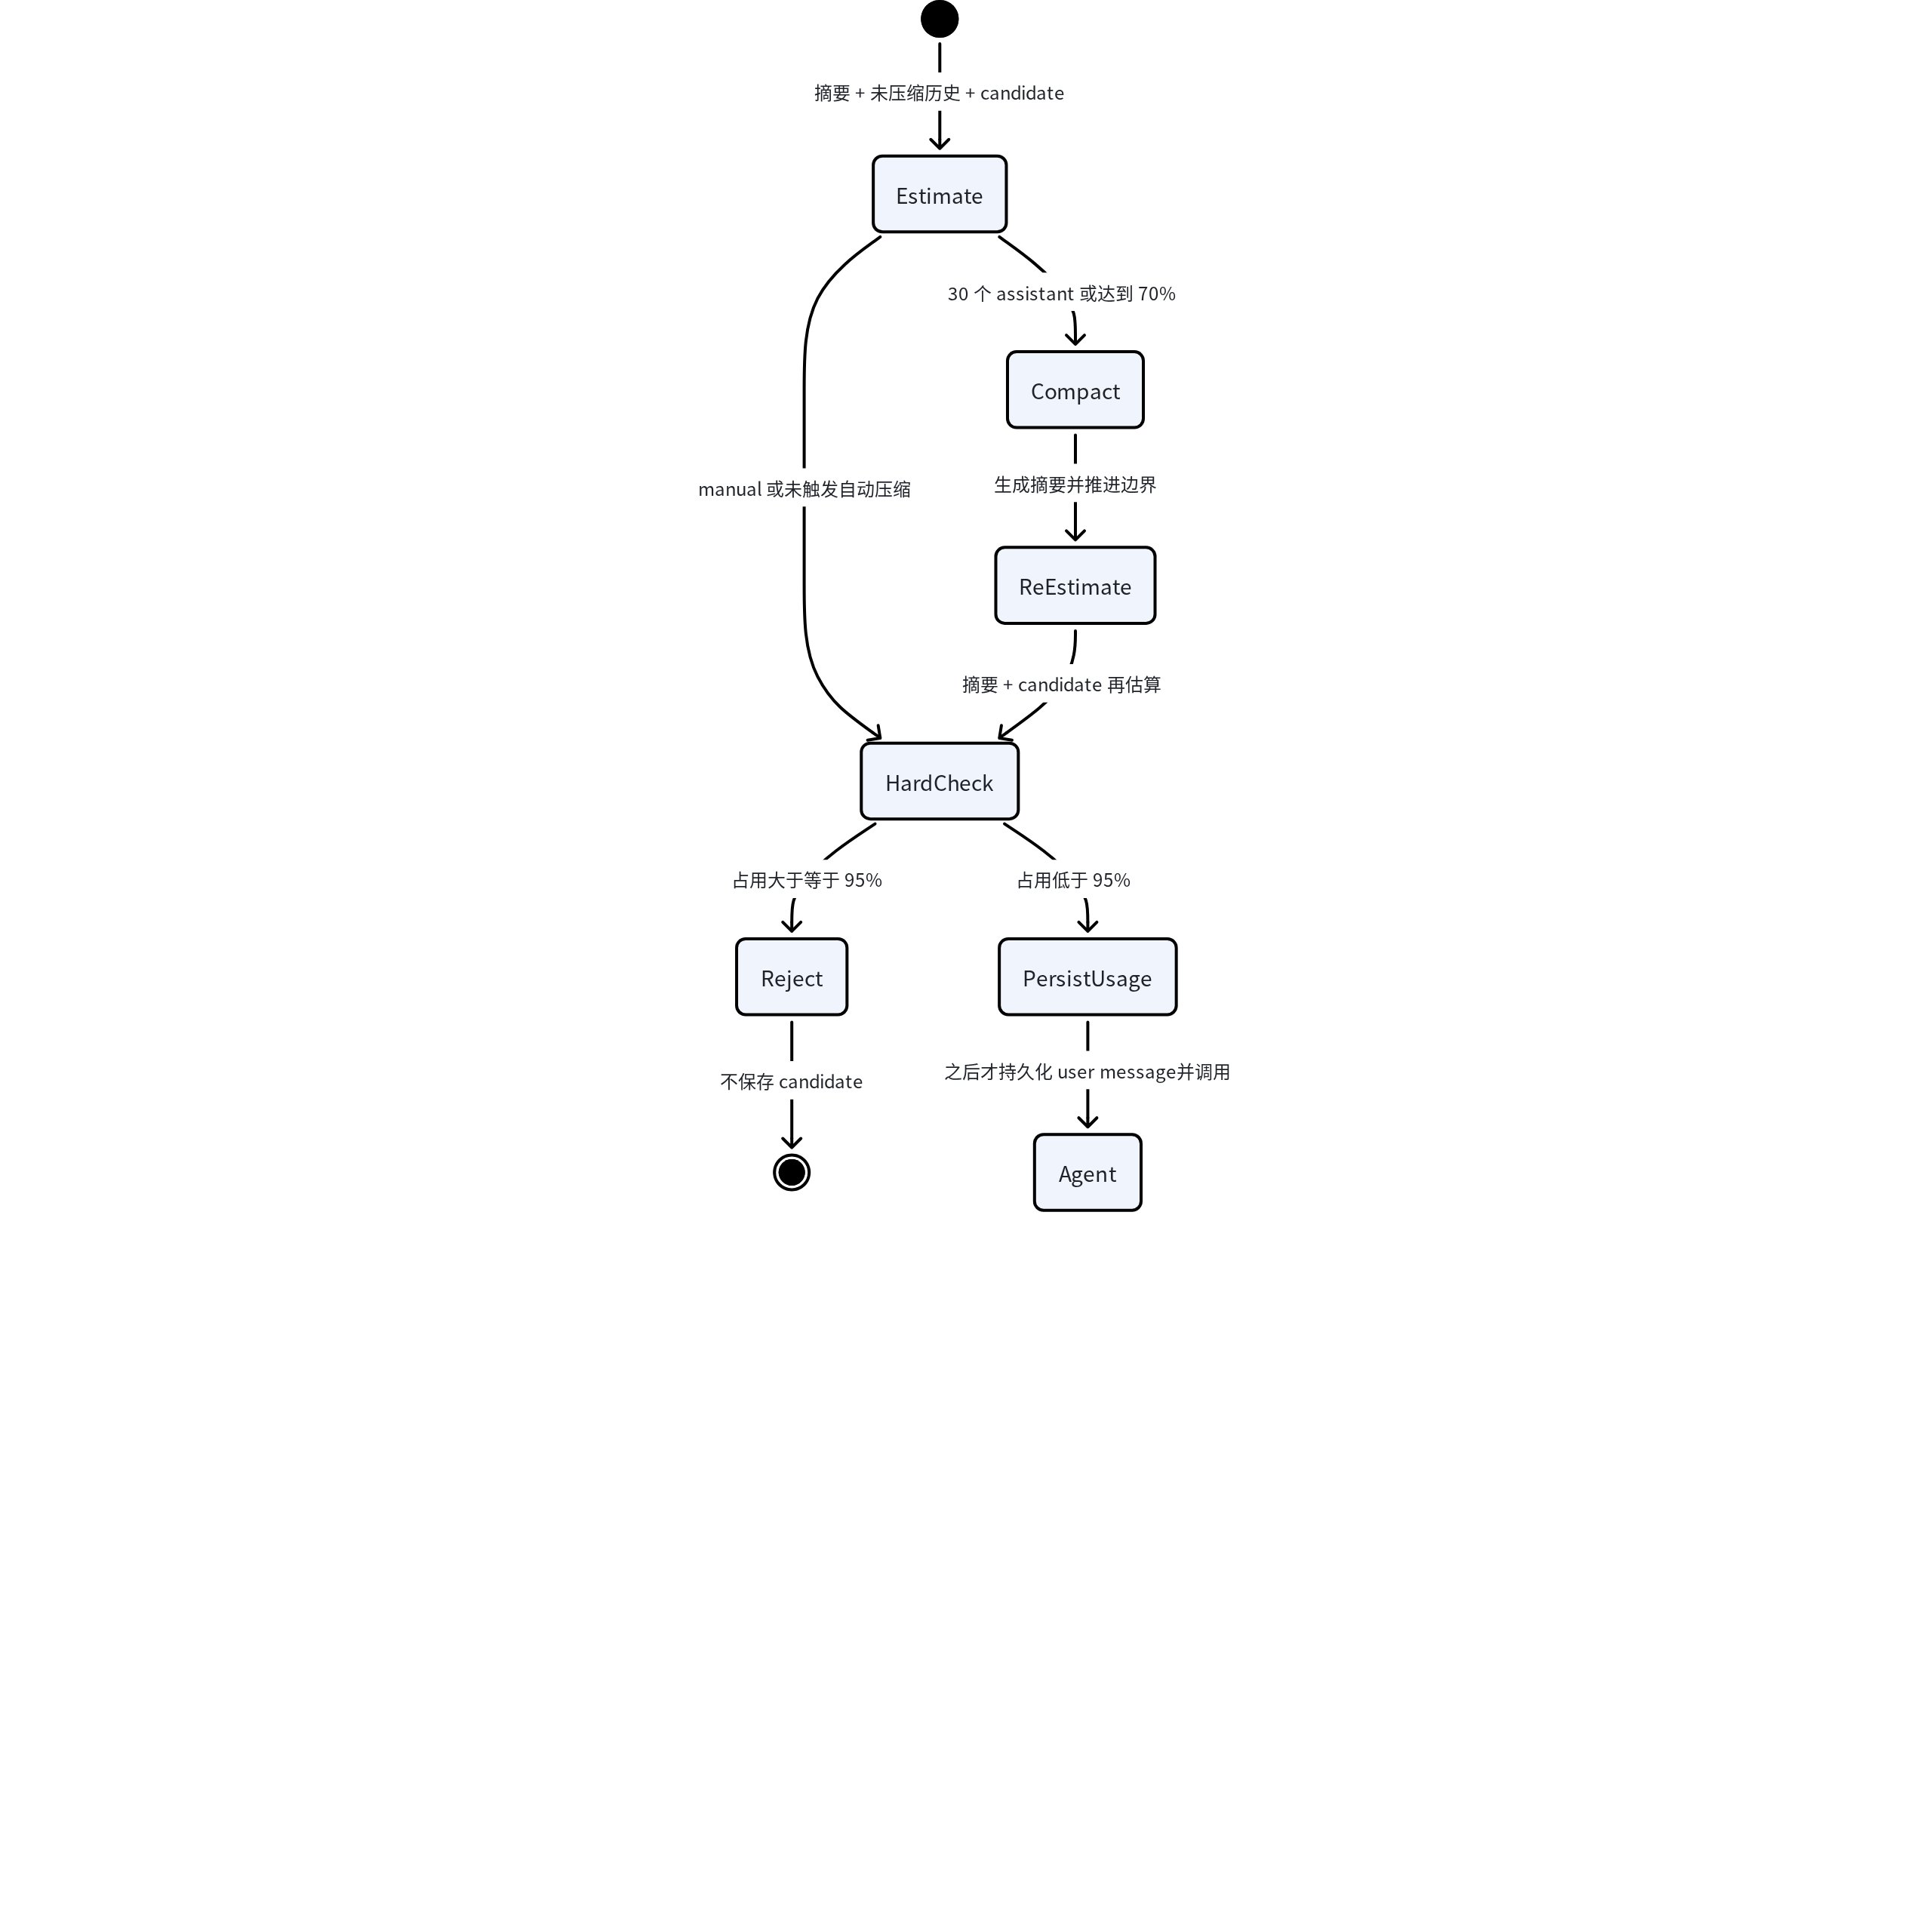
every_30_turns 统计边界后的 assistant 数,context_70_percent 则把 candidate 纳入占用;manual 不自动触发。自动压缩只执行一次,重新估算后若仍达 95% 就拒绝,不会再次压摘要或丢弃输入。
every_30_turns 判断的是压缩边界之后完成的 assistant 数,不是简单按消息总数除以二。只有 user 消息没有对应 assistant 时,不算完成一轮。context_70_percent 在加入候选消息后估算,因此能够在真正越过阈值的那次请求进入 Agent 前先压缩,而不是等回答结束才处理。
自动压缩只有在存在未压缩消息时执行。压缩后系统重新用摘要和 candidate 估算;若仍达到 95%,请求被拒绝。代码没有在这一刻再次压缩摘要本身,也不会截断用户输入来强行通过。用户必须调整内容、窗口配置或显式管理记忆,系统不会隐式丢弃事实。
前端用会话响应里的 contextUsagePercent 做快速阻止,但这个值来自上一次刷新,可能在发送前略有滞后。后端用实际候选重新估算才是最终门槛。双层检查改善体验但不依赖前端安全性。错误通过共享目录返回固定中文消息,客户端绕过 UI 也得到同样结果。
📷 [图片 token=TDeQb3jnFoFR9qxo8l5c8rcgnxf(未能下载,见飞书原文)]
Prompt、Skill 与摘要的信任层级
**看什么:**这张图按来源与约束关系区分四类上下文,避免把“进入同一个模型请求”误解成“可信度和权限相同”。
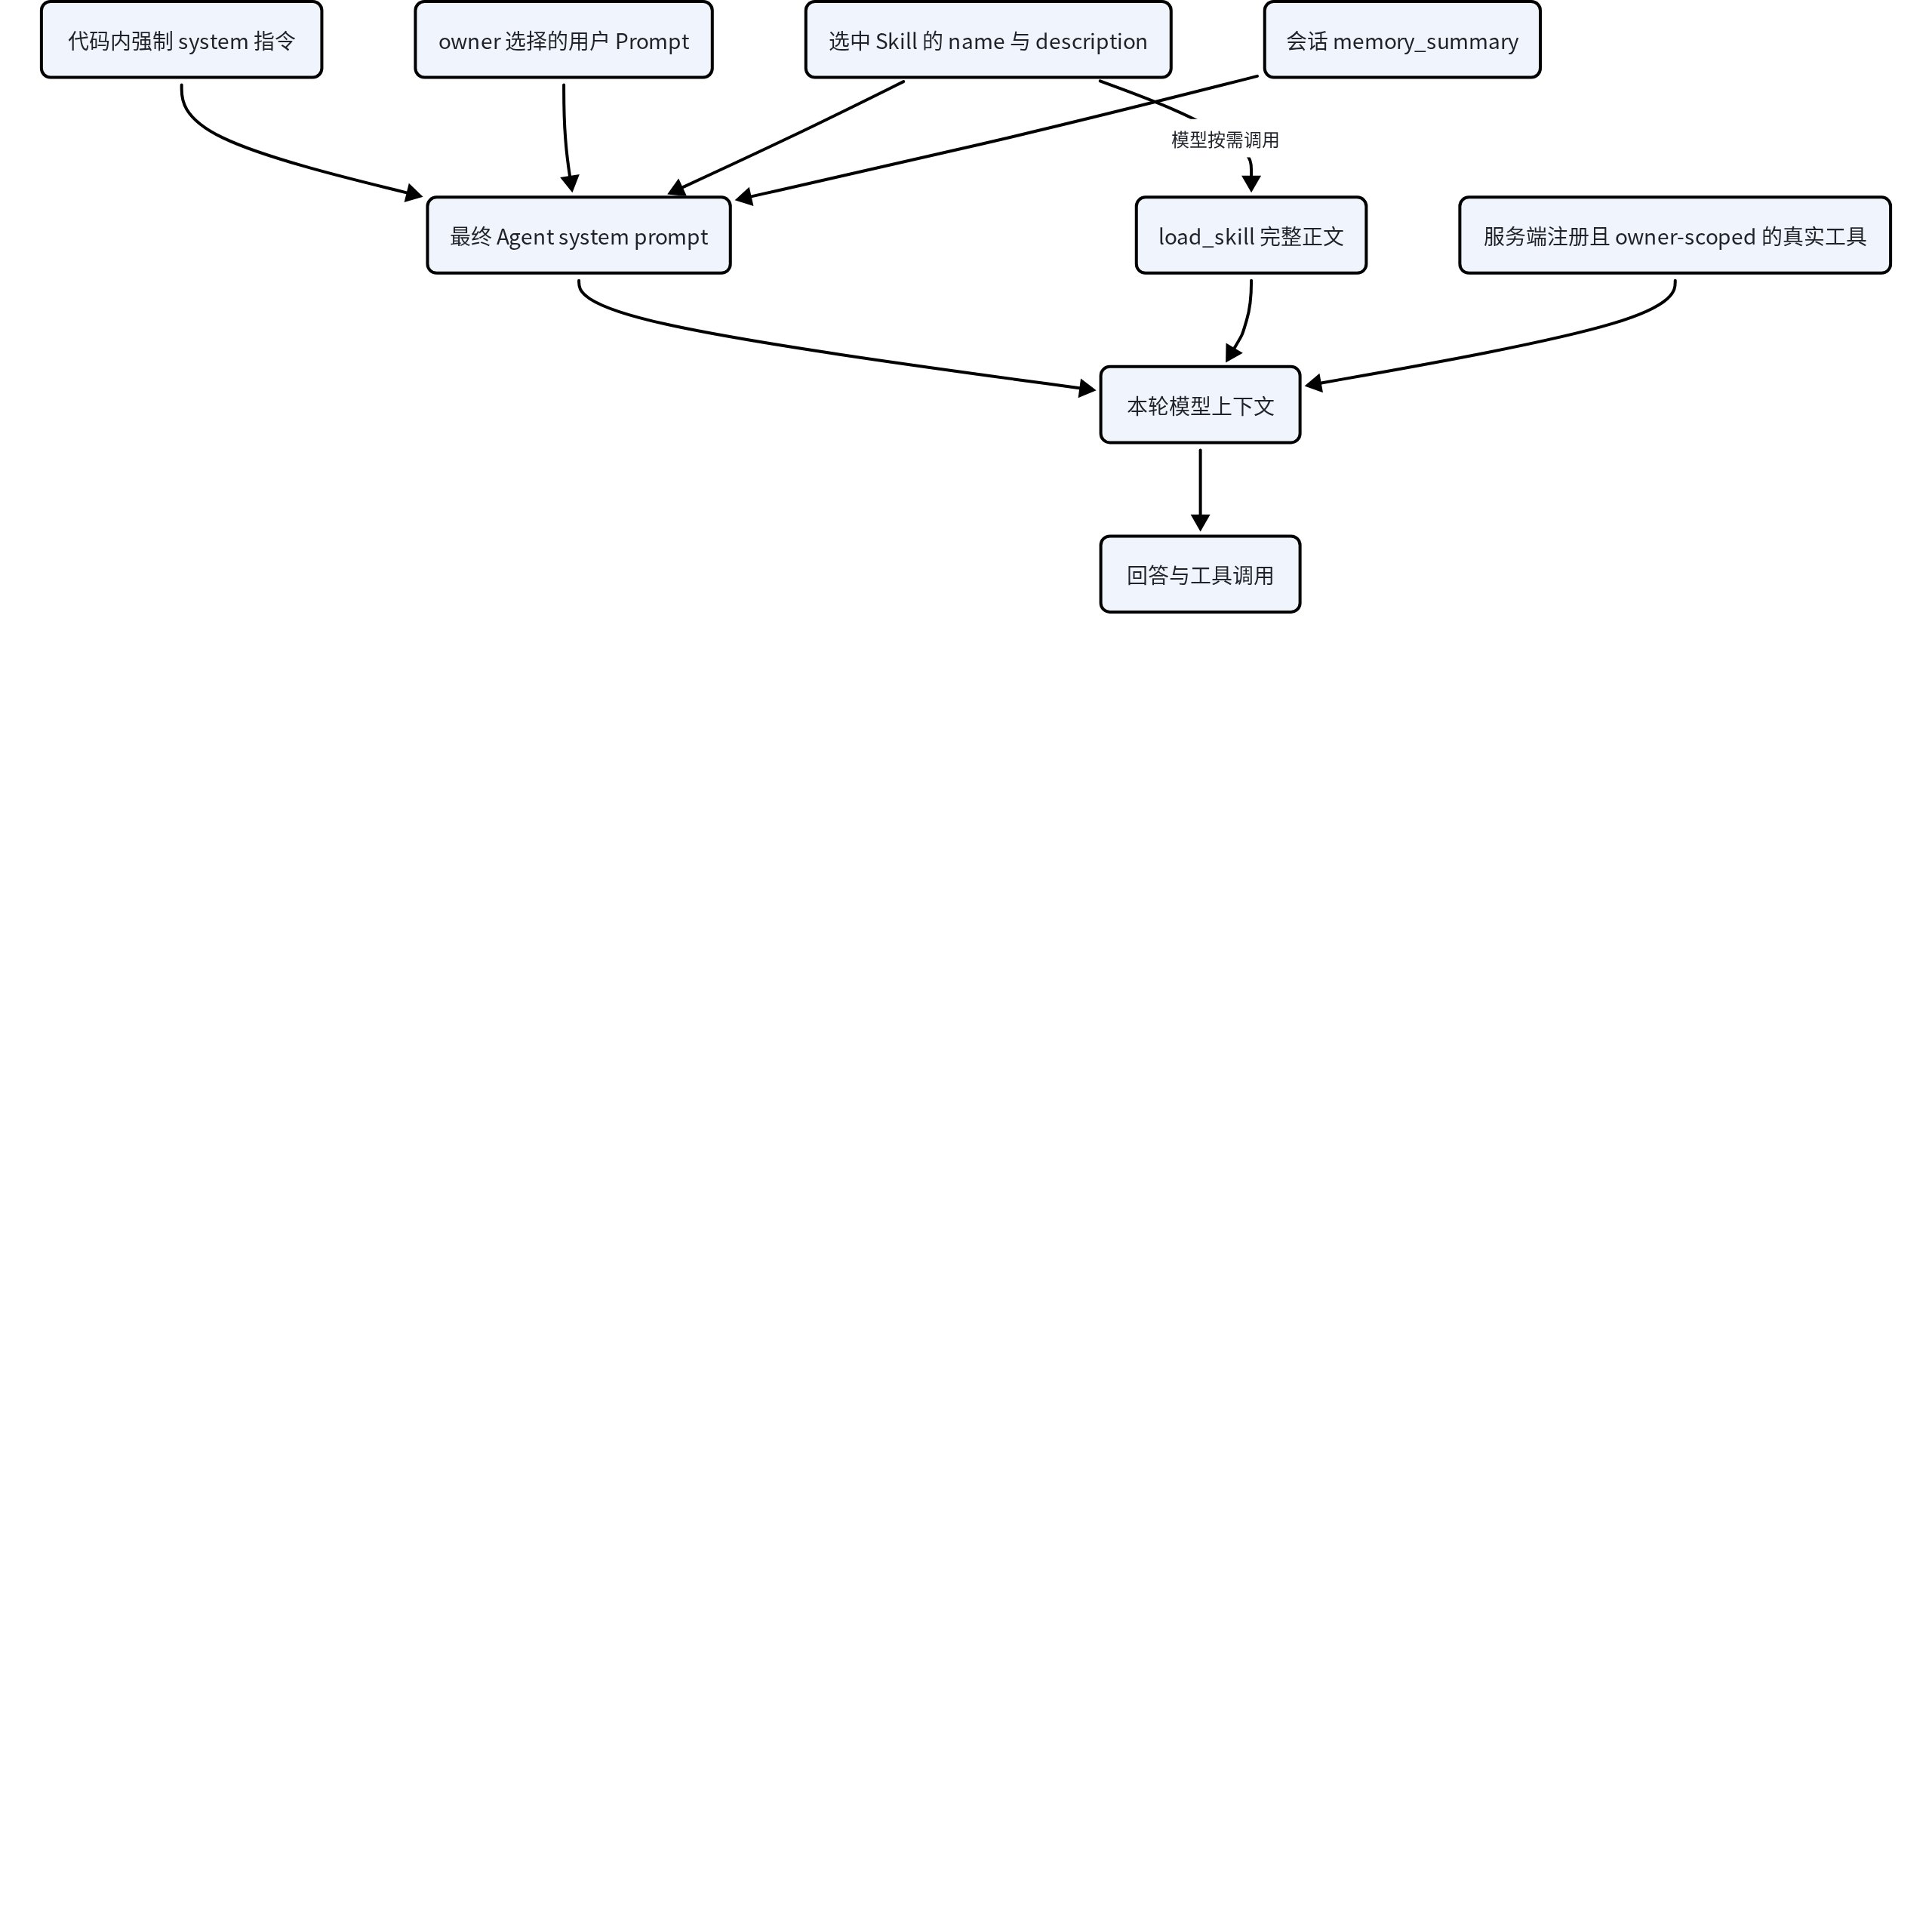
强制指令由代码控制;用户 Prompt 与 Skill 是 owner 资产;摘要是模型生成的历史压缩;真实工具权限仍由服务端注册和 tenant scope 决定。Skill 文本不能凭文字创建未注册工具或扩大知识库/MCP 范围,摘要也不能替代原消息、工具结果或引用证据。
强制 system 指令由代码维护,优先于用户资产;用户 Prompt 是用户主动选择的行为偏好;Skill 是按需加载的操作说明;memory_summary 是模型对历史的压缩表达。它们虽然都进入模型上下文,却来源不同。审计问题时应能回答某句话来自哪一层,不能把摘要当成用户原话,也不能把 Skill 指令当成已执行工具结果。
📷 [图片 token=USfibGLZwo41MfxHuu2cALB0ncd(未能下载,见飞书原文)]
Skill 内容在上传时只做格式和 metadata 校验,不做语义安全认证。用户可以上传影响 Agent 行为的文本,所以只有资产 owner 能选择它,load registry 也只包含当次 selection。强制指令要求不编造工具结果,实际工具仍由服务端注册与权限控制。Skill 无法凭文字创建一个未注册工具,也无法扩大知识库或 MCP 的 tenant scope。
Prompt 正文和 Skill 正文保存在本地 SQLite。配置响应会返回完整 Prompt content,便于编辑,但 Skill 响应只返回 description 作为 contentPreview。日志不应记录这些正文。当前没有资产版本历史:更新 Prompt 覆写同一记录,Skill 没有更新路由,修改需要删除后重新上传。既有聊天消息不会记录当时完整装配快照,因此回溯时可看到工具审计和消息 metadata,但不能仅凭当前 Prompt 证明历史请求使用了相同正文。
📷 [图片 token=OCFJbcomXo4HZIxBFaTc0Cd4n9b(未能下载,见飞书原文)]
数据、契约与状态
Prompt 记录包含 id、owner、label、content、is_default 和时间;Skill 记录包含 id、owner、filename、name、description、完整 content、size 和时间;选择记录包含 owner、system_prompt_id、skill_ids 与时间。三者是 user scope,不绑定某个会话。因此用户改选后,所有后续会话请求都会使用新配置。
memory_mode、memory_summary、compacted_message_count、context_tokens、last_compacted_at 位于 ChatSessionModel,是 session scope。共享响应的 memory 还包含 contextWindowTokens、contextUsagePercent 和 canCompact。摘要并不是一条 chat message,完整历史仍由 ChatMessageModel 保存;清空会话消息时,Repository 同时把摘要、边界、token 和最后压缩时间复位。
权限、安全与失败边界
配置、Prompt、Skill 路由全部依赖当前认证用户。Repository 的 get、list、update、delete 都过滤 owner;selection 更新前再次验证每个资产 ID。Skill registry 只从已经验证、仍存在、属于 owner 的 selection 构建;如果配置中遗留已删除 ID,build_agent_configuration 会过滤并回写有效列表。
记忆操作先按 owner 读取 session 和消息。跨用户更新模式或手动压缩返回 403。压缩调用真实聊天模型;模型失败或返回空摘要时,不会推进压缩边界。当前摘要是模型生成文本,代码没有把它标记为独立证据来源,因此后续回答仍应依赖持久消息、工具结果和引用,不应把摘要当作新事实。
📷 [图片 token=IOW6b8bNdo8AZMxktHScBti5nIg(未能下载,见飞书原文)]
渐进式 Skill 降低了初始 token 成本和不相关指令干扰,但不是代码级沙箱。Skill 是给 Agent 的文本指令,仍受强制 system prompt、工具权限、owner-scoped registry 和现有安全边界约束;上传成功不代表自动启用,仓库中的示例也不会在启动时自动导入。
阅读顺序与小结
先读
chat-configuration.ts与 models,区分资产、选择和会话状态。再读
validate_skill_upload与build_chat_system_prompt,理解输入与装配边界。随后跟进
build_agent_configuration和create_load_skill_tool,确认正文何时进入模型。最后逐行阅读
ChatMemoryService.prepare_message与_compact_messages,核对自动压缩、手动压缩和硬限制分支。
Prompt、Skill 和 memory 共同决定 Agent 上下文,却各自承担不同责任:Prompt 提供持续偏好,Skill 按需提供专业流程,memory 在不删历史的前提下压缩会话。OncallAgent 通过 user scope、session scope、渐进式工具和明确阈值把它们组合起来,使上下文工程成为可持久、可测试、可解释的运行机制。