OncallAgent 是本地优先 AIOps Agent 工作台,知识检索面对的内容既有自然语言,也有错误码、API 路径、服务名和中英文混排。纯向量检索擅长语义近似,却可能错过精确标识符;纯关键词检索能抓住错误码,却不理解同义表达。当前实现因此采用两路并行召回、RRF 融合和真实 rerank 的流水线。
📷 [图片 token=KBcZb7vwqoZKVFxaE6jcpp6WnJd(未能下载,见飞书原文)]
这条流水线不是聊天的固定前置步骤。知识能力被包装为 knowledge_retrieval LangChain Tool,只有 Agent 判断需要文档上下文时才调用。工具被创建时已经绑定当前用户和可访问知识库,模型可以选择 query、topK 和有限过滤器,却不能扩大权限范围。
📷 [图片 token=GlpPbmgjYoCsp3xsAJtcfkgSn3B(未能下载,见飞书原文)]
“混合检索”也不意味着某一路失败时尽量返回另一边。当前规格和代码选择严格一致性:embedding、Milvus 搜索、chunk 枚举、BM25 或 rerank 任一失败,整个工具返回安全系统错误;只有确实无匹配时才返回空 results。这个边界避免把粗排分数冒充最终相关性。
📷 [图片 token=EHGybSVD2ofLL7xZuAJcudmFnSe(未能下载,见飞书原文)]
学习目标
理解 Milvus 向量召回和进程内 BM25L 关键词召回如何并行。
掌握中文、运维标识符的确定性分词与 BM25 候选筛选。
手算
RRF(k=60)的排名贡献并理解去重。区分 vector、BM25、RRF、rerank 四类分数和三类一基排名。
识别 tenant 过滤、空知识库短路和失败不降级的安全边界。
功能入口与完整调用链
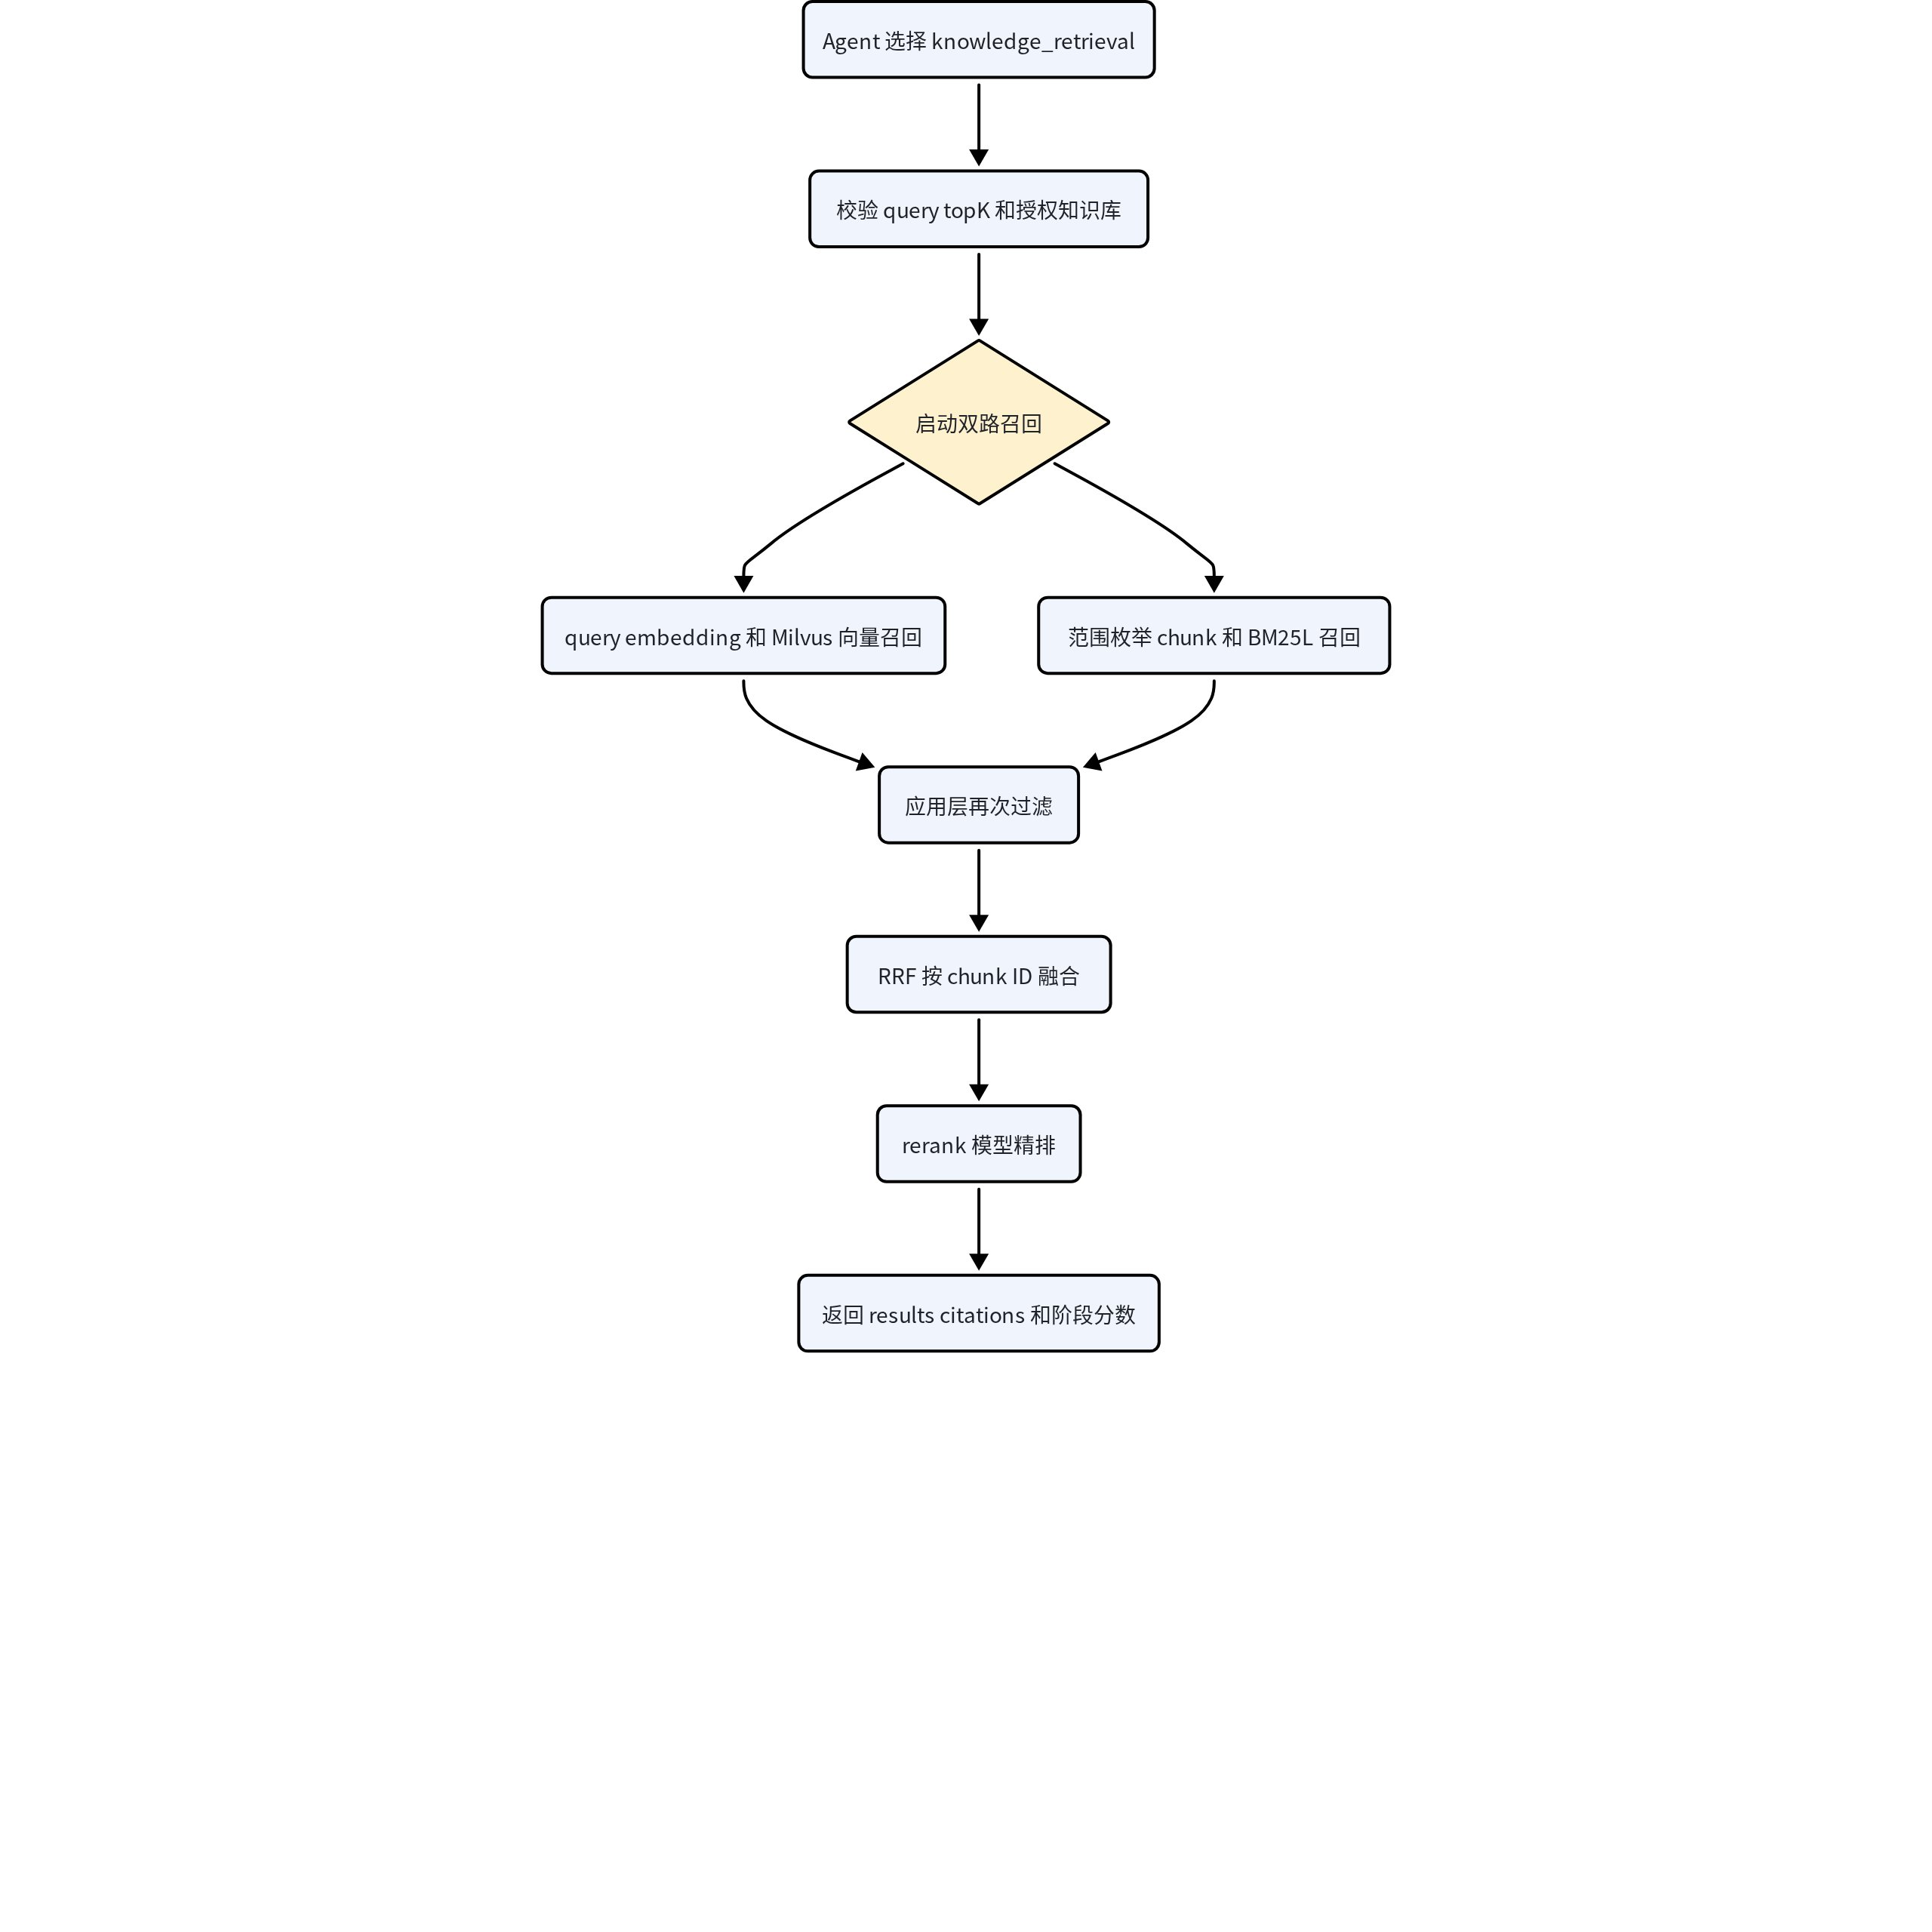
LangChainChatAgentRunner.stream 为每次聊天请求调用 create_langchain_knowledge_retrieval_tool。这个工厂闭包绑定 owner_user_id 与 accessible_knowledge_base_ids,生成结构化工具。模型调用后,KnowledgeRetrievalTool.run 先校验非空 query、把 topK 限制在最多 5,并验证请求知识库是否是可访问集合的子集。
📷 [图片 token=MFNqbaW71omhk8xddVzcVmEOnDd(未能下载,见飞书原文)]
只要至少存在一个授权知识库,run 就用 asyncio.gather 同时启动两条分支。向量分支把 query 送给 embedding,再调用 MilvusVectorStore.search_chunks,最多取 20 条;关键词分支通过 list_chunks 按 tenant 与知识库枚举标量 chunk,把内容载入当前进程,使用 BM25L 排出最多 20 条。
📷 [图片 token=B9VIbAnd5ohf03xVotKc02bznVf(未能下载,见飞书原文)]
两路结果再次执行 owner、tenant、知识库、document 和 metadata 过滤,然后以 chunk ID 做 RRF。最多 20 个融合候选被送到 QwenVlRerankModel.arerank,最终按 relevance_score 返回最多 5 条命中和一一对应引用。LangChain 事件适配器从 citations 生成 reference.source SSE,前端由 rerankScore 优先排序展示。
📷 [图片 token=VOOqbDi4loAxi4xZS7Ncau6nnVg(未能下载,见飞书原文)]
Agent 选择调用 knowledge_retrieval
  → 校验 query、topK、filters、可访问知识库
  → 并行:
      query embedding → Milvus COSINE 向量召回,最多 20
      scoped list_chunks → tokenize → BM25L,最多 20
  → 二次 owner / tenant / filter 校验
  → RRF(k=60) 按 chunkId 融合,最多 20
  → qwen3-vl-rerank
  → 最多 5 条 results 与 citations
📷 [图片 token=X1C8bqnBEoVbuvx81X8cSenwnue(未能下载,见飞书原文)]
核心源码地图
| 源码位置 | 关键符号 | 职责 |
|---|---|---|
apps/backend/src/super_ai/retrieval/tool.py | KnowledgeRetrievalTool、create_langchain_knowledge_retrieval_tool | 校验、双路并发、过滤、融合、精排及结构化输出。 |
apps/backend/src/super_ai/retrieval/hybrid.py | tokenize_hybrid_text、rank_bm25_documents、reciprocal_rank_fusion | 中英文运维文本分词、BM25L 与 RRF 原语。 |
apps/backend/src/super_ai/vector_store/milvus.py | MilvusVectorStore.search_chunks、list_chunks | 受范围约束的向量搜索与关键词语料枚举。 |
apps/backend/src/super_ai/vector_store/schema.py | build_chunk_collection_schema、build_index_definitions | 定义标量字段、JSON metadata、FLOAT_VECTOR 和 HNSW 等索引。 |
apps/backend/src/super_ai/memory/vector_scope.py | build_milvus_tenant_filter | 构造 tenant 与允许知识库 ID 的 Milvus 布尔表达式。 |
apps/backend/src/super_ai/llm/rerank.py | QwenVlRerankModel、RerankResult | 调用 qwen3-vl-rerank,有限重试并严格校验返回结构。 |
packages/api-contracts/src/retrieval.ts | KnowledgeRetrievalHit、KnowledgeRetrievalCitationSource | 共享分阶段排名、分数和引用字段。 |
packages/api-contracts/src/sse.ts | ReferenceSourceSseEvent | 让检索解释信息通过聊天或诊断流传到前端。 |
apps/backend/tests/test_hybrid_retrieval.py | test_rrf_combines_shared_candidates_with_k_60_and_deterministic_order | 验证分词、非负 BM25 与确定性 RRF。 |
apps/backend/tests/test_knowledge_retrieval_tool.py | test_vector_and_bm25_recall_execute_concurrently | 验证并发、过滤、上限、失败边界和 LangChain 绑定。 |
openspec/specs/knowledge-retrieval-tool/spec.md | Two-stage reranked retrieval | 规定 20 条粗召回、RRF、真实 rerank 与最多 5 条输出。 |
📷 [图片 token=KkdzbV0omoYRrvxApXgcXh6jnlb(未能下载,见飞书原文)]
代码调用流程图
混合检索的关键不是把两个分数相加,而是先并行获得不同类型的候选,再用 RRF 统一排名,最后交给 rerank 模型精排。
📷 [图片 token=BAOJbBzq1oKjXGxapkPchREAnFg(未能下载,见飞书原文)]
关键实现拆解
Milvus 向量召回与范围过滤
**看什么:**看 Milvus 搜索在连接前处理空知识库范围,并把 tenant 与允许知识库集合编译成服务端 filter,而不是先做无范围 ANN 再丢弃结果。
        # 1. 空授权集合直接短路,不连接 Milvus。
        if not knowledge_base_ids:
            return []
        client = self._connection_manager.connect()
        search_result = client.search(
            collection_name=self._settings.collection_name,
            data=[list(query_vector)],
            anns_field=VECTOR_FIELD,
            # 2. tenant 与知识库范围进入 Milvus 查询表达式。
            filter=build_milvus_tenant_filter(
                tenant_id=tenant_id,
                knowledge_base_ids=knowledge_base_ids,
            ),
            limit=limit,
            search_params={
                "metric_type": self._settings.metric_type,
                "params": dict(self._settings.search_params),
            },
            output_fields=list(OUTPUT_FIELDS),
            timeout=self._settings.timeout_seconds,
        )
        return [_search_hit_to_result(hit) for result_set in search_result for hit in result_set]
📷 [图片 token=AeCSbNHxgorQ5mx3ByXc2uU3ncg(未能下载,见飞书原文)]
范围过滤发生在 ANN 搜索本身,随后工具层还会检查 ownerUserId、tenantId 与知识库 ID,形成存储与应用双层防御。配置决定向量维度、metric 和 search params;调用失败会上升为安全系统错误,不会退化成不带向量证据的伪精排结果。
📷 [图片 token=ETmlbChXhoHVwNxyyygcgYYan8c(未能下载,见飞书原文)]
文档索引写入的 collection 包含 chunkId、documentId、knowledgeBaseId、ownerUserId、tenantId、content、source、createdAt、metadata 和 vector。默认设置由项目配置加载,主规格要求默认 1024 维、HNSW、COSINE;实际 schema 使用配置维度,vector 索引和搜索参数也来自配置,而不是在检索代码里写死。
📷 [图片 token=S9vMbTokronTL4xRR3uc7nNpnub(未能下载,见飞书原文)]
search_chunks 在知识库列表为空时直接返回空,不连接 Milvus,也不发无范围查询。非空时,filter 形如 tenantId 等于当前用户且 knowledgeBaseId 位于允许集合,搜索只返回 OUTPUT_FIELDS 标量和 score。工具层随后还通过 _filter_chunks 检查 ownerUserId 与 tenantId 都等于当前用户,并应用 documentIds 和精确 metadata 键值过滤。这是存储过滤与应用防御的双层边界。
📷 [图片 token=N74bbbYsAoYb6Exl5EKcs9bYnmf(未能下载,见飞书原文)]
向量分支先调用 embedding 的 aembed_documents,且必须只得到一个 query vector。Milvus 搜索由 asyncio.to_thread 承载同步客户端调用,避免直接阻塞事件循环。向量候选上限是 RERANK_CANDIDATE_LIMIT,当前为 20。
📷 [图片 token=Xb6qbq7gbowFljxfguqcJXZ5nMc(未能下载,见飞书原文)]
BM25L:从 scoped chunks 建立临时词法语料
**看什么:**看 BM25L 前的 token 交集门槛和确定性排序;这两个细节防止 delta 常量把完全不含查询词的文档带入候选。
    # 1. 中英文混合查询先进入同一确定性 tokenizer。
    query_tokens = tokenize_hybrid_text(query)
    if not query_tokens or not documents or limit < 1:
        return []
    corpus_tokens = [tokenize_hybrid_text(document) for document in documents]
    scorer = _create_bm25_scorer(corpus_tokens)
    scores = scorer.get_scores(query_tokens)
    query_token_set = set(query_tokens)
    # 2. 至少有一个真实 token 交集才允许成为候选。
    ranks = [
        Bm25Rank(index=index, score=float(scores[index]))
        for index, tokens in enumerate(corpus_tokens)
        if query_token_set.intersection(tokens)
    ]
    # 3. 同分时回到原始语料顺序,保证结果可重复。
    ranks.sort(key=lambda item: (-item.score, item.index))
    return ranks[:limit]
📷 [图片 token=EkjJbiBcVot0h2xhVCYcN8i9nHg(未能下载,见飞书原文)]
关键词分支的 documents 已经由 owner、tenant、知识库、documentIds 和 metadata 过滤,因此其他租户文本不会参与 IDF 统计。语料每次从 Milvus 标量字段枚举并临时建 scorer,没有持久 BM25 索引或缓存;枚举失败会让整个混合检索失败。
📷 [图片 token=Hta2bfarCoOZwzxfIuXcEIQ4nDe(未能下载,见飞书原文)]
BM25 语料不是另一份长期索引。list_chunks 使用 Milvus query iterator,每批 1000 条,枚举当前 tenant 和知识库的标量字段,不读取 vector。返回的 StoredVectorChunk 内容在当前工具调用中进入进程内列表,rank_bm25_documents 动态构建 rank_bm25.BM25L scorer。因此“内存 BM25L”指临时计算路径,不代表 SQLite 中维护了一套持久倒排索引。
📷 [图片 token=OaUIb5D7oo4j6XxOPZHcTCwDnXc(未能下载,见飞书原文)]
tokenize_hybrid_text 对 ASCII 运维标识符保留字母数字及点、下划线、冒号、斜杠、连字符组合并转小写,例如错误码和 v1/chat 不会被简单打散。连续中文同时产生单字和相邻双字 token,增强“超时错误”等短语匹配。排序前还要求 query token 与文档 token 至少有交集,因此未命中内容不会仅靠 BM25L 的 delta 常量混入候选。
📷 [图片 token=OZJzbpT57oRFHGx8U8JcFJ3Dnle(未能下载,见飞书原文)]
BM25 候选按分数降序、原始序号升序确定性排序并截断为 20。使用 BM25L 的一个具体目标是保持小语料精确命中的正分,并避免高频查询词产生负贡献;相关性质由 test_bm25_small_corpus_uses_positive_idf_for_exact_identifier 和 test_bm25_high_frequency_terms_never_create_negative_scores 固化。
📷 [图片 token=JTj1bIYUSoJANdxILSTcPUGqngg(未能下载,见飞书原文)]
RRF 融合与真实 rerank
**看什么:**看粗召回候选如何先融合、空候选如何短路,再把文本交给真实 rerank;最终顺序不由 COSINE、BM25 或 RRF 任一原始分数冒充。
        # 1. RRF 只使用阶段排名,不直接比较两种原始分数量纲。
        candidates = _fuse_candidates(
            vector_hits=filtered_vector_hits[:RERANK_CANDIDATE_LIMIT],
            keyword_chunks=filtered_keyword_chunks,
            bm25_ranks=bm25_ranks,
        )
        if not candidates:
            return KnowledgeRetrievalToolResult(
                query=query, top_k=top_k, results=[], citations=[]
            )
        try:
            # 2. rerank 决定最终顺序,top_n 不超过候选数量。
            rankings = await self._rerank_model.arerank(
                query=query,
                documents=[candidate.chunk.content for candidate in candidates],
                top_n=min(top_k, len(candidates)),
            )
        except Exception as exc:
            raise KnowledgeRetrievalError(
                code="SYSTEM_UNAVAILABLE",
                message="Knowledge reranking is temporarily unavailable.",
            ) from exc
📷 [图片 token=HZvLbqAgzogadtxL7ctc2tuTnZu(未能下载,见飞书原文)]
没有候选时不调用 rerank,也不生成回退正文;rerank 异常统一变成安全的不可用错误。有效返回中的 relevance_score 才成为最终 score,且 provider 的 index 必须映射回当前候选,不能用粗排分数补造精排成功。
📷 [图片 token=KUxabJuSRo0xiKxkgk1cvYSanlc(未能下载,见飞书原文)]
RRF 不直接比较 COSINE score 和 BM25 score,因为两者量纲不同。reciprocal_rank_fusion 对每路列表先去重,再按一基 rank 累加 1 / (60 + rank)。例如一个 chunk 在向量第 2、BM25 第 1,其融合分是 1 / 62 + 1 / 61。共享候选通常因获得两路贡献而上升,单路候选仍可进入融合。
📷 [图片 token=VWQ5biRz5okCAgxlx7nc8oRqnp1(未能下载,见飞书原文)]
同分时,代码先比较两路中更靠前的 rank,再按 chunk ID,保证结果可重复。融合记录保留 vector_rank、bm25_rank 和 rrf_score,同时从原始两路字典带出 vector_score 与 bm25_score。没有在某一路命中的字段保持空值,不会伪造 0 分或虚假排名。
📷 [图片 token=Xv2SbEFt9oWghzxqnQLcSZ1xn2B(未能下载,见飞书原文)]
融合顺序仍只是粗排。QwenVlRerankModel 向配置 endpoint 发送 query 和候选文本,要求 top_n 合法;对 429、服务端错误和传输异常执行有限指数等待。返回必须包含不重复、在输入范围内的 index,以及 0 到 1 的有限 relevance_score。结果按相关性降序,最终 score 等于 rerank_score,rerank_rank 表示输出位置,不是 provider 的输入 index。
📷 [图片 token=NqEkb3pENomRkkxYHQMct1bTnAb(未能下载,见飞书原文)]
用一个运维查询手算候选流转
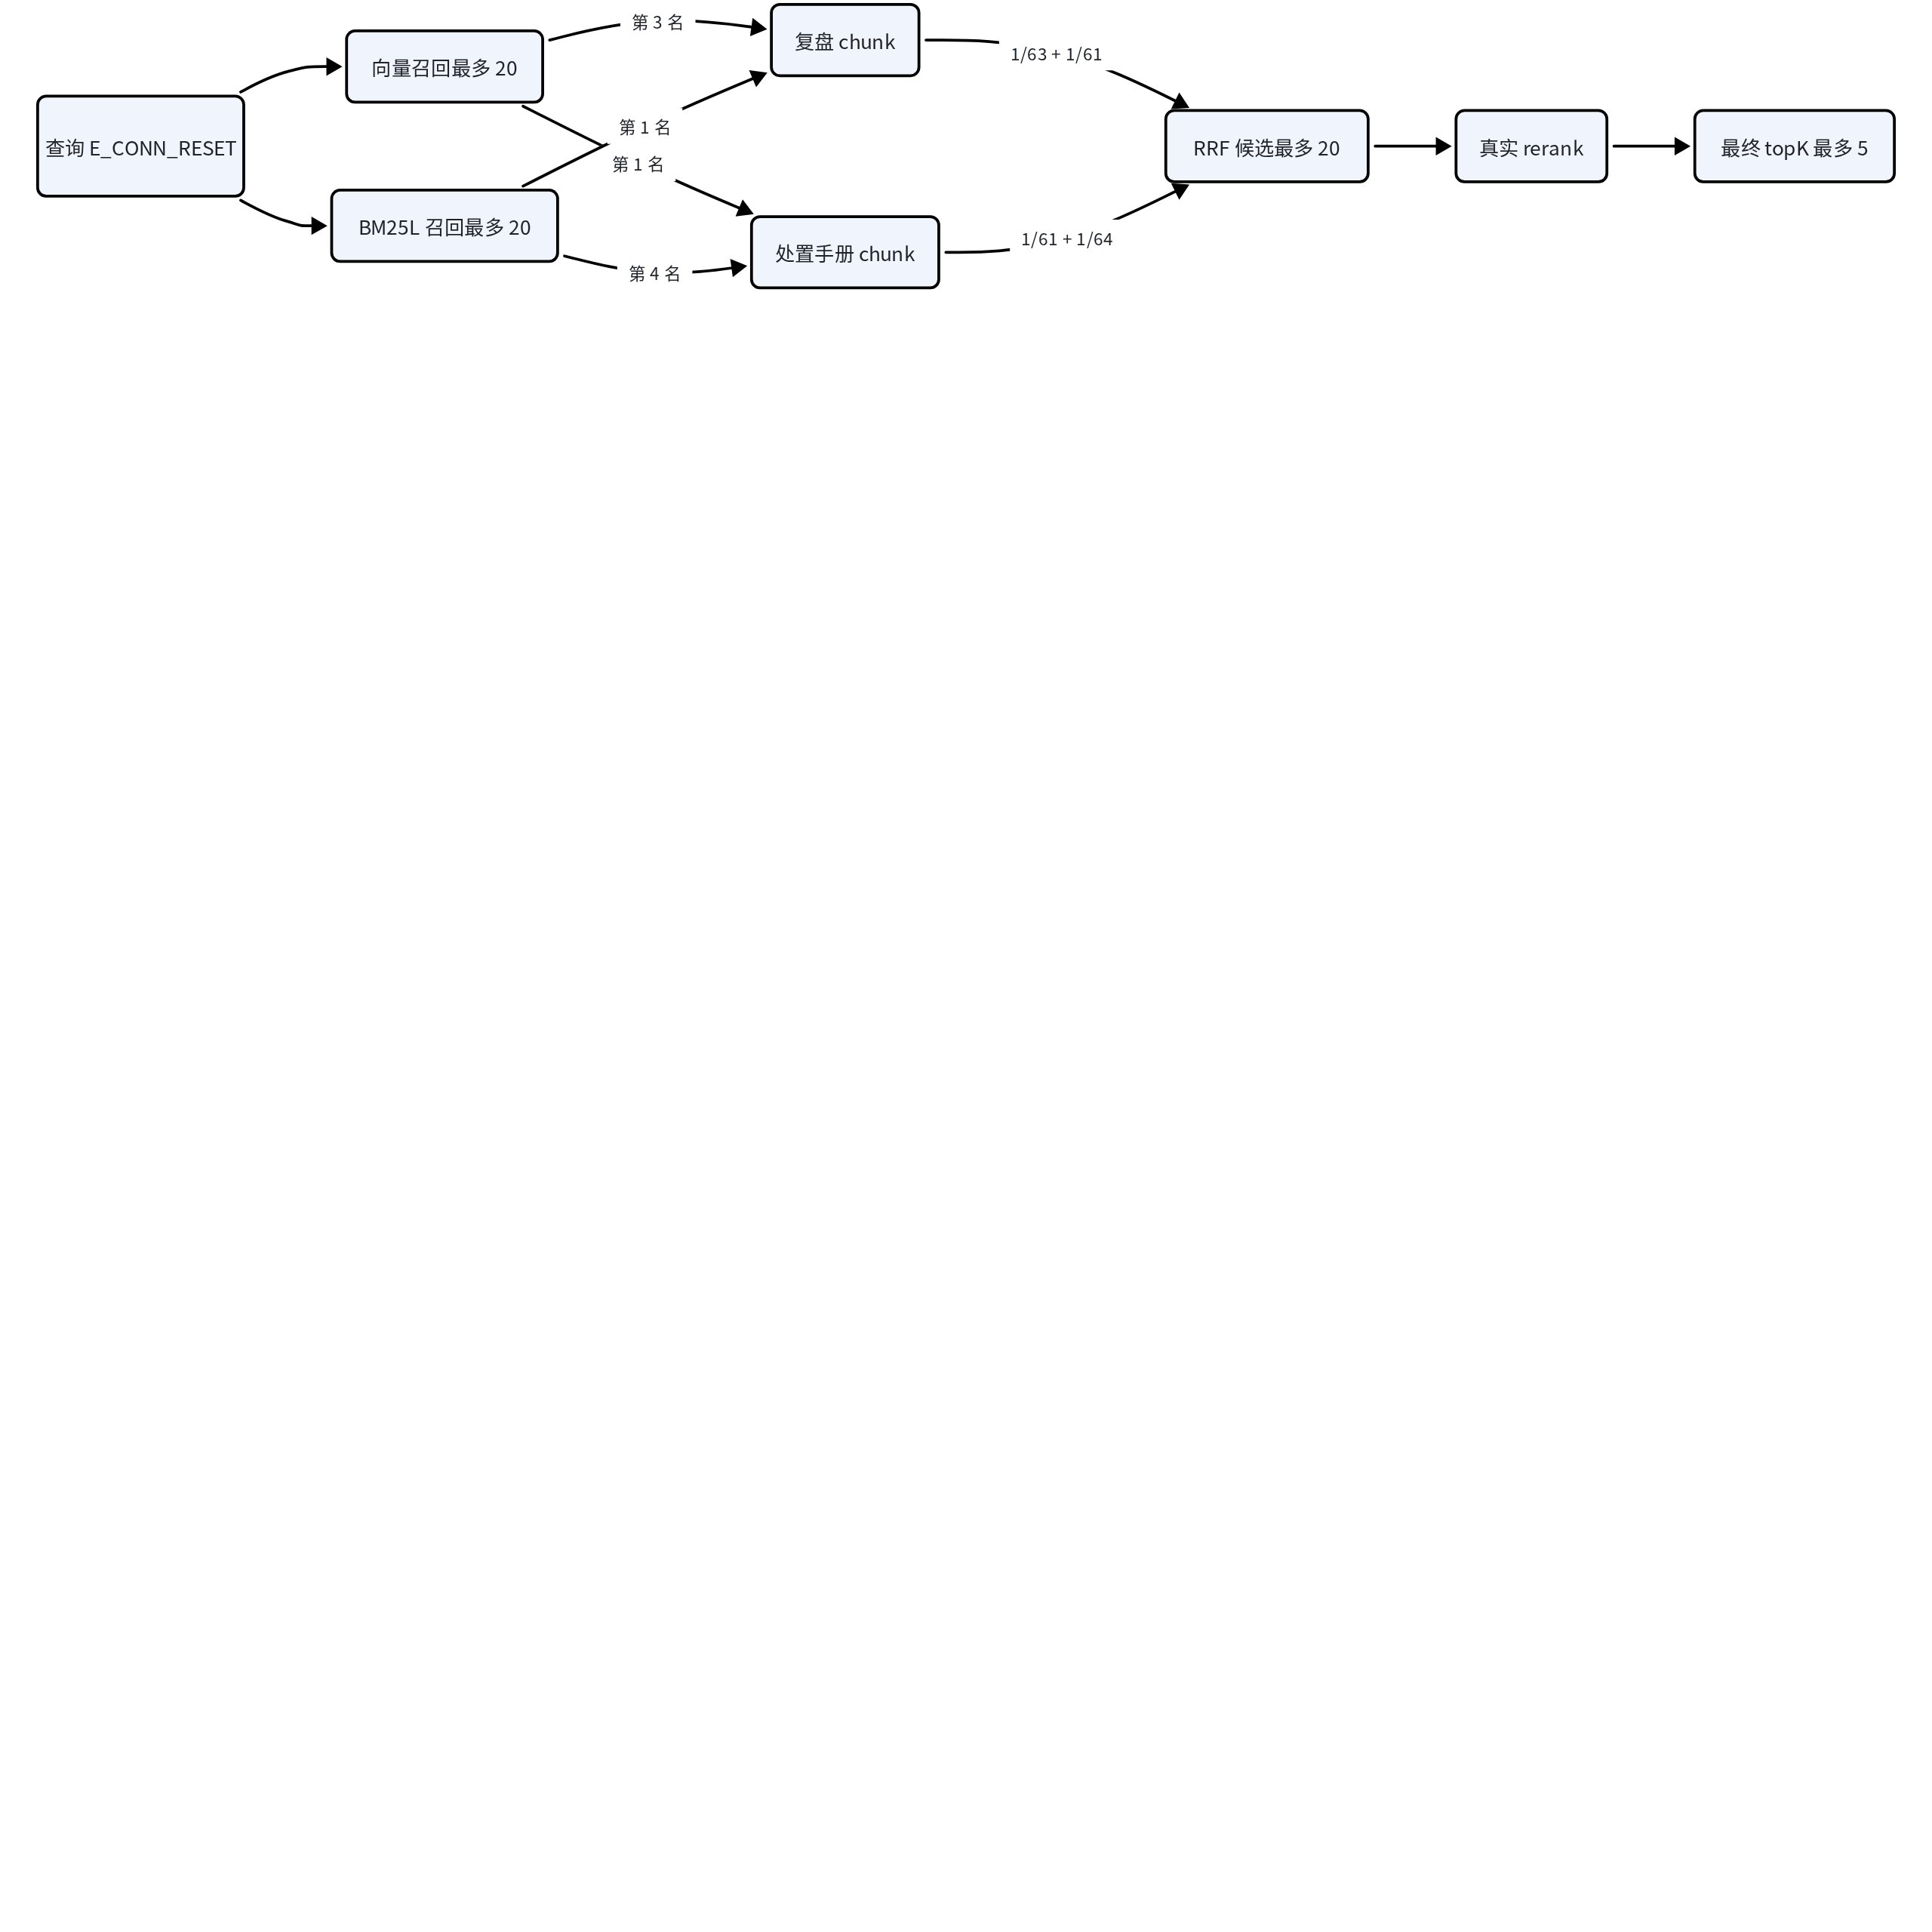
**看什么:**用这张局部候选图追踪同一个 chunk 在两路名次、RRF 和 rerank 中的位置变化;数字只是文中示例,公式与阶段顺序对应真实实现。
📷 [图片 token=R90FbMmrroa8p5xBSRNcaZC6nUd(未能下载,见飞书原文)]
RRF 奖励两路一致但不锁定最终顺序;只在单路命中的候选也进入并集。rerank 可以把精确错误码复盘提到第 1,最终 rerankRank 必须表示输出位置,未命中阶段的 rank 和 score 保持空值。
📷 [图片 token=KzHDblkcpo2dy6xVeWrco8hSnFg(未能下载,见飞书原文)]
假设用户问“api-gateway 出现 E_CONN_RESET 如何恢复”。向量分支可能把语义相近的“网关连接重置处置手册”排第 1,把包含精确错误码的复盘排第 3;BM25L 分支则可能把错误码复盘排第 1,把处置手册排第 4。复盘的 RRF 分为 1 / 63 + 1 / 61,手册为 1 / 61 + 1 / 64。RRF 用名次而非原始分数,让两路不同量纲都能贡献。
📷 [图片 token=OMP9bEylDoiM6AxPJlxcJdqenCb(未能下载,见飞书原文)]
如果另一个 chunk 只在 BM25L 第 2 出现,它仍获得 1 / 62 并进入候选;未命中的 vectorRank 和 vectorScore 保持空。反之,语义命中但不含查询 token 的 chunk 也可仅靠向量分支进入。这正是混合召回比简单交集更有价值的地方:并集保证覆盖,RRF 奖励多路一致。
📷 [图片 token=SmxobaybaoBWv1xqhLGczOGkndb(未能下载,见飞书原文)]
rerank 接收的是 RRF 排序后的文本数组,但 provider 可以完全改变顺序。例如只在 BM25L 命中的精确错误码文档,可能最终被判为最相关并得到 rerankRank 1。工具按 provider 返回 index 重新引用原候选,随后显式枚举 rerankRank。最终展示必须以 rerank 排名为准,同时保留粗召回排名解释“它为何进入候选”。
📷 [图片 token=VbS6bqtVjoyFDvxrekacxnCBnHt(未能下载,见飞书原文)]
过滤器在哪个阶段生效
**看什么:**看应用层过滤器同时核对存储范围字段、可选 documentIds 和浅层 metadata 精确等值,而不是把模型提供的任意表达式交给 Milvus。
    allowed_knowledge_base_ids = set(knowledge_base_ids)
    requested_document_ids = set(filters.document_ids)
    # 1. ownerUserId 与 tenantId 必须同时匹配当前用户。
    return [
        hit
        for hit in hits
        if hit.owner_user_id == owner_user_id
        and hit.tenant_id == owner_user_id
        and hit.knowledge_base_id in allowed_knowledge_base_ids
        and (not requested_document_ids or hit.document_id in requested_document_ids)
        and _metadata_matches(hit.metadata, filters.metadata)
    ]

def _metadata_matches(
    hit_metadata: Mapping[str, object],
    required_metadata: Mapping[str, str | int | float | bool],
) -> bool:
    # 2. metadata 仅支持浅层键值精确匹配。
    return all(hit_metadata.get(key) == value for key, value in required_metadata.items())
📷 [图片 token=FLItbI93iocboox7HyRcb2Zvnvc(未能下载,见飞书原文)]
这段过滤会同时用于向量 hits 和 BM25 语料,保证两路候选语义一致,并避免越权文档改变词法统计。它不支持范围、数组包含、嵌套路径或自定义查询语法;越权 knowledgeBaseIds 更早就在外部资源访问前被整体拒绝。
📷 [图片 token=QgfdbhWqKoyozVx2RuzcZ86Nnwd(未能下载,见飞书原文)]
knowledgeBaseIds 先与服务端 accessible set 比较,越权时整个调用在外部资源访问前结束。合法范围传给 Milvus 的 search 与 list,因此两路初始语料都已受 tenant 和知识库限制。documentIds 与 metadata 不被拼进当前 Milvus filter,而是在工具层对向量 hits 和枚举 chunks 做精确过滤,再进行 RRF。这保证两路过滤语义一致。
📷 [图片 token=HDLjbWS5towM4MxVlGicLXCunib(未能下载,见飞书原文)]
metadata 匹配采用 hit_metadata.get(key) == value,是浅层精确等值,不支持范围、数组包含、模糊匹配或嵌套路径。布尔值、数字和字符串来自共享契约;调用者不能通过 metadata 请求任意表达式。这个限制降低了模型生成危险查询语法的风险,也意味着复杂检索条件需要未来明确扩展类型和测试。
📷 [图片 token=EPX5bfKoIoiPbQx7OSwcNe5snzc(未能下载,见飞书原文)]
向量结果即使来自带 Milvus filter 的查询,仍会被应用层检查 ownerUserId 与 tenantId。这能防御脏数据或错误写入。关键词分支在 BM25 前过滤,避免无权限文本参与词频统计;否则即使最终结果被过滤,其他租户文档也可能通过 IDF 改变排名。当前顺序把权限隔离同时落实到数据可见性和排序统计。
📷 [图片 token=CxyqbQF3GocmpuxUC3qcFZ2knDe(未能下载,见飞书原文)]
候选解释字段如何进入聊天引用
**看什么:**看最终 hit 与 citation 如何共享同一批阶段字段;citation 是结构转换,不会重新搜索或再次排序。
    result = candidate.chunk
    # 1. 兼容 score 明确等于最终 rerank_score。
    return KnowledgeRetrievalHit(
        chunk_id=result.chunk_id,
        # … 省略与本节无关的身份、正文和 metadata 字段
        score=rerank_score,
        vector_rank=candidate.vector_rank,
        bm25_rank=candidate.bm25_rank,
        rerank_rank=rerank_rank,
        vector_score=candidate.vector_score,
        bm25_score=candidate.bm25_score,
        rrf_score=candidate.rrf_score,
        rerank_score=rerank_score,
    )

def _citation_from_hit(hit: KnowledgeRetrievalHit) -> KnowledgeRetrievalCitationSource:
    # 2. citation 直接复制同一 hit 的阶段解释字段。
    return KnowledgeRetrievalCitationSource(
        id=hit.chunk_id,
        title=hit.source or hit.document_id,
        source_type="knowledge-base",
        # … 省略与本节无关的展示字段
        vector_rank=hit.vector_rank,
        bm25_rank=hit.bm25_rank,
        rerank_rank=hit.rerank_rank,
        vector_score=hit.vector_score,
        bm25_score=hit.bm25_score,
        rrf_score=hit.rrf_score,
        rerank_score=hit.rerank_score,
    )
📷 [图片 token=SIpnbDp1ro7N4IxnKxFcQKN9nbd(未能下载,见飞书原文)]
结果与引用共用 chunk 身份和分阶段排名,因此聊天适配器可以把 citation 转成 reference.source 而不丢失召回路径。excerpt 只为展示截断,Agent 使用的 hit.content 仍是完整 chunk;高分解释相关性,不等于证明运维根因。
📷 [图片 token=AzYhbKZKNoGV9Mxll3OcuwHAned(未能下载,见飞书原文)]
_hit_from_fused_candidate 把 rerank score 同时写入 score 与 rerank_score,并保留三类 rank。_citation_from_hit 不是重新计算,而是从同一个 hit 派生 title、sourceType、excerpt 和阶段字段,因此 results 与 citations 不会因为二次排序而错位。citation ID 基于 chunk,能与工具结果和前端反馈关联。
📷 [图片 token=E72IbqU81oGrt3xk7Q0c5K1TnfG(未能下载,见飞书原文)]
当 LangChain 工具完成时,聊天适配器读取 output.citations,把字段转换为 reference.source。前端引用排序优先 rerankScore,并最多展示 5 条。这条链路让用户能看到“最终相关性”和“召回路径”,但分数仍是模型与检索算法输出,不是因果证明。AIOps 结论还需要结合真实工具结果和持久证据,不能仅凭高 rerankScore 宣称根因成立。
📷 [图片 token=EPagbY7dhoWVuMx8Vl1cMAAunzh(未能下载,见飞书原文)]
excerpt 截断只服务展示,Agent 工具结果中的 hit.content 仍包含完整 chunk。metadata 可能带 headingPath、chunkingStrategy、knowledgeType 等索引信息。前端应优先使用结构化字段呈现来源,不应把 metadata 原样序列化成大段 JSON;现有聊天组件测试正是围绕可读引用详情而不是原始对象展开。
📷 [图片 token=RFsNbvz9rojgydxnqmrcNL5Onfa(未能下载,见飞书原文)]
性能与一致性的当前取舍
**看什么:**把最初集中展示的并行召回代码放到性能主题中看:两路共享相同范围,但 gather 只降低串行等待,不减少任一路工作量。
        try:
            # 1. 两路召回共享 query、owner 与授权知识库范围。
            vector_hits, keyword_recall = await asyncio.gather(
                self._vector_recall(
                    query=query,
                    owner_user_id=owner_user_id,
                    knowledge_base_ids=knowledge_base_ids,
                ),
                self._keyword_recall(
                    query=query,
                    owner_user_id=owner_user_id,
                    knowledge_base_ids=knowledge_base_ids,
                    filters=filters,
                ),
            )
        except KnowledgeRetrievalError:
            raise
        except Exception as exc:
            # 2. 任一路失败都会使整次混合检索安全失败。
            raise KnowledgeRetrievalError(
                code="SYSTEM_UNAVAILABLE",
                message="Knowledge retrieval is temporarily unavailable.",
            ) from exc
📷 [图片 token=Qly9b2sryoDvcWxFod9caIXRnT0(未能下载,见飞书原文)]
当前规范要求粗召回不可用时不得静默退化为单路,所以 gather 中任一基础设施异常都会终止本次调用。同步 Milvus 和 BM25 工作被送入线程以免阻塞事件循环,但线程中的调用不会因请求取消而变成可回滚事务。
📷 [图片 token=OO9NbOzV3oGVoSxcilDclQN3n4e(未能下载,见飞书原文)]
双路并发缩短了串行等待时间,但并不减少工作量。向量分支需要一次 query embedding 和一次 ANN 搜索,关键词分支需要枚举授权范围内全部标量 chunks 并在进程内建 BM25L。小型本地知识库下实现简单、结果新鲜;语料增长后,枚举和 scorer 构建可能成为主要成本。
📷 [图片 token=Zs8xbeOJWo0A14xxHwKc1rhGnCf(未能下载,见飞书原文)]
当前没有 BM25 cache。每次工具调用都从 Milvus 重新读取,所以刚完成索引或删除后的词法语料能及时反映存储状态,也避免维护第二套一致性协议。代价是重复查询。未来若加缓存,缓存键至少需要 tenant、知识库集合和索引版本,失效还要覆盖文档覆盖、删除与重建;只按 query 缓存会破坏权限和新鲜度。
📷 [图片 token=FNyTbcY4fo9vdnxvBv0ckV6dnzh(未能下载,见飞书原文)]
两路 asyncio.gather 中,向量 embedding 是异步 provider 调用,Milvus 与 BM25 同步工作通过 thread 执行。这个设计让事件循环保持响应,但线程并不把底层调用变成可取消事务;请求取消时,已经进入的同步 Milvus 查询可能仍运行到客户端超时。超时和重试由各 provider 设置控制,而不是 retrieval tool 自己提供统一总时限。
📷 [图片 token=YZD9bAKxAo1hbpx9Vc9ciWtNnke(未能下载,见飞书原文)]
空结果、错误与“没有证据”
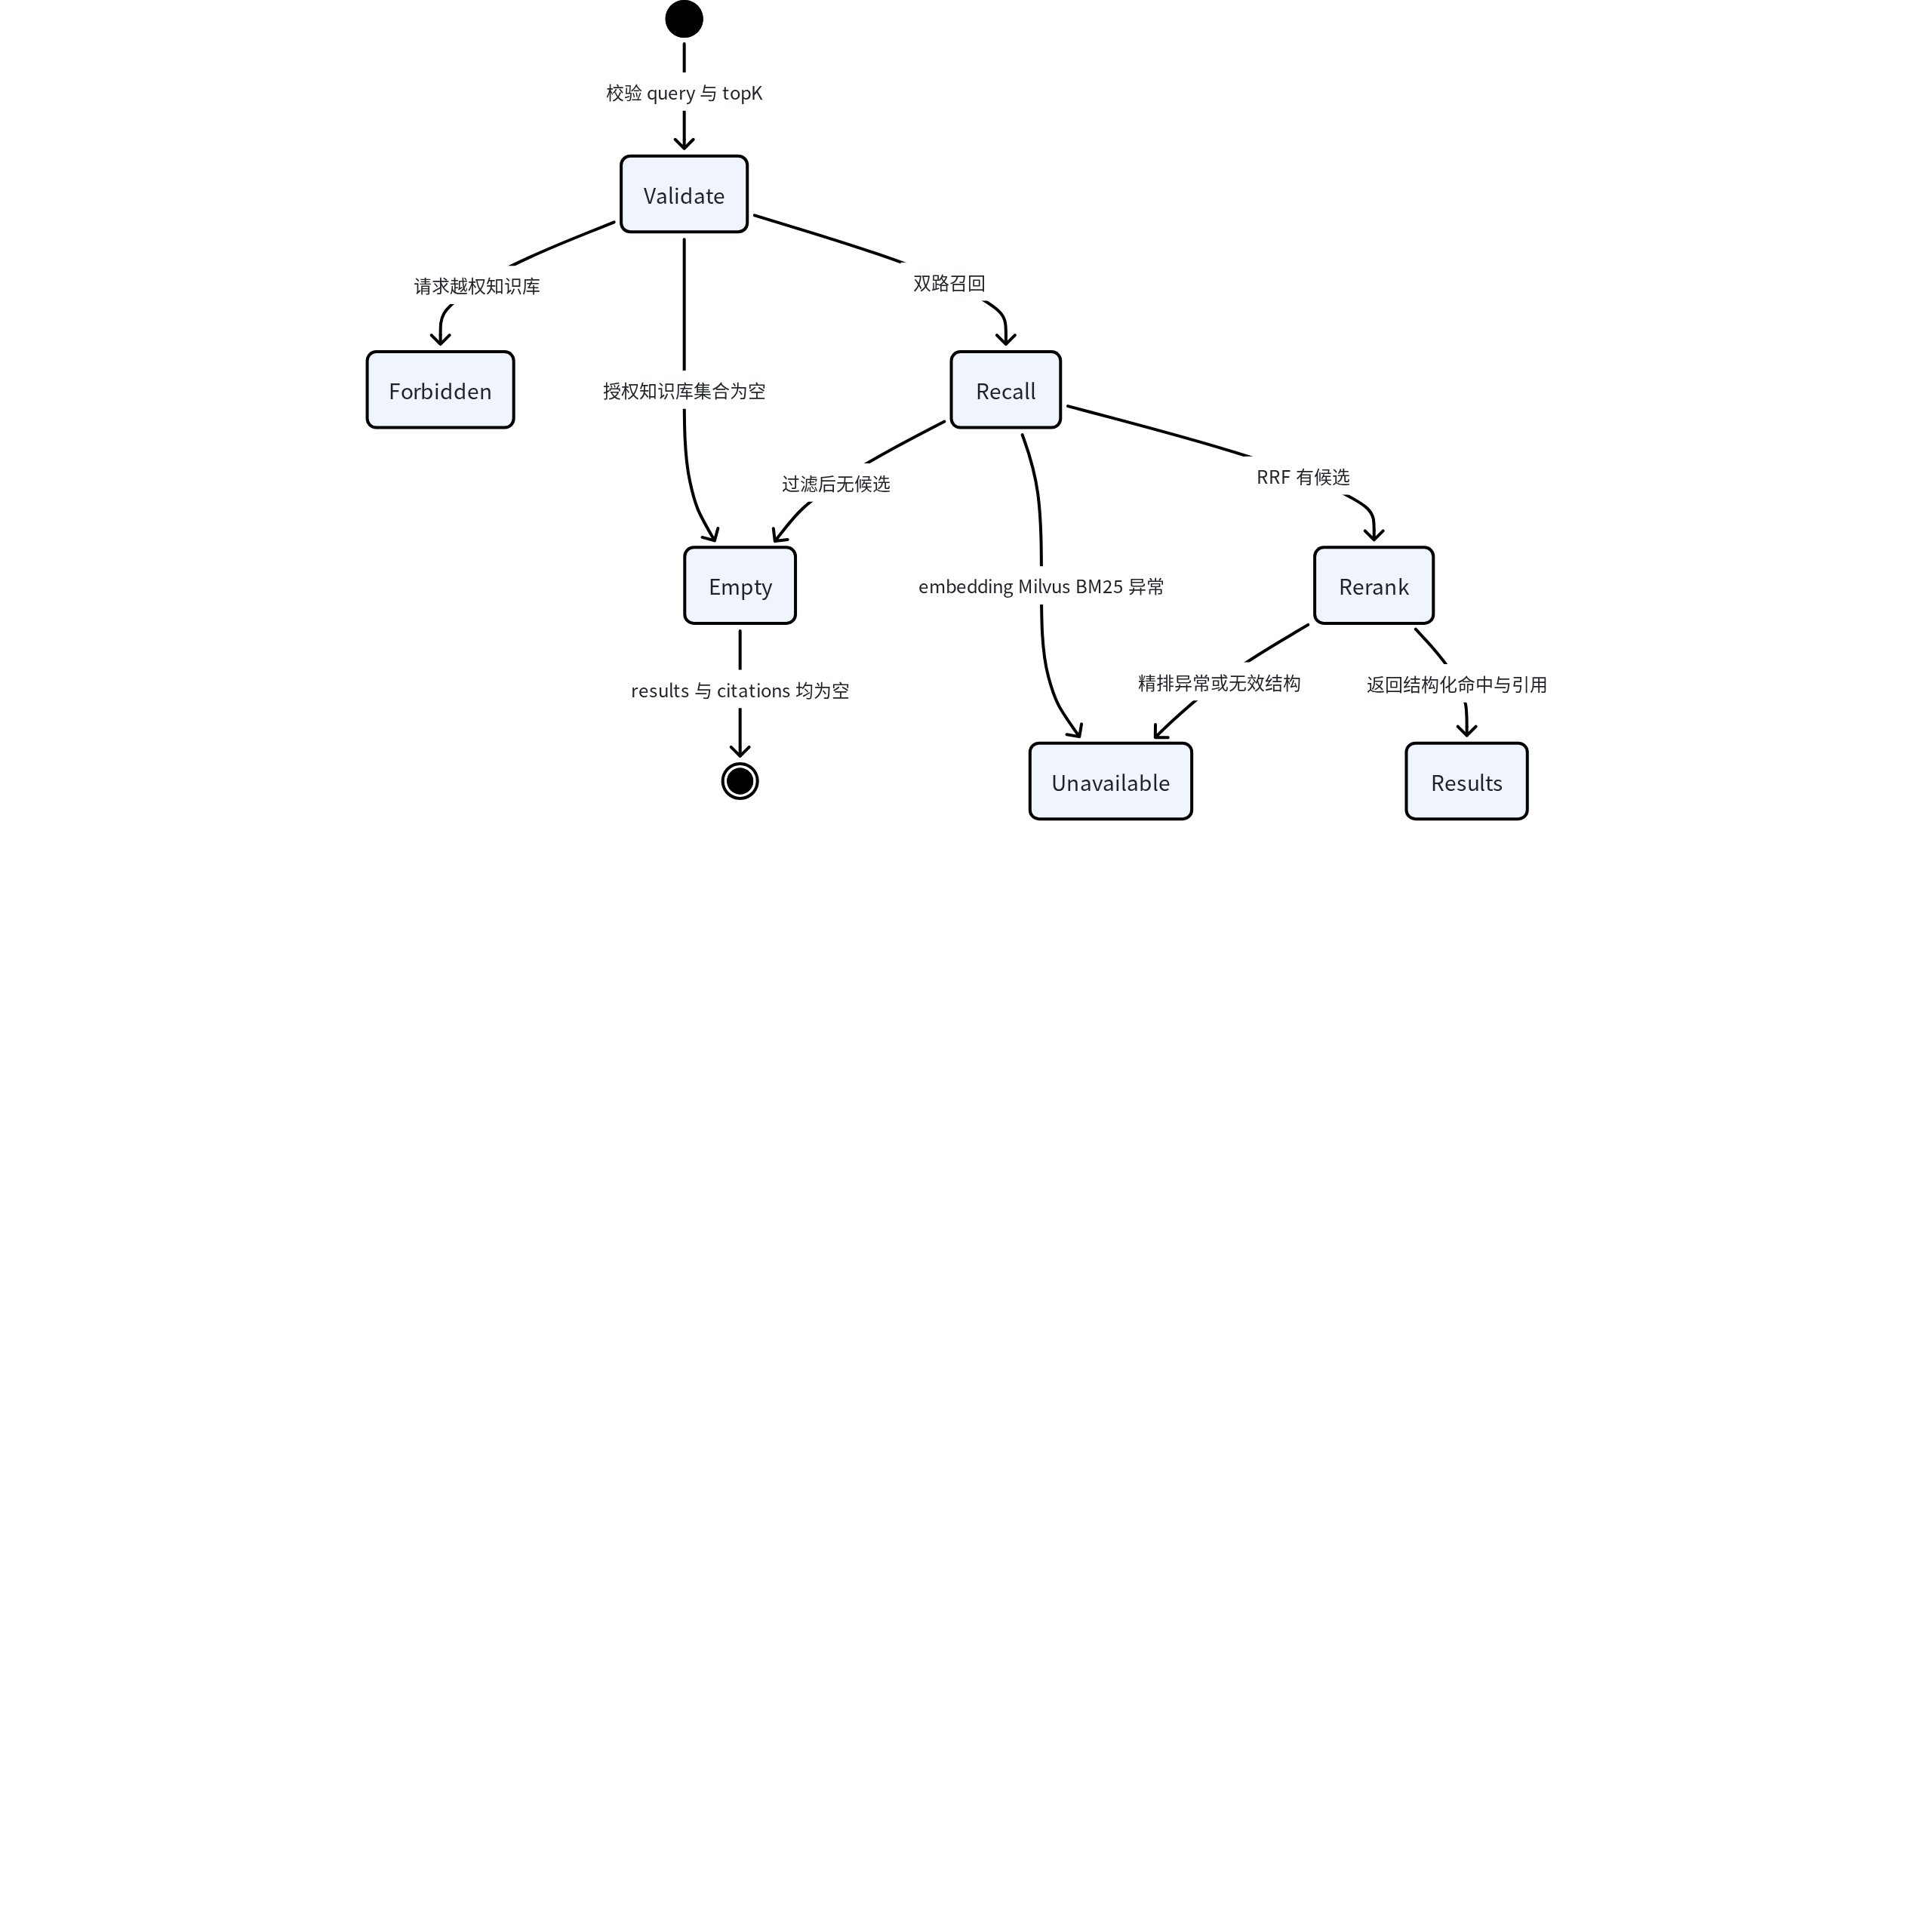
**看什么:**这张状态图把“成功但无命中”和“执行失败”分成不同终点;只有前者能被解释为当前授权范围内没有检索结果。
📷 [图片 token=LZwrbNYU6oED0bxFXQicoAlgnDb(未能下载,见飞书原文)]
Empty 是正常成功结果,不调用 rerank,也不生成文档内容;Forbidden 和 Unavailable 是错误,不能被 Agent 改写成“知识库没有证据”。未完成索引的文档本来就不在 Milvus 中,所以空结果也不能证明某个已上传但 failed 的文档不包含答案。
📷 [图片 token=X7YwbcS8touzOCxIvVAcUzM9nwe(未能下载,见飞书原文)]
空结果有两种正常来源:授权后没有任何知识库,或者两路召回都没有通过过滤的候选。第一种在 embedding 和 Milvus 之前短路,第二种在 RRF 前后得到空集合;二者都返回原 query、规范化 topK、空 results 和空 citations,不调用 rerank。Agent 应据此说明未找到知识依据,而不是由工具补写一段看似合理的文档内容。
📷 [图片 token=OPFwbUbqyoqAUlxnUWoc9vVKnFd(未能下载,见飞书原文)]
无效 query、topK 或越权过滤属于调用错误,分别使用验证或授权代码。基础设施异常属于系统不可用。代码有意不把 provider 原始错误拼进公开 message,测试会注入带秘密标记的异常并断言未泄露。区分空结果与系统错误非常重要:前者是成功执行后的“无命中”,后者表示当前检索结论不可信,不能被解释成知识库确实没有相关内容。
📷 [图片 token=EUD9b00S4oeCJexVLiIcznlxngg(未能下载,见飞书原文)]
rerank 返回空列表在结构上可以形成空最终结果,但 provider 返回格式错误、重复 index、越界 index、非有限分数或超出 0 到 1 的分数会被 LlmRerankError 拒绝。工具不自行修补这些数据。严格校验保护 citation 与输入候选的映射,防止某个错误 index 把另一个 tenant 范围内不可见的问题外推为引用错配。
📷 [图片 token=KGKKb9dCUomcZzxhkoIc7LZpnrb(未能下载,见飞书原文)]
检索工具描述是“搜索当前用户已索引的知识库文档”。未完成索引的 SQLite 文档不会出现在 Milvus,failed 文档也没有可靠的新 chunks;工具不会读取上传 metadata 来生成临时候选。换言之,文档管理页面的 indexed 状态是检索可用性的前提之一,混合算法不能补偿上游索引失败。
📷 [图片 token=R2zJbJJB6o20ckxrb0lcnJnwnIc(未能下载,见飞书原文)]
数据、契约与状态
一个最终 hit 同时携带 chunk、document、knowledge base、owner、tenant、content、source、metadata 和解释字段。vectorRank、bm25Rank、rerankRank 是一基排名;vectorScore 是 Milvus 向量得分,bm25Score 是 BM25L 分数,rrfScore 是倒数排名贡献之和,rerankScore 是最终模型相关性。不能跨阶段比较这些数值大小。
📷 [图片 token=Oc5WbnlriocZAtxyn0Dcf7fNnkA(未能下载,见飞书原文)]
topK 默认 5,输入小于 1 是验证错误,超过 5 会被硬限制到 5。RRF 候选最多 20,最终没有额外最低分阈值。results 和 citations 一一对应;citation 的 excerpt 最多 480 个字符,并保留同样的阶段分数与排名,以便 UI 展示可追溯依据。
📷 [图片 token=D3Jxbo043oLdvuxZfJWc0S0wn9g(未能下载,见飞书原文)]
权限、安全与失败边界
_resolve_knowledge_base_ids 先对可访问列表去重。模型不传过滤器时使用全部可访问知识库;传入时必须是子集,任何越权 ID 都触发 AUTH_FORBIDDEN,且不会调用 embedding、Milvus search 或 list。授权后集合为空则直接返回空 results 和 citations。
📷 [图片 token=AaP7bXIWforT23xpUA2cQL3EnJf(未能下载,见飞书原文)]
双路通过 asyncio.gather 并发,但这也意味着任一分支失败都会取消当前完整结果。工具把未知粗召回异常转换为 SYSTEM_UNAVAILABLE 和固定安全消息。rerank 失败单独映射为知识精排暂不可用,绝不回退成 vector-only、BM25-only 或 RRF-only。空候选则不调用 rerank,诚实返回空集合。
📷 [图片 token=ZmVMbJPlHoeajrxCCpPcavrdnVh(未能下载,见飞书原文)]
当前 BM25L 每次枚举授权范围内全部 chunks,复杂度会随单个用户语料增长;它不是无界全租户读取,因为 Milvus filter 始终存在,但也尚未实现持久倒排索引或增量词法索引。评估大规模数据时必须把这个现实成本纳入设计。
📷 [图片 token=IuDpbVgkgofdl3x91soc6EZXnhh(未能下载,见飞书原文)]
阅读顺序与小结
先读
retrieval.ts,明确每个排名和分数字段的含义。再读
vector_scope.py与 Milvus 的 search、list,确认语料范围。随后结合
apps/backend/src/super_ai/retrieval/hybrid.py手算 tokenize、BM25 和 RRF。最后沿
KnowledgeRetrievalTool.run跟到 rerank、citation 和 LangChain Tool。
这条混合检索链路的价值不只是更高召回率,而是把每一阶段的作用和证据分开:Milvus 找语义,BM25L 找词项,RRF 融合排名,rerank 决定最终顺序。严格的 owner scope、空结果和失败不降级规则,让这些分数可以被解释,而不会变成看似精确的伪证据。
📷 [图片 token=Tz0ebm8XYoHmPpxzux1c1U3DnUg(未能下载,见飞书原文)]