在 OncallAgent 这个本地优先 AIOps Agent 工作台中,知识文档不是“上传完就可以检索”。一次成功上传只说明文件通过校验、可索引文本已提取、元数据已写入 SQLite;只有后续后台索引完成,chunk 向量才进入 Milvus,文档才真正具备检索能力。
📷 [图片 token=JiukbqqNOo8oKAxCA1acepX1nOe(未能下载,见飞书原文)]
当前链路刻意把上传、预览和索引拆开。上传负责建立可重复处理的事实记录,预览复用与索引相同的 chunking 实现,索引任务则异步执行切分、embedding、范围删除与批量写入。这样既能让 API 快速返回,也能把真实失败持久化到任务和文档状态中。
📷 [图片 token=ZZyNbpuWMopAhXxaCV0cgK4hnnb(未能下载,见飞书原文)]
对 AI Native 开发者而言,这条链路最重要的启示是:页面上的“正在索引”不能只靠一个前端布尔值模拟,成功也不能以“请求已接受”代替。文档状态、任务状态和 durable job 状态是三个相互关联但不同的层次。
📷 [图片 token=SddqbCrsnolDYMxboPrc1qTlnJd(未能下载,见飞书原文)]
学习目标
理解 Markdown、PDF 上传校验和文本提取的真实边界。
掌握三种持久化 chunking 策略及有界预览。
追踪 202 索引任务从 pending 到 running、succeeded 或 failed 的过程。
理解重建索引、失败重试、覆盖上传和删除时的向量清理。
正确解释前端轮询、业务任务状态和文档 indexStatus。
功能入口与完整调用链
前端入口是 /knowledge,由 apps/frontend/src/views/KnowledgeView.vue 展示知识库、上传区、文档列表和详情。useKnowledgeStore 调用 createKnowledgeClient:先向 POST /knowledge-bases/{knowledge_base_id}/documents 发送 multipart 文件和 chunking JSON;上传成功后请求 chunk preview,再调用文档的 /index-tasks 创建首次索引任务。
📷 [图片 token=GTOVb31TzoLY30x4a8icYhTMnGb(未能下载,见飞书原文)]
后端 upload_knowledge_document 先通过 _validate_upload 检查扩展名、MIME 和 10 MiB 大小限制,再由 extract_indexable_text 提取正文。Markdown 必须是 UTF-8 且非空;PDF 使用 pypdf.PdfReader 逐页提取可选择文本,扫描图片型 PDF 没有文本时会被拒绝。服务计算 SHA-256,按 owner、knowledge base、hash 查重,把正文和 chunking 配置保存到文档 metadata。
📷 [图片 token=JjCJbl8ysogzknx3qaNc2cIsnNd(未能下载,见飞书原文)]
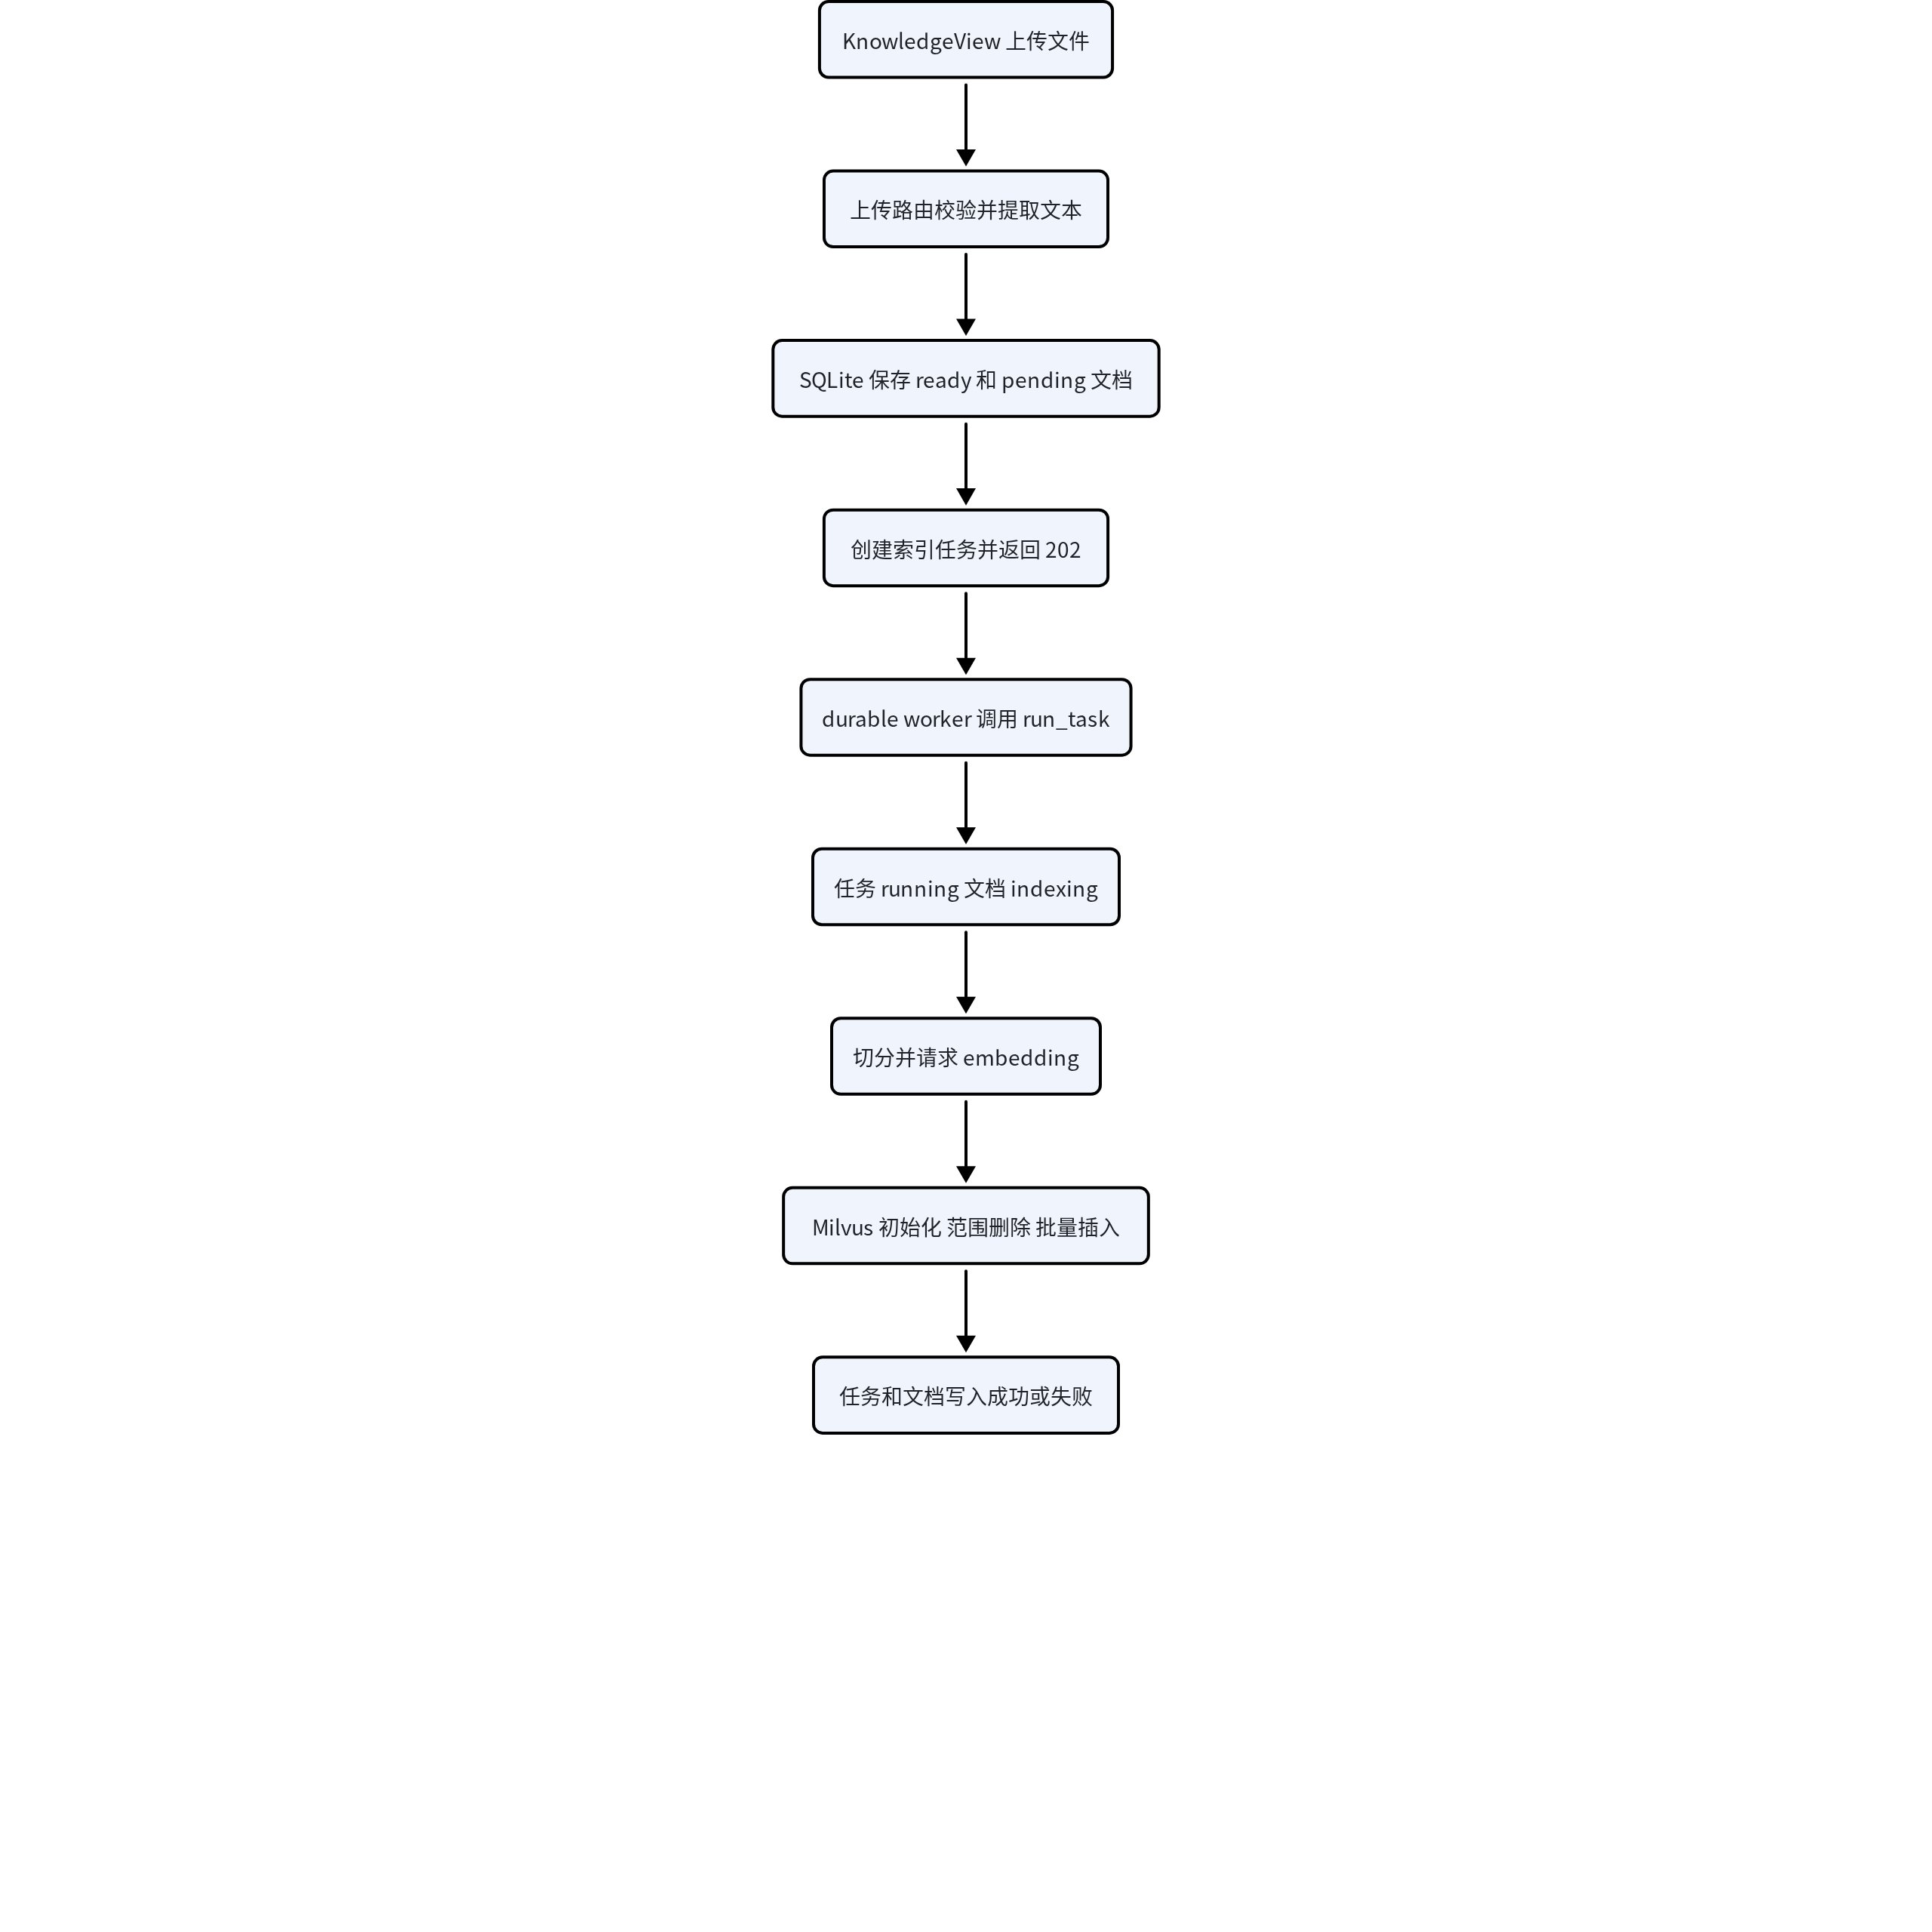
索引 API 创建 DocumentIndexTaskRecord 后立即调度 durable job 并返回 HTTP 202。后台 handler 调用 DocumentIndexingService.run_task,读取同一 owner 下的文档,按持久化策略切分,批量请求 embedding,初始化 Milvus,删除该文档旧 chunks,插入新 chunks,最后同步更新任务和文档的索引状态。
📷 [图片 token=JXGebYszUo3356x02ozcyAB8nGg(未能下载,见飞书原文)]
KnowledgeView
  → knowledgeClient.uploadDocument
  → upload_knowledge_document
  → 文件校验、文本提取、SHA-256、SQLite 文档记录
  → chunk-preview
  → create_document_index_task 返回 202
  → DurableDocumentIndexTaskScheduler
  → DocumentIndexingService.run_task
  → chunk → embedding → Milvus initialize/delete/insert
  → task succeeded 或 failed,document indexed 或 failed
📷 [图片 token=Ntn7b9Wyso0GUxxNCkRci69RnRb(未能下载,见飞书原文)]
核心源码地图
| 源码位置 | 关键符号 | 职责 |
|---|---|---|
apps/backend/src/super_ai/api/app.py | upload_knowledge_document、get_document_chunk_preview、create_document_index_task、retry_document_index_task | 受保护上传、预览、创建任务、读取状态和失败重试路由。 |
apps/backend/src/super_ai/documents/extraction.py | extract_indexable_text | 区分 Markdown UTF-8 解码与 PDF 文本提取。 |
apps/backend/src/super_ai/documents/policy.py | DOCUMENT_MAX_SIZE_BYTES、允许扩展名与 MIME 常量 | 定义后端上传策略。 |
apps/backend/src/super_ai/documents/indexing.py | DocumentIndexingService、chunk_document_text、DocumentChunk | 确定性切分、embedding 和范围向量重建。 |
apps/backend/src/super_ai/memory/sqlite.py | SQLiteKnowledgeDocumentRepository、文档索引任务 Repository | 持久化文档元数据、状态、失败原因与重试来源。 |
apps/backend/src/super_ai/vector_store/milvus.py | MilvusVectorStore.insert_chunks、delete_document_chunks | 批量写入以及 tenant、知识库、文档三重范围删除。 |
packages/api-contracts/src/documents.ts | KnowledgeDocument、DocumentChunkingConfiguration、DOCUMENT_UPLOAD_POLICY | 共享文档、状态、策略和预览形态。 |
packages/api-contracts/src/indexing.ts | DocumentIndexTask、DocumentIndexTaskStatus | 共享任务状态、失败原因和 retryOfTaskId。 |
apps/frontend/src/stores/knowledge.ts | useKnowledgeStore、trackIndexTask、refreshIndexTask | 上传编排、2 秒轮询、重建、重试和页面错误反馈。 |
apps/backend/tests/test_document_indexing.py | test_document_indexing_service_writes_scoped_chunks_and_marks_success | 验证服务写入 owner-scoped chunks 并转换真实状态。 |
openspec/specs/document-indexing-jobs/spec.md | Non-blocking indexing execution | 规定非阻塞、可恢复、失败可重试的索引任务。 |
📷 [图片 token=MJImbl1RJofNR1xvL5gcKu9Tnbg(未能下载,见飞书原文)]
📷 [图片 token=BZZdb7V32oXUXJx3lXucEqxsnGh(未能下载,见飞书原文)]
📷 [图片 token=RWF6bOyp4oWvbax2UL2cICBpnbg(未能下载,见飞书原文)]
📷 [图片 token=E6iRbrUmhoHXDDxU0XzcHFr4nBf(未能下载,见飞书原文)]
代码调用流程图
上传、任务受理和向量写入是三个不同阶段。流程图把 201、202 与最终 indexed 状态对应到不同源码节点。
📷 [图片 token=AsBnbE0HfoIMryxzg8mc9l39n3c(未能下载,见飞书原文)]
📷 [图片 token=UnA4bkpaFo7R76xq8dZcFInynNf(未能下载,见飞书原文)]
关键实现拆解
上传不是索引:先保存可重复处理的输入
**看什么:**看上传路由如何先验证和提取文本,再用 owner 与知识库范围查内容哈希;只有这些输入持久化后,后续索引任务才有可重复读取的来源。
        content = await file.read()
        try:
            # 1. 类型、大小与可索引文本在创建记录前验证。
            _validate_upload(file, content)
            try:
                indexable_text = extract_indexable_text(file.filename or "document", content)
            except ValueError as exc:
                raise ApiErrorException("VALIDATION_INVALID_ARGUMENT", str(exc)) from exc
            chunking_configuration = _parse_chunking_configuration(chunking)
            content_hash = f"sha256:{sha256(content).hexdigest()}"
            repositories = _memory_repositories(request)
            # 2. 重复判断显式包含 owner 与知识库范围。
            duplicate = await repositories.documents.find_active_by_hash(
                owner_user_id=user.id,
                knowledge_base_id=knowledge_base_id,
                content_hash=content_hash,
            )
            if duplicate is not None and not overwrite:
                raise ApiErrorException("BUSINESS_CONFLICT")
            # … 省略 overwrite 时删除旧向量并标记旧文档的代码
            # 3. 新记录保存可索引文本和用户选择的切分配置。
            document = await repositories.documents.create_document(
                owner_user_id=user.id,
                document_id=f"doc_{uuid4().hex}",
                knowledge_base_id=knowledge_base_id,
                # … 省略文件名、大小、MIME、哈希等参数
                metadata={
                    "upload": "user-selected",
                    "indexableText": indexable_text,
                    "chunking": chunking_configuration,
                },
            )
📷 [图片 token=UJXLb5V68o7cRrxppbGcpU2qncc(未能下载,见飞书原文)]
📷 [图片 token=Vm6tbnTZDoy4ezx5kuscE4D2nTc(未能下载,见飞书原文)]
📷 [图片 token=MTGwbuxZDoTCwTxNptYcWoYsnQg(未能下载,见飞书原文)]
📷 [图片 token=I2UzbHHkooG0cox3vOfcwAPYnyf(未能下载,见飞书原文)]
📷 [图片 token=MqaRbFOqjonkUQxqfesc2RxHnFd(未能下载,见飞书原文)]
这段代码证明上传成功只创建文档输入,不代表向量已生成;新记录的默认索引状态仍是 pending。overwrite 会创建新 document ID,且旧向量删除与新记录创建不在一个跨系统事务里,失败时不能假定两边会自动回滚。
📷 [图片 token=SAvMbdDcyoZnmfxb7yJc7UDtnGf(未能下载,见飞书原文)]
SQLiteKnowledgeDocumentRepository.create_document 默认创建 status 为 ready、index_status 为 pending 的记录。除了文件名、大小、MIME、hash 和时间,它还保存 indexableText 与 chunking。因此重建索引不需要用户重新上传原文件;索引服务从 SQLite 文档记录恢复输入。
📷 [图片 token=AM8DbGp9PoVKbQxJsMocEqLInOh(未能下载,见飞书原文)]
允许格式只有 .md 和 .pdf。Markdown 可接受浏览器常见的 text/markdown、text/plain、application/octet-stream 或空 MIME;PDF 扩展名必须与允许 MIME 一致。重复判断不只看文件名,而是使用 sha256: 前缀的内容哈希,并限定在当前 owner 和知识库。未明确 overwrite 时返回业务冲突;overwrite 为真时,先删除旧文档向量并把旧记录标记为 deleted,再创建新文档 ID。
📷 [图片 token=KtgQbb4FEo62ulxICyocH9VZnfK(未能下载,见飞书原文)]
当前实现把可索引正文存放在 SQLite JSON metadata 中,而不是单独对象存储。它适合当前 10 MiB 上限和本地工作台,但不能据此推断已经存在原始二进制文件归档、OCR 或对象存储版本管理;这些能力在这条实现中没有出现。
📷 [图片 token=UX7db7jkfoOkRcxtvuUcdf5LnQv(未能下载,见飞书原文)]
切分策略与预览复用
**看什么:**看公共切分入口如何根据持久化 strategy 分派,并在进入具体 splitter 前统一处理空文本和 fixed-character 参数边界。
    effective_chunk_size = DEFAULT_CHUNK_SIZE if chunk_size is None else chunk_size
    effective_chunk_overlap = chunk_overlap if chunk_overlap is not None else DEFAULT_CHUNK_OVERLAP
    # 1. 所有调用者共享同一组基本参数检查。
    if effective_chunk_size <= 0:
        raise ValueError("chunk_size must be greater than zero")
    if effective_chunk_overlap < 0:
        raise ValueError("chunk_overlap must be zero or greater")

    normalized = text.strip()
    if not normalized:
        return []
    # 2. 预览与真正索引都从这个 strategy 分派入口进入。
    if strategy == "markdown-heading":
        return _heading_chunks(normalized, effective_chunk_size)
    if strategy == "paragraph":
        return _paragraph_chunks(normalized, effective_chunk_size)
    if strategy == "legacy-word":
        return _legacy_word_chunks(normalized, effective_chunk_size)
    if strategy != "fixed-character":
        raise ValueError("Unsupported chunking strategy")
    if effective_chunk_overlap >= effective_chunk_size:
        raise ValueError("chunk_overlap must be smaller than chunk_size")
    return _fixed_chunks(normalized, effective_chunk_size, effective_chunk_overlap)
📷 [图片 token=KVpqb5Sb6oxLjUxKBnMcz7jonnh(未能下载,见飞书原文)]
📷 [图片 token=PEb9bUlnFoABQ9xjejkcdUIsnSc(未能下载,见飞书原文)]
📷 [图片 token=RlvObB6JjofxwwxWR8yc2Tgdnef(未能下载,见飞书原文)]
📷 [图片 token=IveabTAyQotSRdxC8dVcfH4Jnfe(未能下载,见飞书原文)]
同一函数被 chunk preview 和 DocumentIndexingService 调用,因此保存的 strategy 与参数决定两处结果。空文本返回空列表,索引服务随后把它转成明确失败;这里没有 PDF 页码映射,start/end 仍只是提取后文本的字符位置。
📷 [图片 token=Dv7jbsrgkoaBgJxFRUCcSIhpncb(未能下载,见飞书原文)]
共享契约支持 fixed-character、markdown-heading 和 paragraph。固定字符策略要求最大字符数在 100 到 5000 之间,overlap 非负且小于最大字符数;默认是 1200 和 200。它使用 RecursiveCharacterTextSplitter,依次考虑空行、换行、空格和字符边界。Markdown 标题策略使用 MarkdownHeaderTextSplitter 处理一级到六级标题,过大的标题段再无重叠地固定切分。段落策略按双换行分组,过长单元同样回退到固定切分。
📷 [图片 token=EJ1HbAPowoeHjjxlXzycDGbEnSC(未能下载,见飞书原文)]
DocumentChunk 记录从 0 开始的 index、content、start、end 和可选 heading_path。预览 API 直接调用 chunk_document_text,返回总 chunk 数、是否超过 12 条、前 12 条的字符数与最多 400 字符 excerpt。预览和索引共享实现,避免“预览一种切法、真正索引另一种切法”。
📷 [图片 token=RnksbK6kwoEisaxx9OYc907Tnpe(未能下载,见飞书原文)]
chunk ID 使用文档 ID 加四位序号,例如 {document.id}_chunk_0000,在相同文档和相同切分配置下稳定。向量 metadata 还包含 chunk 边界、knowledgeType、chunkingStrategy、chunkingParameters,以及 ownerUserId、tenantId、knowledgeBaseId、documentId、chunkId。
📷 [图片 token=Or2jbGip8oKqPTxmvkBcPZbFnIQ(未能下载,见飞书原文)]
索引执行与真实失败
**看什么:**先看 worker 进入业务服务后最早发生的两个状态写入;它们位于后续统一异常捕获之前。
        # 1. durable job 已 running,领域 task 仍要单独更新。
        await self._repositories.document_index_tasks.mark_running(
            owner_user_id=owner_user_id,
            task_id=task.id,
        )
        # 2. 文档状态供页面表达正在构建索引。
        await self._repositories.documents.update_index_status(
            owner_user_id=owner_user_id,
            knowledge_base_id=task.knowledge_base_id,
            document_id=task.document_id,
            index_status="indexing",
        )
📷 [图片 token=CUu1bQOJjodLqZxBKKecygy1n3F(未能下载,见飞书原文)]
这两次 Repository 调用不属于 Milvus 写入事务,也不在本方法的 catch 内。任一步骤自身失败会交给上层 durable runtime 处理,不能保证业务 task 已被本服务改成 failed;页面也可能短暂看到通用 job 和文档状态不同步。
📷 [图片 token=UXYxb2NkMob5ESxWCijci6wbnbG(未能下载,见飞书原文)]
**看什么:**再看真正的重建顺序:先得到完整 chunks 和等量 vectors,之后才初始化、删除旧范围并准备插入。
            # 1. 按文档保存的策略切分,空结果直接失败。
            chunks = chunk_document_text(
                _indexable_text(document),
                strategy=strategy,
                chunk_size=chunk_size,
                chunk_overlap=chunk_overlap,
            )
            if not chunks:
                raise DocumentIndexingError("Document has no indexable text.")
            # 2. embedding 返回数量必须和 chunks 一一对应。
            vectors = await self._embedding_model.aembed_documents(
                [chunk.content for chunk in chunks]
            )
            if len(vectors) != len(chunks):
                raise DocumentIndexingError(
                    "Embedding provider returned an unexpected vector count."
                )
            # 3. 只有向量完整后才删除当前文档的旧范围。
            self._vector_store.initialize()
            self._vector_store.delete_document_chunks(
                tenant_id=owner_user_id,
                knowledge_base_id=document.knowledge_base_id,
                document_id=document.id,
            )
            self._vector_store.insert_chunks(
                [
                    _vector_chunk_record(
                        document=document,
                        tenant_id=owner_user_id,
                        chunk=chunk,
                        vector=vector,
                    )
                    for chunk, vector in zip(chunks, vectors, strict=True)
                ]
            )
📷 [图片 token=PVdGbeBZNoUmx9x0993cxq4InWh(未能下载,见飞书原文)]
📷 [图片 token=LHCEbARoPobCHFxRjoFcx9oyn1g(未能下载,见飞书原文)]
📷 [图片 token=TQarbYasOodNoPx3clccT1DdnDf(未能下载,见飞书原文)]
📷 [图片 token=R1NGbE3QJoppkzx6gZdcnQ3Pnxf(未能下载,见飞书原文)]
📷 [图片 token=BGjibFnNSolqqCxxds3cwJUOnwe(未能下载,见飞书原文)]
📷 [图片 token=OZoubI2fZov7aVxGnHXcPYSenAf(未能下载,见飞书原文)]
embedding 失败不会先删旧索引,但删除成功、insert 失败仍会留下空档;catch 会诚实地把文档和 task 标为 failed。删除条件带 tenant、知识库与文档三重范围,不过 SQLite 状态与 Milvus 变更没有跨系统原子保证。
📷 [图片 token=Q3xabh9PgoWPNwxSaooc84S3ntd(未能下载,见飞书原文)]
run_task 首先按 owner 读取任务,标记任务 running、文档 indexing。随后读取文档和策略,生成非空 chunks,调用 aembed_documents。返回向量数量必须与 chunk 数一致。只有 embedding 完成后才初始化 collection 和索引,再按文档范围删除旧 chunks,最后一次批量插入全部新 records。
📷 [图片 token=LFWNbzTQhoKeHAxmtC0cHOjxnTe(未能下载,见飞书原文)]
成功路径把文档设为 indexed,把任务设为 succeeded 并写完成时间。读取文档以及后续切分、embedding 和 Milvus 操作位于统一 catch 内:异常时文档设为 failed,任务设为 failed,保存至多 500 字符的 failure_reason,并返回失败任务。durable job handler 看到业务结果不是 succeeded 时会再次抛错,从而触发通用 job 的自动重试。需要注意,最初的任务读取、mark_running 和文档 indexing 状态更新在 catch 之外;这些 Repository 操作失败时由上层 job 捕获,业务任务不保证被这段服务代码转换为 failed。
📷 [图片 token=NNQnbFBCBoq7xSxXvGGcKX0CnEg(未能下载,见飞书原文)]
这里有两个诚实边界。第一,_safe_failure_reason 当前主要做空值兜底和 500 字符截断,并非通用秘密脱敏,因此 provider 和 vector store 层应只抛安全消息。第二,重建先删除旧 chunks 再插入新 chunks,不是跨 SQLite 与 Milvus 的原子事务;如果删除后插入失败,文档会明确显示 failed,而不会伪装成仍可用的成功索引。
📷 [图片 token=JC3TbGnjnonK1MxEN57cy2R8nZg(未能下载,见飞书原文)]
从页面动作推演一次完整状态变化
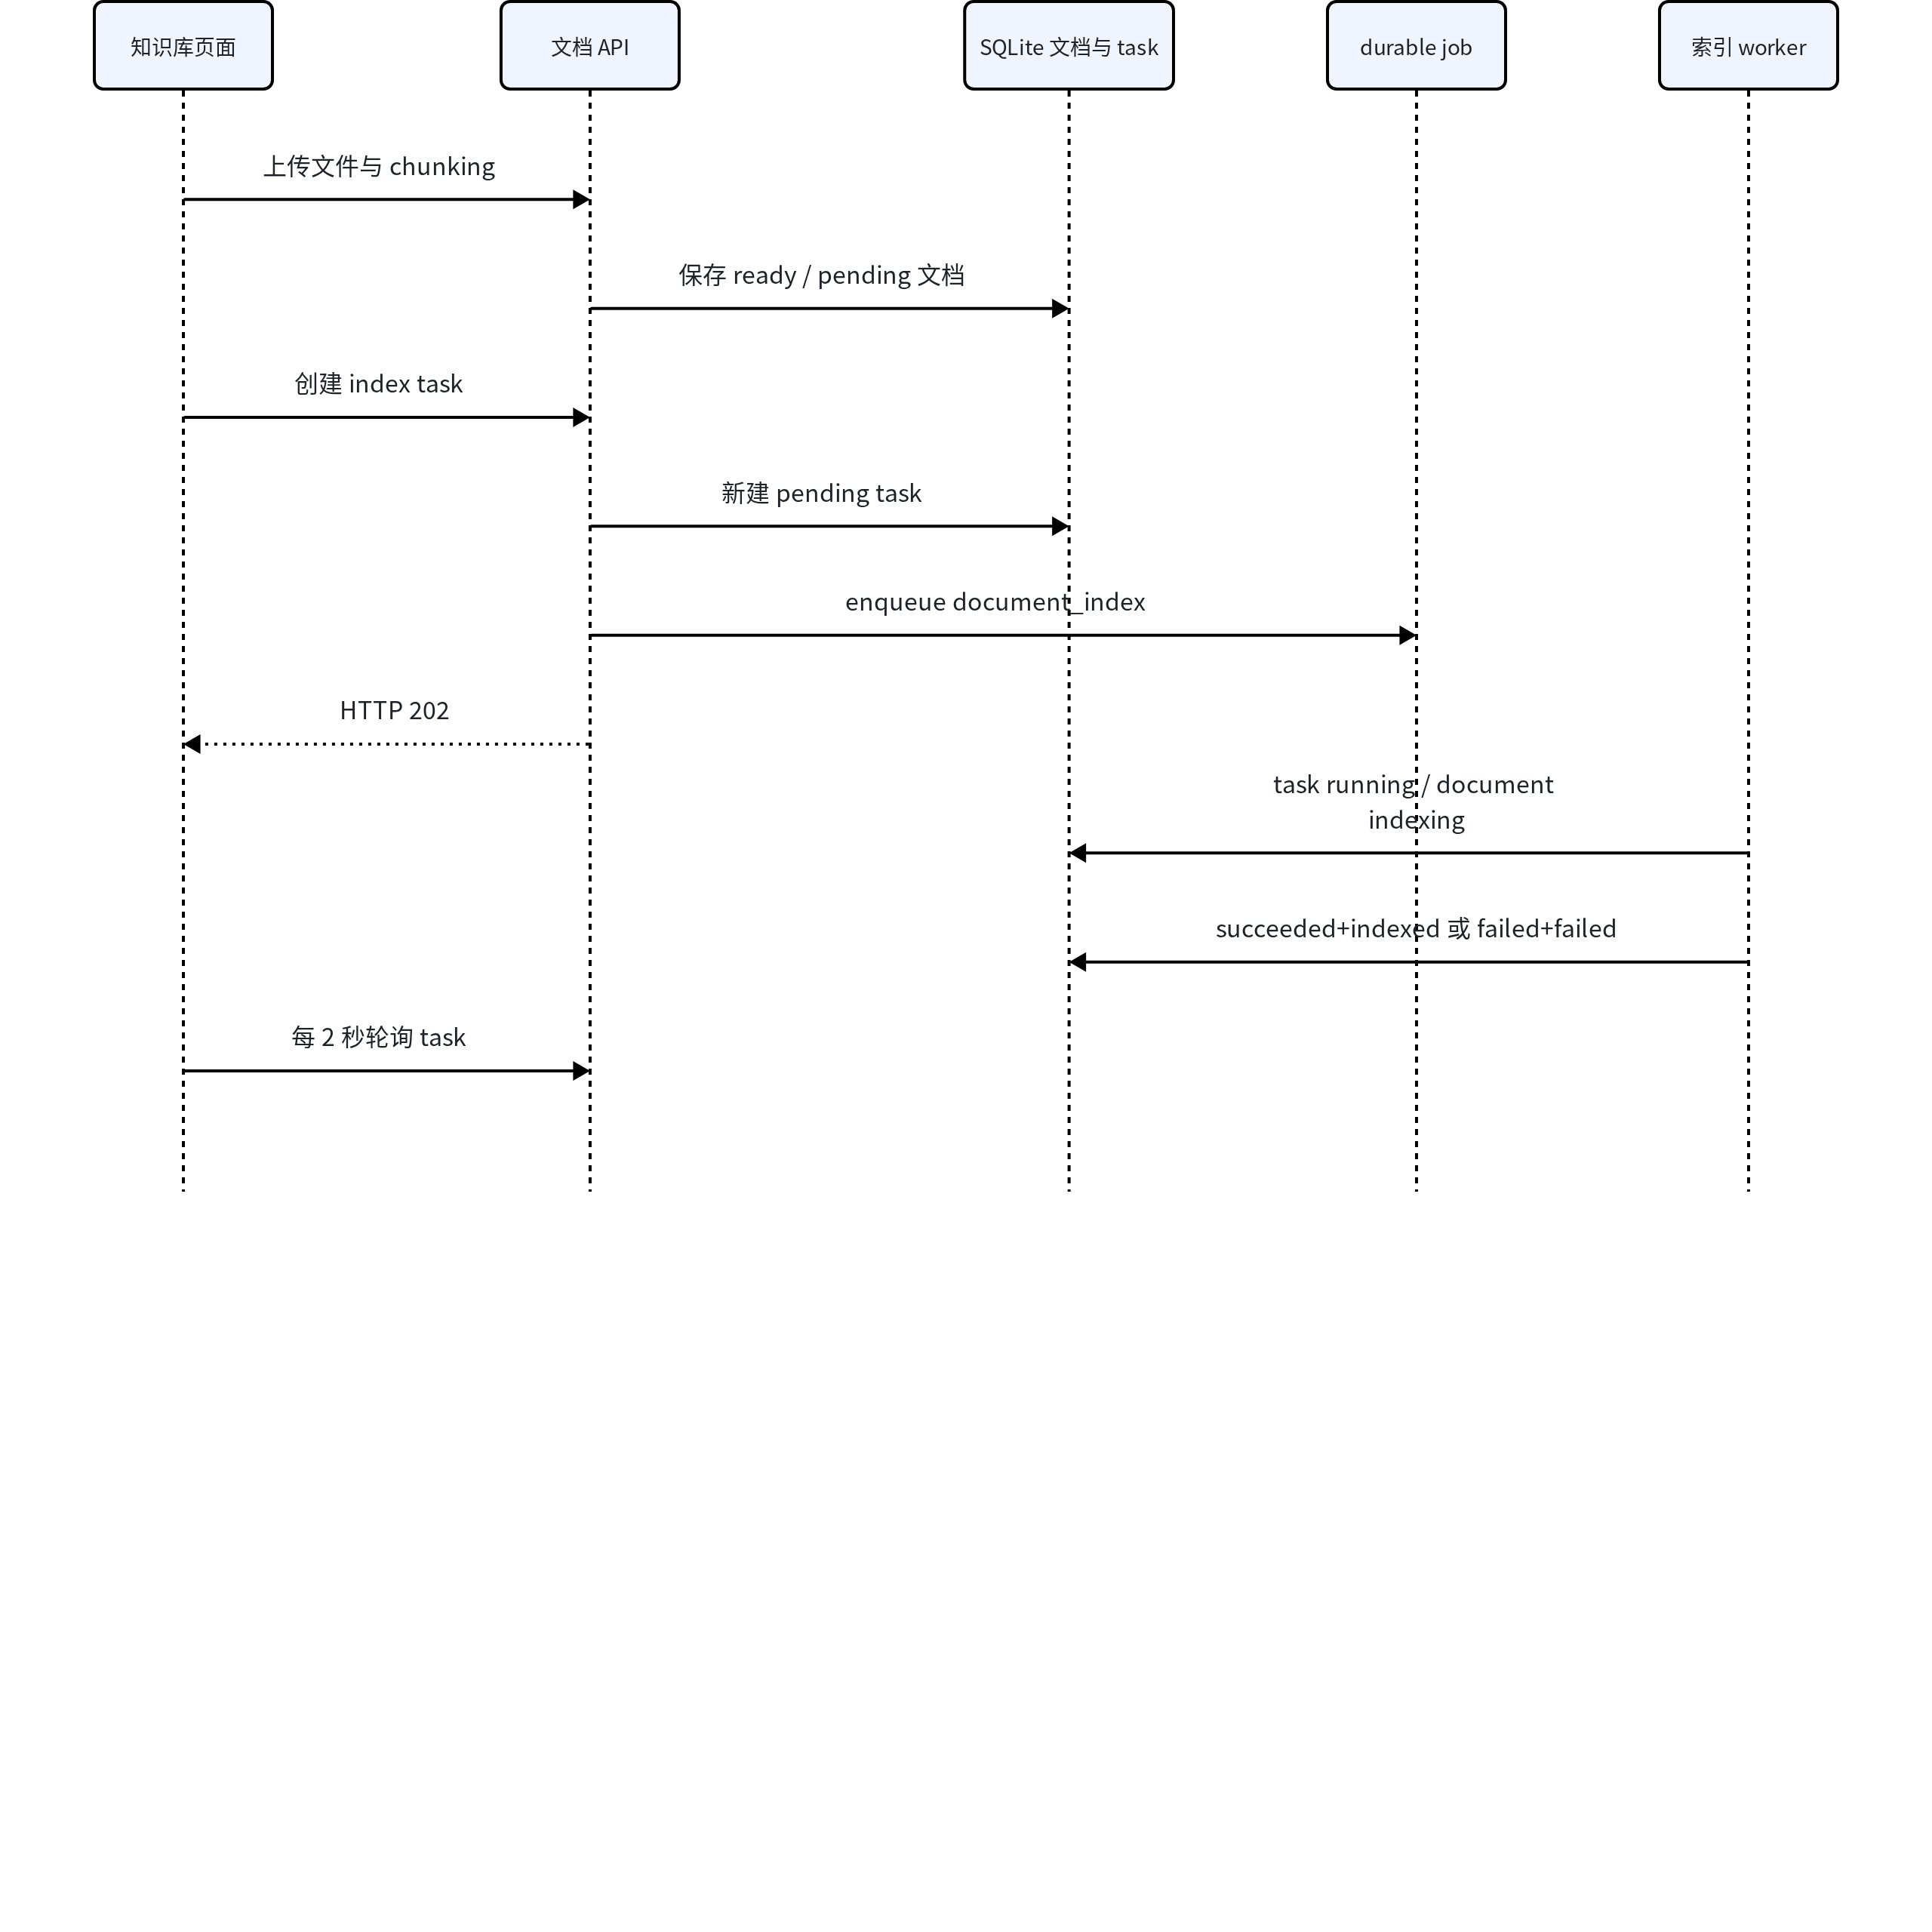
**看什么:**这张序列图把 HTTP 202、前端轮询、durable job 和两个业务状态分开,避免把“已接收”误读为“已索引”。
📷 [图片 token=VMlfbafqPopaRAx2G1LcIHTRncb(未能下载,见飞书原文)]
图中 202 只确认业务 task 与调度已接受,不等待 worker。task 与 document 来自不同读取接口,更新也不是同一原子快照;轮询停止条件是 task 终态,文档列表仍需重新读取才能对账最终 indexStatus。
📷 [图片 token=QdZFbfgIpoDHDLx0WbBcLgUAnrh(未能下载,见飞书原文)]
用户选择文件并点击上传时,前端先验证选择,再把文件、overwrite 和 chunking 放入 FormData。上传请求成功后,页面拿到的是 ready 文档和 pending 索引状态。store 随即读取 preview,并创建 index task。创建接口返回的 task 仍可能是 pending,因为后台 worker 是否已经领取并不属于 HTTP 202 的完成条件。store 把它加入 indexTasks 后开始每 2 秒轮询。
📷 [图片 token=EMAvbeFFMoLkrVxZsFGcJczRn5g(未能下载,见飞书原文)]
worker 领取 durable job 后,DocumentIndexingService 将业务 task 设为 running,同时把文档 indexStatus 设为 indexing。页面轮询的对象是 task,所以可以观察 pending 到 running;文档列表中的对象来自另一个 API,二者更新时刻并不完全相同。任务终态后计时器停止,用户重新打开详情或刷新列表时取得文档的 indexed 或 failed。页面还允许对任意已有文档触发 rebuild,这会新建一条 pending task,而不是覆写历史任务。
📷 [图片 token=JAX6b2dIeoxBDrxAV4zcwpoHn6g(未能下载,见飞书原文)]
如果索引失败,task.failureReason 是最直接的恢复依据。只有 failed 的 task 可以调用领域 retry 路由;后端验证知识库、文档和 owner 全部匹配后,用新 task ID 建立记录,并通过 retryOfTaskId 指向旧任务。新任务重新进入 durable scheduler。用户看到的是一条新的执行记录,旧失败原因仍保留,便于区分首次失败与后来恢复。
📷 [图片 token=XOOKbVhpwo0w7rxZPnXcX672nEe(未能下载,见飞书原文)]
切分确定性与稳定标识的范围
**看什么:**看 Milvus 记录的 chunk ID 与范围 metadata 如何从 document 身份和有序 chunk 生成;稳定性绑定的是同一个 document ID。
    # 1. 四位序号来自确定性 chunk 顺序,但前缀绑定 document.id。
    chunk_id = f"{document.id}_chunk_{chunk.index:04d}"
    metadata: dict[str, object] = {
        **chunk.metadata,
        "knowledgeType": _knowledge_type(document),
        "chunkingStrategy": _chunking_kwargs(document)[0],
        "chunkingParameters": _chunking_parameters(document),
        # 2. 检索和删除需要的 owner/tenant/资源范围一起写入。
        **build_vector_chunk_metadata(
            owner_user_id=document.owner_user_id,
            tenant_id=tenant_id,
            knowledge_base_id=document.knowledge_base_id,
            document_id=document.id,
            chunk_id=chunk_id,
        ),
    }
    return VectorChunkRecord(
        chunk_id=chunk_id,
        document_id=document.id,
        knowledge_base_id=document.knowledge_base_id,
        owner_user_id=document.owner_user_id,
        tenant_id=tenant_id,
        content=chunk.content,
        vector=vector,
        metadata=metadata,
        source=document.source or document.filename,
        created_at=datetime.now(timezone.utc),
    )
📷 [图片 token=ZBm1bVIGGoFUNhxeueacPC3bnNg(未能下载,见飞书原文)]
📷 [图片 token=Awewbb0YVooFA2xSXCHciekPnzc(未能下载,见飞书原文)]
📷 [图片 token=FCAab7ftXowHNfxnqzpc3DOUnie(未能下载,见飞书原文)]
📷 [图片 token=JsPIbl2uBoxDRexcIzscJbTAn0c(未能下载,见飞书原文)]
普通 rebuild 保留 document ID,所以相同文本和配置会复用同一序号体系;overwrite 创建新 document ID,chunk IDs 必然整体变化。metadata 提供范围与切分解释字段,但不会补出 PDF 页码,也不能让旧 citation 在身份更换后自动指向新 chunk。
📷 [图片 token=VombbyLWPoGu7Zxu3zGclVFNnqb(未能下载,见飞书原文)]
所谓确定性,是指同一份已保存文本、同一文档记录和同一 chunking 配置会得到相同顺序、边界与 chunk 序号。固定字符切分会利用原文查找位置,并根据 overlap 推进 cursor;标题和段落切分也按源文本顺序组装。测试不仅检查前几个 chunks,还覆盖超过 10 个 chunks 的索引,避免实现暗含小文档限制。
📷 [图片 token=KNiJbzmUyo99hpxunkJcnSXnnkf(未能下载,见飞书原文)]
chunk ID 包含 document.id,所以 overwrite 上传即使字节完全相同,也会先删除旧文档并创建新 document ID,随后产生一组新的 chunk IDs。稳定性并不跨越文档身份更换。普通 rebuild 保留 document ID,因此在策略不变时 chunk ID 稳定;如果用户未来改变持久化配置并重建,序号之后的内容映射可能变化,引用消费者必须把 document ID、chunk ID 和 metadata 一起看待。
📷 [图片 token=Obcab0EfBoFq0GxtIYtc5PxfnYg(未能下载,见飞书原文)]
start 和 end 是面向可索引文本的字符位置,不是 PDF 原始字节偏移,也不是页码。PDF 提取把有文本的页面用空行拼接,当前 metadata 没有持久化 page number。由此可以提供 chunk excerpt 和来源文件,却不能把现有实现描述成精确 PDF 页定位。Markdown heading 才有可选 headingPath,而且只有解析到标题元数据时出现。
📷 [图片 token=TyXVbW9pCoEdiYxT14CcmDVGnAI(未能下载,见飞书原文)]
外部资源调用的顺序为何重要
**看什么:**这张图只标出当前真实调用顺序,并突出唯一危险窗口:旧向量已经删除,而新批次尚未成功插入。
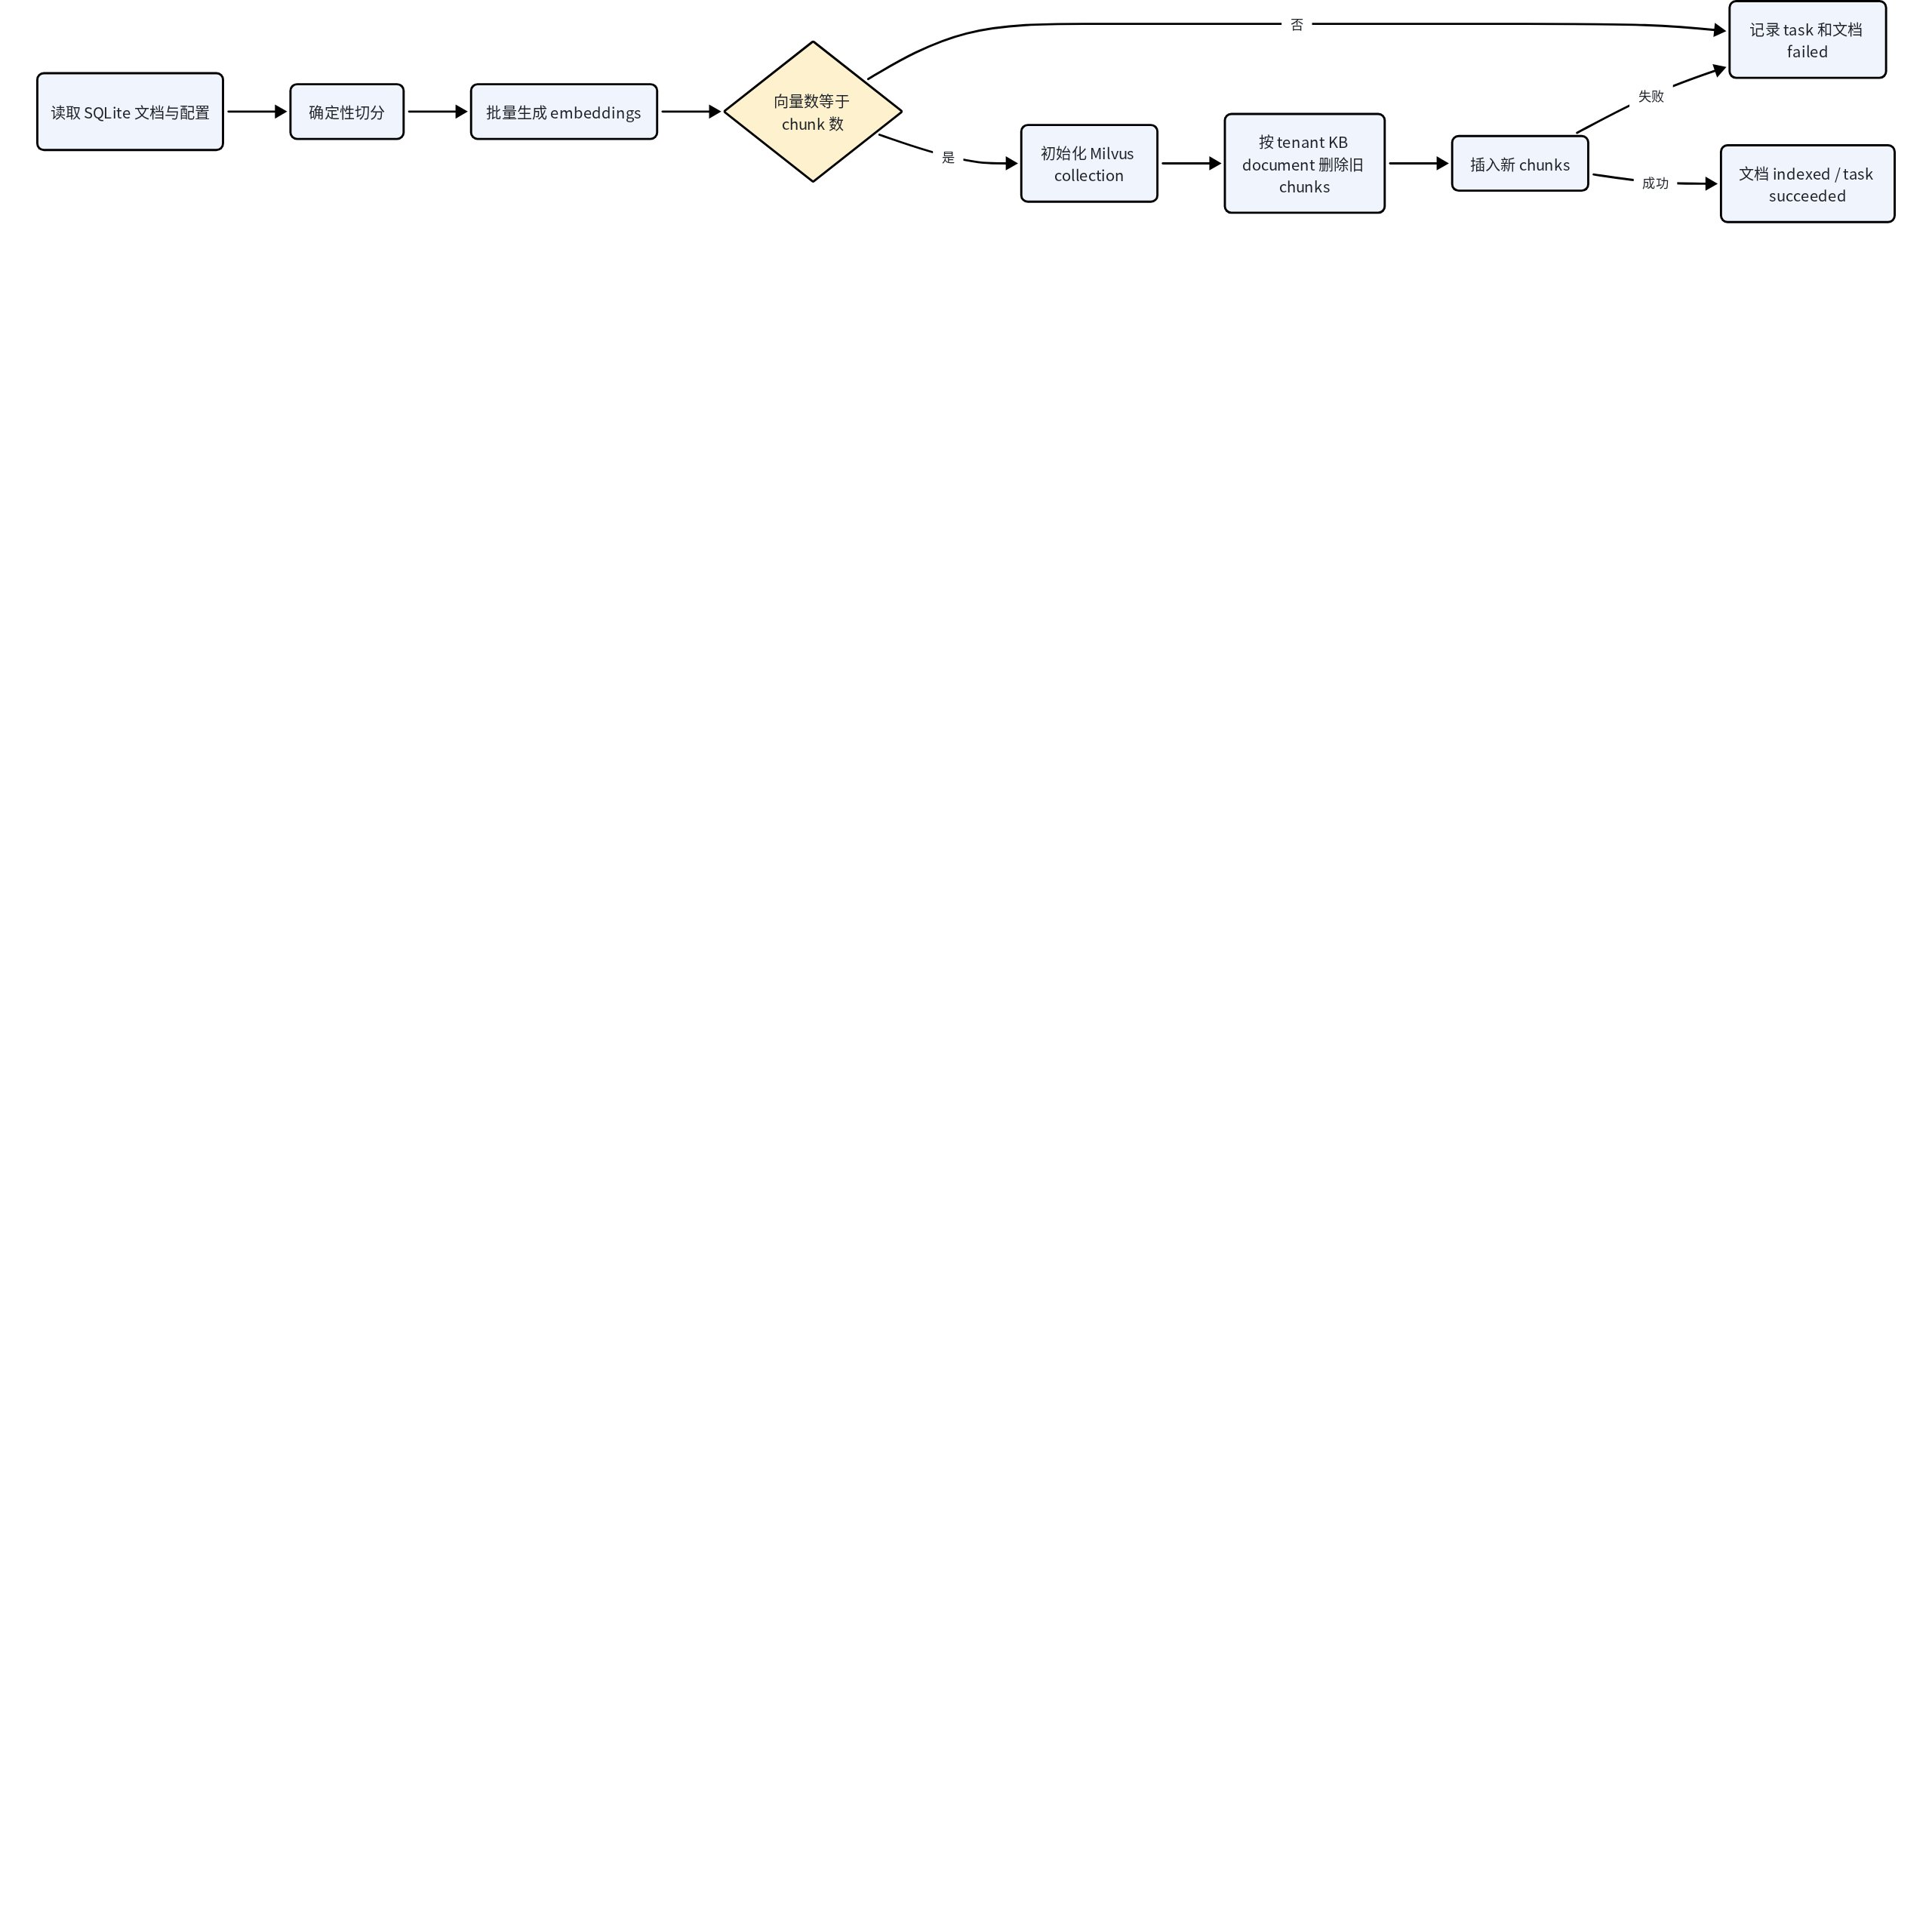
把 embedding 和数量校验放在删除前,减少了上游失败破坏旧索引的机会;但 G 到 H 之间没有版本化集合或原子别名切换。此时失败会留下明确 failed 状态,而不是继续宣称旧索引可用。
📷 [图片 token=HgFRbOWJXoBC2lxgIT3cYVhHn0g(未能下载,见飞书原文)]
服务先切分,再一次性调用 embedding 获取全部 vectors;数量核对通过后才触碰 Milvus。这个顺序避免 embedding 半失败时先删除已有索引。随后 initialize 确保 collection、标量索引、向量索引与加载状态,再范围删除旧 chunks,最后批量 insert。维度不匹配会在 MilvusVectorStore._chunk_to_entity 构造实体时被拒绝。
📷 [图片 token=KrlsbBIUwopD6Dxnq5BcnAEXn0b(未能下载,见飞书原文)]
删除后插入仍可能失败,因此重建并非零停机切换。系统用 failed 状态诚实表达这种窗口,没有保留旧版本 collection 或双写影子集合。若业务要求“新索引完全就绪前旧索引持续服务”,需要引入版本化文档索引、临时分区或原子别名切换;这些都不是当前实现,教学时不能把合理演进方向说成已有机制。
📷 [图片 token=CJlkbJayCoS9uzxnsWbctfwcnXg(未能下载,见飞书原文)]
删除文档走相反方向:API 先确认 owner 下文档存在,调用范围向量删除,再把 SQLite 记录标记 deleted。若 Milvus 删除抛错,请求不会继续伪装成功。文档列表默认过滤 deleted,Repository 仍支持内部 include_deleted 查询,这为审计保留了元数据,但不代表恢复删除的公开 API 已经实现。
📷 [图片 token=N3INbymJwoQ8cCxb9CMcd86enTc(未能下载,见飞书原文)]
上传文本的安全与容量取舍
**看什么:**看服务端上传校验的真实边界:空内容、10 MiB、扩展名和 MIME 组合都会在提取与持久化前被拒绝。
    filename = file.filename or ""
    suffix = PurePosixPath(filename).suffix.lower()
    mime_type = file.content_type or ""
    display_mime_type = mime_type or "empty"
    # 1. 空文件与超过 10 MiB 的输入先失败。
    if not content:
        raise ApiErrorException(
            "VALIDATION_INVALID_ARGUMENT",
            "文件不能为空,请上传包含正文的 Markdown 或 PDF。",
        )
    if len(content) > DOCUMENT_MAX_SIZE_BYTES:
        raise ApiErrorException("VALIDATION_INVALID_ARGUMENT", "文件大小不能超过 10 MB。")
    # 2. 扩展名和浏览器 MIME 变体必须同时落入允许目录。
    if suffix not in ALLOWED_DOCUMENT_EXTENSIONS:
        raise ApiErrorException(
            "VALIDATION_INVALID_ARGUMENT",
            "仅支持 Markdown(.md) 与 PDF(.pdf) 文件。",
        )
    if suffix == ".md" and mime_type not in MARKDOWN_DOCUMENT_MIME_TYPES:
        raise ApiErrorException(
            "VALIDATION_INVALID_ARGUMENT",
            f"Markdown 文件的 MIME 类型不符合要求:{display_mime_type}。请上传 .md 文件。",
        )
📷 [图片 token=Qpu6bSPkYo5zVrxhNRCc67AsnZe(未能下载,见飞书原文)]
📷 [图片 token=QujobH9WVouqyXx3MVVc9pminBh(未能下载,见飞书原文)]
📷 [图片 token=TagebnRnyo8XKJxY0Wycj5RrnJ0(未能下载,见飞书原文)]
校验限制的是上传字节,不是提取后的字符数、chunk 数或 token 数;大型合法文档仍可能让 embedding 或 durable timeout 失败。原始 filename 作为元数据保存且应按不可信文本展示,完整可索引正文保存在本地 SQLite,也没有文档级加密或自动脱敏。
📷 [图片 token=Gv8zbcMLJogai6xhflCcBu6inxb(未能下载,见飞书原文)]
后端从 UploadFile.filename 读取文件名,以 PurePosixPath(filename).suffix 校验扩展名,并把原始 filename 保存到文档记录;当前代码没有额外执行 basename 归一化。索引使用保存的 filename 作为默认 source。正文存入 JSON metadata,API 的普通文档 payload 不回传 indexableText,只返回对页面必要的元数据和 chunking 配置;preview 也只返回有限 excerpt。这样减少了列表接口泄露完整文档正文的风险,但文件名本身仍应按不可信展示文本处理。
📷 [图片 token=WbVnbNmk1ocUAkxDeVtcqSZunId(未能下载,见飞书原文)]
不过,SQLite 仍然保存完整可索引文本,拥有本地数据库访问权的人能够读取它。当前系统是本地优先而非客户端加密知识库,代码没有实现文档级加密、内容脱敏或保留期限。日志规范要求不记录文档正文,索引服务的结构化日志只记录 taskId、documentId、chunkCount、耗时和异常类别。
📷 [图片 token=Ips0bzCuKoFjruxKbAtc2VFancg(未能下载,见飞书原文)]
10 MiB 是上传字节上限,不等于提取文本或 token 的精确上限。大型 PDF 可能产生很多 chunks;索引服务把完整文本列表一次交给 aembed_documents,但默认 OpenAIEmbeddings 客户端配置 chunk_size=10,会在 provider 层按 10 条一批发送。当前没有单文档 chunk 数硬上限。durable timeout 和失败状态为超时提供可观察边界,但容量规划仍需依据具体 embedding provider 和本机资源验证。
📷 [图片 token=CqxxbxIbnoQHDTxQdu2cuRqIn7e(未能下载,见飞书原文)]
前端错误提示通过统一 ApiClientError 和 toUserFacingError 转成中文反馈。重复上传会保留 pendingOverwriteFile 与对应 chunking,用户确认后才以 overwrite 重新提交;取消确认不会修改服务端文档。页面销毁或登出时 store 会停止所有轮询 timer 并清空受保护状态,避免下一位用户看到前一位用户的任务缓存。
📷 [图片 token=S0UGbbm5foI0y2xE21pckwxanqd(未能下载,见飞书原文)]
数据、契约与状态
文档的 status 只有 ready 与 deleted;indexStatus 是 pending、indexing、indexed、failed。索引任务另有 pending、running、succeeded、failed、cancelled。上传响应为 201,索引创建与重试为 202,表示已持久化并接受后台处理,不表示已完成。
📷 [图片 token=GXV8bf6H7o2f1kxMtT2c0DiPn8e(未能下载,见飞书原文)]
任务包含 failureReason、retryOfTaskId、created、updated、started、completed 时间。失败重试不是修改原任务,而是 create_retry 新建一条任务并关联来源。页面 store 把 pending 和 running 视为 active,每 2 秒读取任务;终态后停止该 task 的计时器。页面同时保留文档列表和任务列表,不能把某个任务的 succeeded 直接等同于所有历史任务都成功。
当前 refreshIndexTask 在轮询终态时更新任务并停止轮询,但没有在该函数中重新拉取文档列表;上传流程初始会显示索引过程,文档的最终 indexStatus 可在重新加载文档、切换知识库或其他显式刷新路径后取得。描述页面行为时应以代码为准,不应宣称每次任务终态都立即刷新文档对象。
📷 [图片 token=UNwPbc4Qoo41tgxEgUgcELIXnFh(未能下载,见飞书原文)]
权限、安全与失败边界
后端用 _ensure_knowledge_base_access 要求知识库 ID 精确等于当前 kb_{user.id}。文档 Repository 的 create、get、list、hash 查重、删除和 indexStatus 更新都携带 owner_user_id 与 knowledge_base_id;索引任务也按 owner 读取。跨 tenant 请求统一返回 AUTH_FORBIDDEN,并且在创建任务或触碰 Milvus 前结束。
📷 [图片 token=SyOhbecvPotWvOxBysxcKzGwncb(未能下载,见飞书原文)]
向量清理始终提供 tenant、knowledge base、document 三个非空范围。删除文档时先调用范围向量删除,再标记 SQLite 文档 deleted;覆盖上传遵循相同范围。索引生成的每个 chunk 同时在标量字段和 metadata 中保留 ownership。空文档、无文本 PDF、向量数量异常、维度不符或 Milvus 写入失败都必须显式失败,不生成占位向量或虚假索引成功。
📷 [图片 token=WPRMbxSfioRng9xZYsDcwCTsnMe(未能下载,见飞书原文)]
阅读顺序与小结
先从共享
documents.ts与indexing.ts认识页面能观察到的状态。再读上传路由和
extraction.py,确认真正保存了什么输入。随后逐步跟进
chunk_document_text和DocumentIndexingService.run_task。最后对照 knowledge store、Milvus 范围操作和状态转换,确认索引成功与失败分别留下什么事实。
完整知识链路的成功条件是:文件有效、正文可提取、配置可复现、任务被后台领取、chunks 可生成、embedding 数量正确、Milvus 重建成功、SQLite 状态提交完成。OncallAgent 把这些阶段显式化,正是为了让失败成为可诊断的数据,而不是页面上的一个模糊提示。每个状态都应能追溯到真实执行阶段。
📷 [图片 token=PnKJbnayPo8xXTxJu1NcX0OGnzd(未能下载,见飞书原文)]