OncallAgent 是一个本地优先 AIOps Agent 工作台。文档索引和智能诊断都可能持续数秒乃至更久,如果把它们直接塞进一次 HTTP 请求,浏览器断线、请求超时或后端重启都会让执行状态变得含糊。当前实现因此把“业务任务记录”和“可调度后台作业”分开:业务记录描述文档索引或诊断的领域状态,通用 background job 则负责排队、领取、租约、尝试次数、超时、取消与恢复。
📷 [图片 token=FjxZbfeEwoGpSAxCI10ccKYHnmd(未能下载,见飞书原文)]
这里的 durable 不是指引入了外部消息队列,而是把调度所需状态放进 SQLite。Worker 只是状态机的执行者;进程消失后,作业记录仍在,过期租约会在下一次领取时被回收。这个设计很适合本地优先工作台:部署简单,同时保留可观察、可恢复的执行语义。
📷 [图片 token=FdEvbzKN3oyIvtxe9jYc4yG2nkh(未能下载,见飞书原文)]
理解这套机制时要区分三件事:租约解决“谁现在有权完成作业”,重试解决“失败后何时再次执行”,owner scope 解决“谁能查看和控制作业”。三者落在不同层次,不能用其中一个替代另外两个。
📷 [图片 token=UEctbJhaVoouoWxR5Sic46Kenfh(未能下载,见飞书原文)]
学习目标
理解从业务 API 创建任务,到 durable job 入队,再到注册 handler 执行的完整链路。
掌握 SQLite 租约的领取、心跳续租、过期恢复和 worker 身份校验。
分清同一 job 的自动重试与创建新 job 的人工重试。
识别协作式取消、超时、失败文本和 owner 隔离的真实边界。
功能入口与完整调用链
通用观察入口位于 apps/backend/src/super_ai/api/app.py:GET /background-jobs 列出当前用户作业,GET /background-jobs/{job_id} 读取详情,POST /background-jobs/{job_id}:cancel 请求取消,POST /background-jobs/{job_id}:retry 为 failed 或 cancelled 作业创建新作业。四个路由都从认证依赖取得 user.id,再把它作为 owner_user_id 传给 Repository。
📷 [图片 token=Vb0obEVjHoLywuxsZ0Gc6jLTnCg(未能下载,见飞书原文)]
以文档索引为例,create_document_index_task 先创建业务层 DocumentIndexTaskRecord,随后由 DurableDocumentIndexTaskScheduler.schedule 查询同一 owner、resource type 和 resource ID 下是否已有 job。没有时,它入队一个 kind 为 document_index、resource type 为 document_index_task 的作业,然后启动共享 BackgroundJobRuntime。应用初始化时,create_app 已将 document_index 和 aiops_diagnosis 两个 kind 注册到对应 handler。
📷 [图片 token=SLc2b5oCgomJGMxVMqscc4B1nDc(未能下载,见飞书原文)]
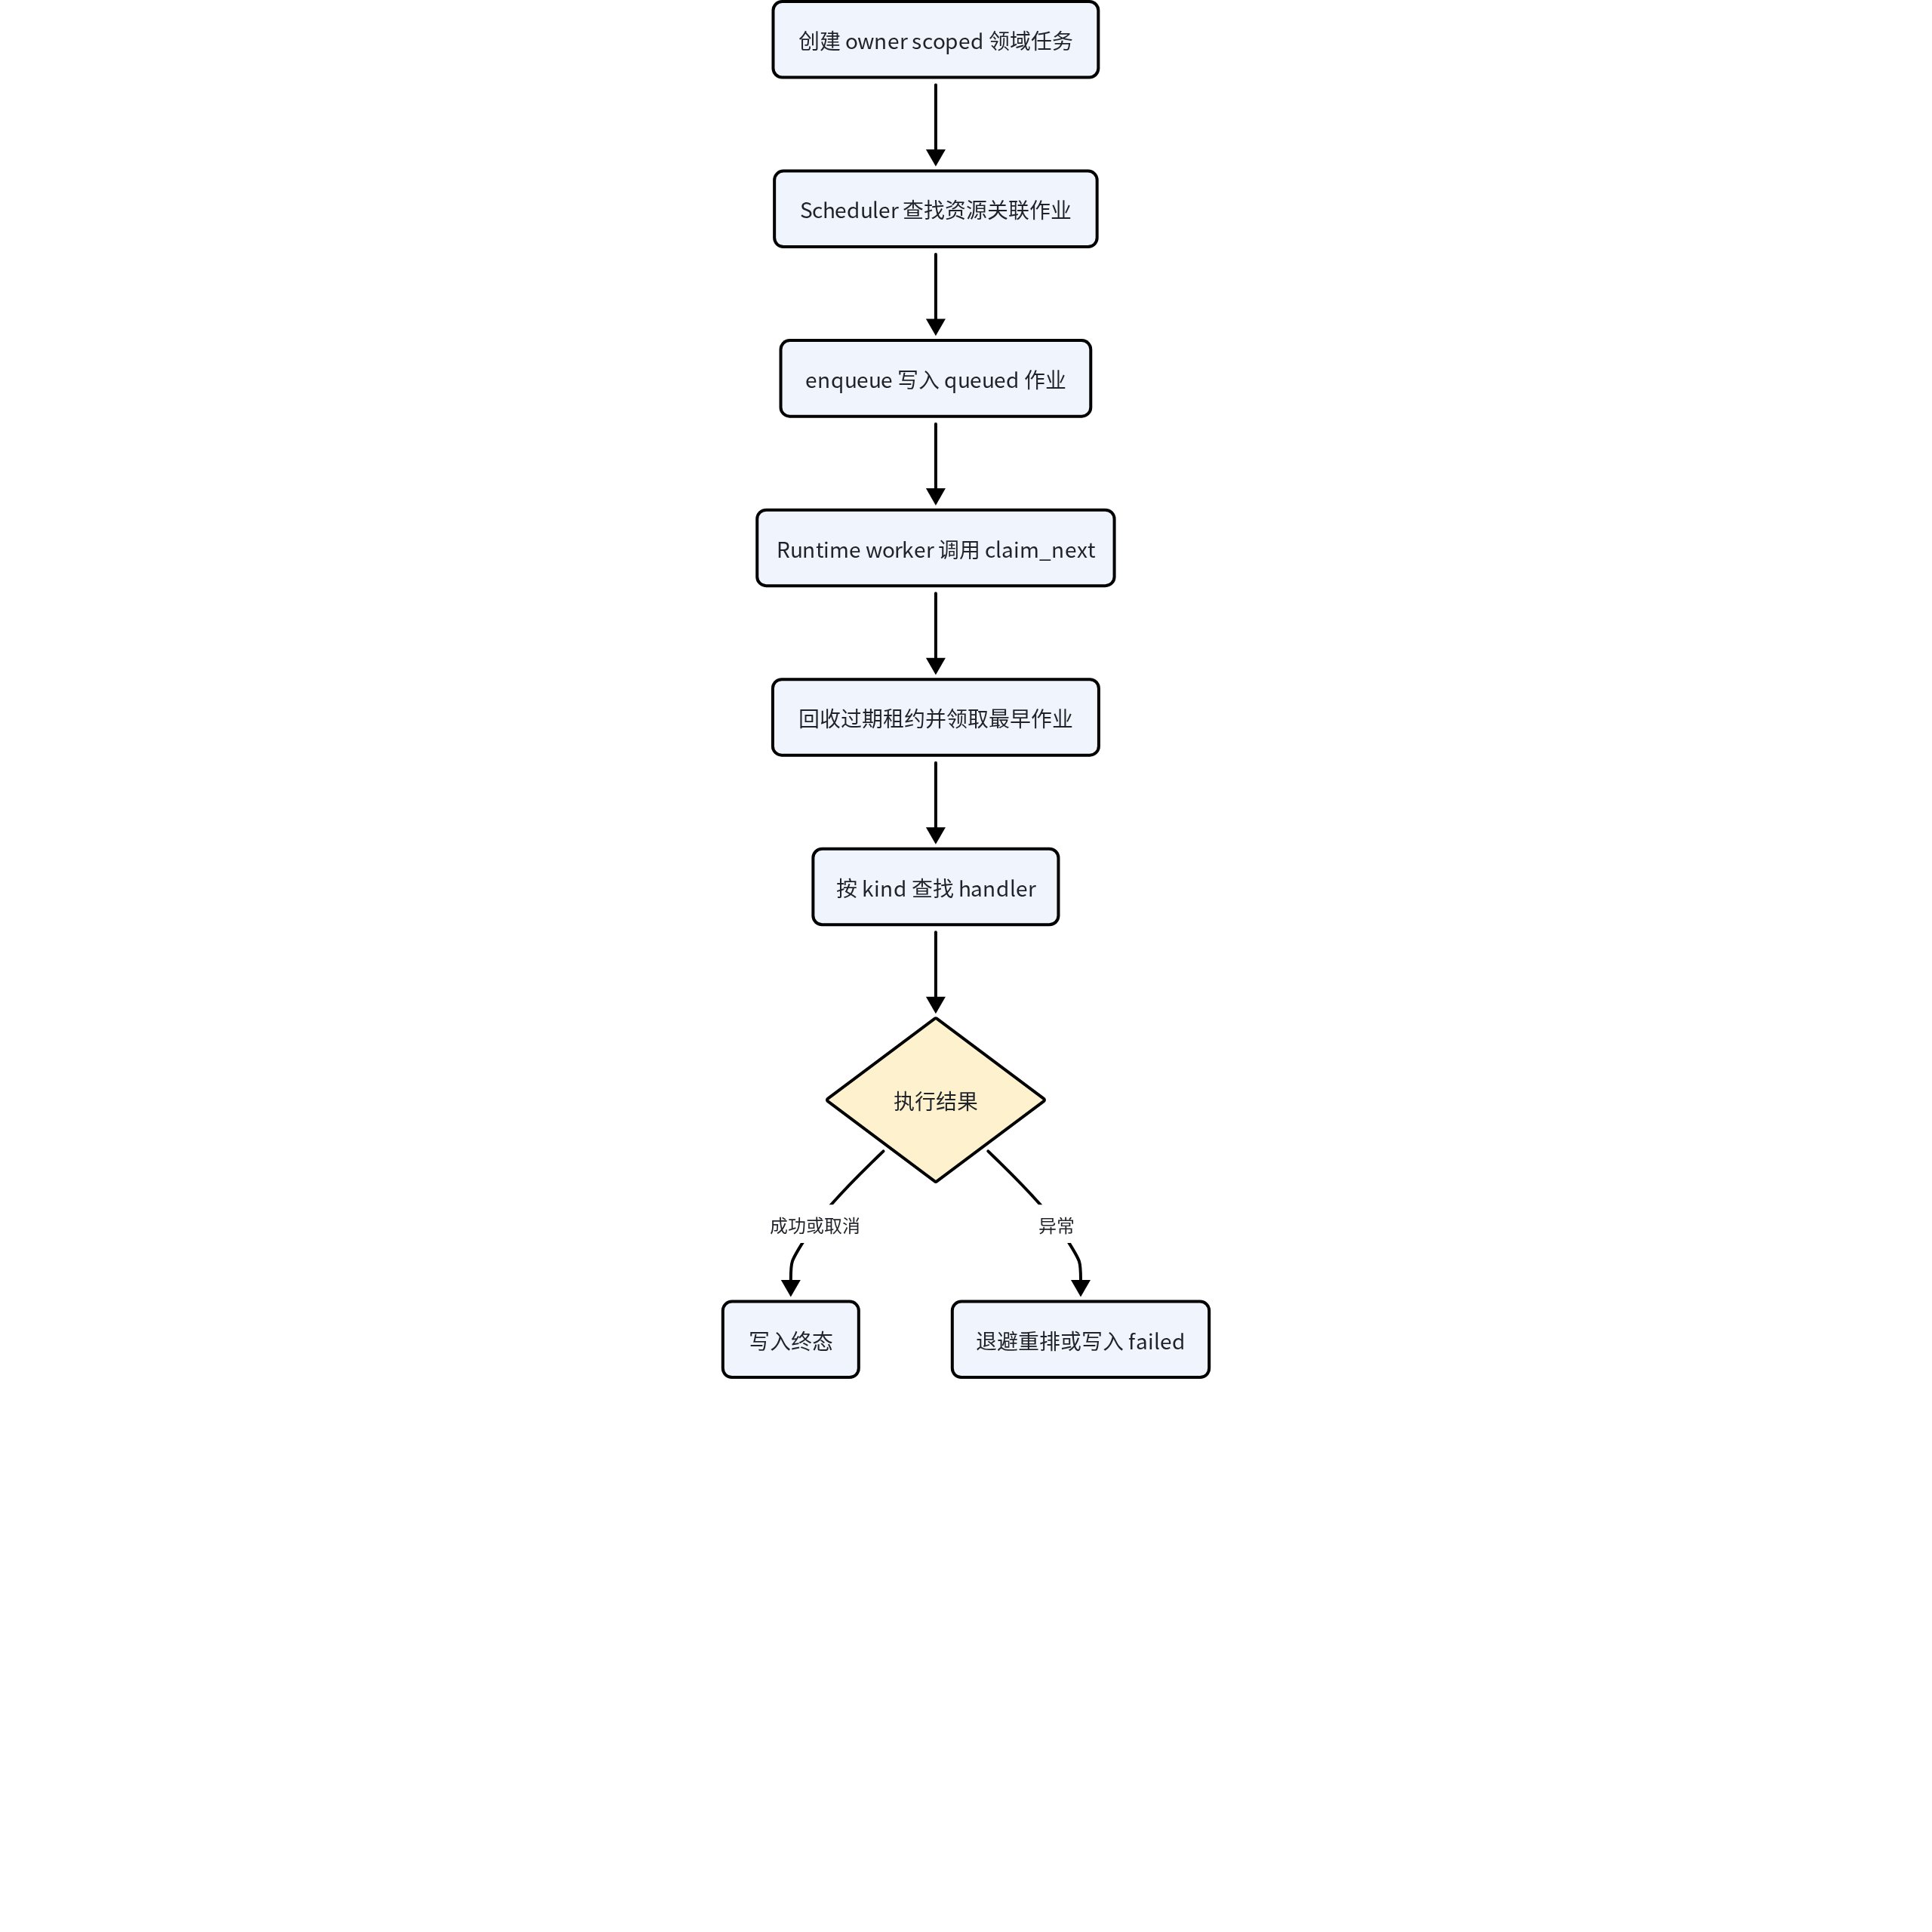
Worker 循环调用 SQLiteBackgroundJobRepository.claim_next。领取成功后,Runtime 根据 kind 找到 handler,启动心跳任务,以 asyncio.wait_for 执行并施加作业自身的 timeout_seconds。成功调用 mark_succeeded;协作式取消调用 mark_cancelled;其他异常进入 handle_failure,由尝试次数决定重新排队还是进入 failed。
📷 [图片 token=RQLpbox8Koc0IqxpNjSckjUXnnn(未能下载,见飞书原文)]
受保护业务 API
  → 创建 owner-scoped 业务任务
  → DurableDocumentIndexTaskScheduler.schedule
  → BackgroundJobRepository.enqueue
  → BackgroundJobRuntime.start
  → claim_next 获取租约并增加 attempt
  → kind 对应的 handler
  → succeeded / queued-for-retry / failed / cancelled
📷 [图片 token=Ro8jbxSdroDCjXxwcV5cPwOunnb(未能下载,见飞书原文)]
核心源码地图
| 源码位置 | 关键符号 | 职责 |
|---|---|---|
apps/backend/src/super_ai/jobs/runtime.py | BackgroundJobRuntime、BackgroundJobContext、JobCancelled | Worker 并发循环、handler 注册、超时、心跳与协作取消。 |
apps/backend/src/super_ai/memory/repositories.py | BackgroundJobRecord、BackgroundJobRepository | 定义不暴露 SQLAlchemy 的持久化边界和作业数据形态。 |
apps/backend/src/super_ai/memory/extended_sqlite.py | SQLiteBackgroundJobRepository | 实现入队、领取、续租、事件、取消、完成、失败和人工重试。 |
apps/backend/src/super_ai/memory/models.py | BackgroundJobModel、BackgroundJobEventModel | 保存作业状态、租约字段以及按 sequence 排序的事件。 |
apps/backend/alembic/versions/202607110005_add_background_job_runtime.py | upgrade | 创建 background_jobs、background_job_events 及 owner、状态、租约索引。 |
apps/backend/src/super_ai/api/app.py | DurableDocumentIndexTaskScheduler、后台任务路由、_document_index_job_handler | 把领域任务接到通用 runtime,并暴露受保护控制面。 |
packages/api-contracts/src/background-jobs.ts | BackgroundJobStatus、BackgroundJob | 共享 queued、running、succeeded、failed、cancelled 及时间和尝试字段。 |
packages/api-contracts/src/openapi.ts | /background-jobs 系列路径 | 描述列表、详情、取消和重试的 HTTP 合同。 |
apps/backend/tests/test_extended_capabilities.py | test_background_runtime_recovers_leases_persists_events_and_retries | 验证执行、事件、租约恢复、取消、新 job 重试和跨 owner 不可见。 |
openspec/specs/background-job-runtime/spec.md | Durable owner-scoped background jobs | 规定租约恢复、注册 handler、持久事件与取消重试语义。 |
📷 [图片 token=AoDhb9jaBoWlFoxBRG7c1hi2n0c(未能下载,见飞书原文)]
代码调用流程图
这张图强调 durable job 的两个核心事实:作业状态先落 SQLite,worker 再凭租约领取;异常是否重试由 attempt 和 maxAttempts 决定。
📷 [图片 token=Vcw9b8DRboyXbXxyefCcNqLfn1b(未能下载,见飞书原文)]
📷 [图片 token=PioTbFPbuoI1QJx0Rprc2lywnFc(未能下载,见飞书原文)]
关键实现拆解
租约领取与进程重启恢复
**看什么:**先看领域 scheduler 如何把稳定的业务 task ID 写进 durable job;这一步解释了 worker 重启后为何仍能重新定位原业务任务。
📷 [图片 token=ZwnybhIT6otBDUx4cT0cFbGunYg(未能下载,见飞书原文)]
    async def schedule(self, *, owner_user_id: str, task_id: str) -> None:
        repository = _background_job_repository_from_app(self._app)
        # 1. 去重键同时带 owner、resource type 和 resource id。
        existing = await repository.find_for_resource(
            owner_user_id=owner_user_id,
            resource_type="document_index_task",
            resource_id=task_id,
        )
        if existing is None:
            # 2. payload 只保存恢复 handler 所需的稳定 task ID。
            await repository.enqueue(
                owner_user_id=owner_user_id,
                job_id=f"job_{uuid4().hex}",
                kind="document_index",
                resource_type="document_index_task",
                resource_id=task_id,
                payload={"taskId": task_id},
                max_attempts=3,
                timeout_seconds=900,
            )
        await _background_job_runtime_from_app(self._app).start()
📷 [图片 token=Zy1GbLOoEo5jI6xmrMhcoxEMnYe(未能下载,见飞书原文)]
这段代码证明 HTTP 请求并不持有实际执行:请求只确保 owner-scoped job 已落库并启动共享 runtime。进程重启时可恢复的是这条持久记录;如果 enqueue 自身失败,业务 task 与通用 job 仍不是一个跨表原子事务。
📷 [图片 token=ZAOCbrcuDoTt2IxV8axchTOenzf(未能下载,见飞书原文)]
**看什么:**再看 claim_next 的同一事务怎样先回收过期租约,再按可用时间挑选一条 queued 记录,并把 worker 身份写回。
📷 [图片 token=PBMMbGU15oBHppxziuAchlggnNb(未能下载,见飞书原文)]
        async with self._session_factory() as session, session.begin():
            # 1. 过期 running 记录先恢复为可领取状态。
            await session.execute(
                update(BackgroundJobModel)
                .where(
                    BackgroundJobModel.status == "running",
                    BackgroundJobModel.lease_expires_at.is_not(None),
                    BackgroundJobModel.lease_expires_at < claimed_at,
                )
                .values(
                    status="queued",
                    lease_owner=None,
                    lease_expires_at=None,
                    available_at=claimed_at,
                    updated_at=claimed_at,
                )
            )
            # … 省略按 available_at、created_at 选取最早作业的代码
            if row is None:
                return None
            # 2. 领取复用同一 job,并增加累计 attempt。
            row.status = "running"
            row.attempt += 1
            row.lease_owner = worker_id
            row.lease_expires_at = lease_expires_at
            row.started_at = row.started_at or claimed_at
📷 [图片 token=YKW7bMrFhoyoIGxQuIZcQko5nsL(未能下载,见飞书原文)]
这里的恢复条件只依赖租约时间,不探测旧进程是否存活。worker 身份会继续被 renew_lease、完成和失败转换校验,因此失去租约的旧 worker 不能合法覆盖后来领取者;SQLite 事务提供的是本地实现的领取边界,不能自动外推到任意多节点数据库。
📷 [图片 token=X8QCbvJthoI9U9x9MC5cgXYcnkg(未能下载,见飞书原文)]
enqueue 创建作业时将状态设为 queued、attempt 设为 0、租约字段置空,并给出 available_at。claim_next 在一个数据库事务中先把租约已过期的 running 记录改回 queued,再选择最早可用作业。被选中的行切到 running,attempt 增加 1,写入 lease_owner 与 lease_expires_at,并只在首次领取时设置 started_at。
📷 [图片 token=DVxjbSMpUofn9jxN1NqcFRYOnJc(未能下载,见飞书原文)]
这意味着重启恢复不是“新建一次尝试记录”,而是保留同一个 job,释放过期租约后再次领取;attempt 会从 1 增至 2。当前表没有独立的 attempt 子表,历史尝试以累计次数和状态字段表达。因此文章或 UI 不应声称可以查看每次 attempt 的完整异常明细。
📷 [图片 token=EEjzbUqKpovF3Vx7h8Mcfn4KnFb(未能下载,见飞书原文)]
Runtime 将最小租约限制为 6 秒,默认 30 秒;心跳间隔是租约时长的三分之一。renew_lease 只有在 job 仍是 running 且 lease_owner 等于当前 worker ID 时才续租。类似地,完成和失败转换也校验 worker ID,过期 worker 无法覆盖后来领取者的终态。
📷 [图片 token=SgMubWvJYocTlUxg1IAcSvrVnBf(未能下载,见飞书原文)]
自动重试、人工重试与超时
**看什么:**下面把 Runtime 的三条终态分支放回重试主题中阅读,重点观察超时、取消和普通异常何时由 Repository 决定同一 job 的下一状态。
📷 [图片 token=Um89b8GqhoSwjlxd9tacfh8dnDl(未能下载,见飞书原文)]
        try:
            # 1. handler 前后检查协作式取消,并施加 job 自身超时。
            await context.raise_if_cancelled()
            await asyncio.wait_for(handler(context), timeout=job.timeout_seconds)
            await context.raise_if_cancelled()
        except JobCancelled:
            await self._repository.mark_cancelled(job_id=job.id, worker_id=worker_id)
            # … 省略结构化取消日志
        except Exception as exc:
            # 2. 自动重试复用当前 job,退避最多 30 秒。
            retry_at = _utc_now() + timedelta(seconds=min(30, 2**job.attempt))
            updated = await self._repository.handle_failure(
                job_id=job.id,
                worker_id=worker_id,
                error_message=_safe_error(exc),
                retry_at=retry_at,
            )
            # … 省略结构化失败日志
        else:
            # 3. 只有正常返回且未收到取消请求才标记成功。
            await self._repository.mark_succeeded(job_id=job.id, worker_id=worker_id)
📷 [图片 token=PN2hbolqwoe9JpxtkVOcRRDjn1K(未能下载,见飞书原文)]
这证明自动重试并不创建新 ID,人工 retry 才复制源作业形成 retry_of_job_id。所有终态写入仍要求匹配 worker_id;超时虽然能取消 await,但不能保证已经进入线程或外部系统的同步副作用被撤销。
📷 [图片 token=PxpJbvYOFo4gT7xsw6yct28fnme(未能下载,见飞书原文)]
每次领取都会增加 attempt。handler 抛出异常时,Runtime 计算最长 30 秒的指数退避:当前实现使用 min(30, 2 ** attempt) 秒。Repository 的 handle_failure 在 attempt 小于 max_attempts 且没有取消请求时,把同一 job 重新置为 queued 并更新 available_at;否则写入 failed 和 completed_at。默认 max_attempts 为 3。
📷 [图片 token=QLSfb8bXnoBLmaxbhxccAyAanUm(未能下载,见飞书原文)]
人工重试走另一条路径。SQLiteBackgroundJobRepository.retry 只接受 failed 或 cancelled 的源作业,复制 kind、resource、payload、最大次数与超时,生成新 job,并用 retry_of_job_id 连接来源。这使“自动重跑同一 job”和“用户明确创建一个新尝试”在数据上可区分。
📷 [图片 token=VYHMb06XAoEV1nxpephcDz0onK3(未能下载,见飞书原文)]
asyncio.wait_for 为 handler 提供硬超时边界。超时被转成固定文本 Background job timed out.。其他异常由 _safe_error 取字符串并截断到 1000 个字符;它并不是通用凭据脱敏器,所以 handler 仍必须抛出经过清理的领域错误,不能把上游原始响应直接带入异常。
📷 [图片 token=XgFJbQjaFoiXKOxRA3RcTbdAnXf(未能下载,见飞书原文)]
事件与协作式取消
**看什么:**看取消请求如何根据当前状态分流:queued 立即终止,running 只记录请求时间,等待 handler 在安全边界读取。
📷 [图片 token=Mo03bCvCsoA7HkxMoMbcY5cCnAb(未能下载,见飞书原文)]
        async with self._session_factory() as session, session.begin():
            row = await session.get(BackgroundJobModel, job_id)
            # 1. 不存在或跨 owner 都不返回作业详情。
            if row is None or row.owner_user_id != owner_user_id:
                return None
            if row.status == "queued":
                # 2. 尚未领取的作业可以直接进入终态。
                row.status = "cancelled"
                row.completed_at = now
            elif row.status == "running":
                # 3. 已运行作业只设置协作式取消标记。
                row.cancel_requested_at = now
            row.updated_at = now
📷 [图片 token=Vc8pbiNYIoqJVLxYCPAcO98vnrg(未能下载,见飞书原文)]
这段实现没有强杀 worker。running job 只有在 Runtime 或业务 handler 再次调用取消检查时才会停下,因此一次正在进行的 embedding、Milvus 或其他不可取消调用可能继续到返回;owner 条件则阻止用户借 job ID 控制他人的任务。
📷 [图片 token=IquTbaeQnoBzZPxQaZMcS9lpnVp(未能下载,见飞书原文)]
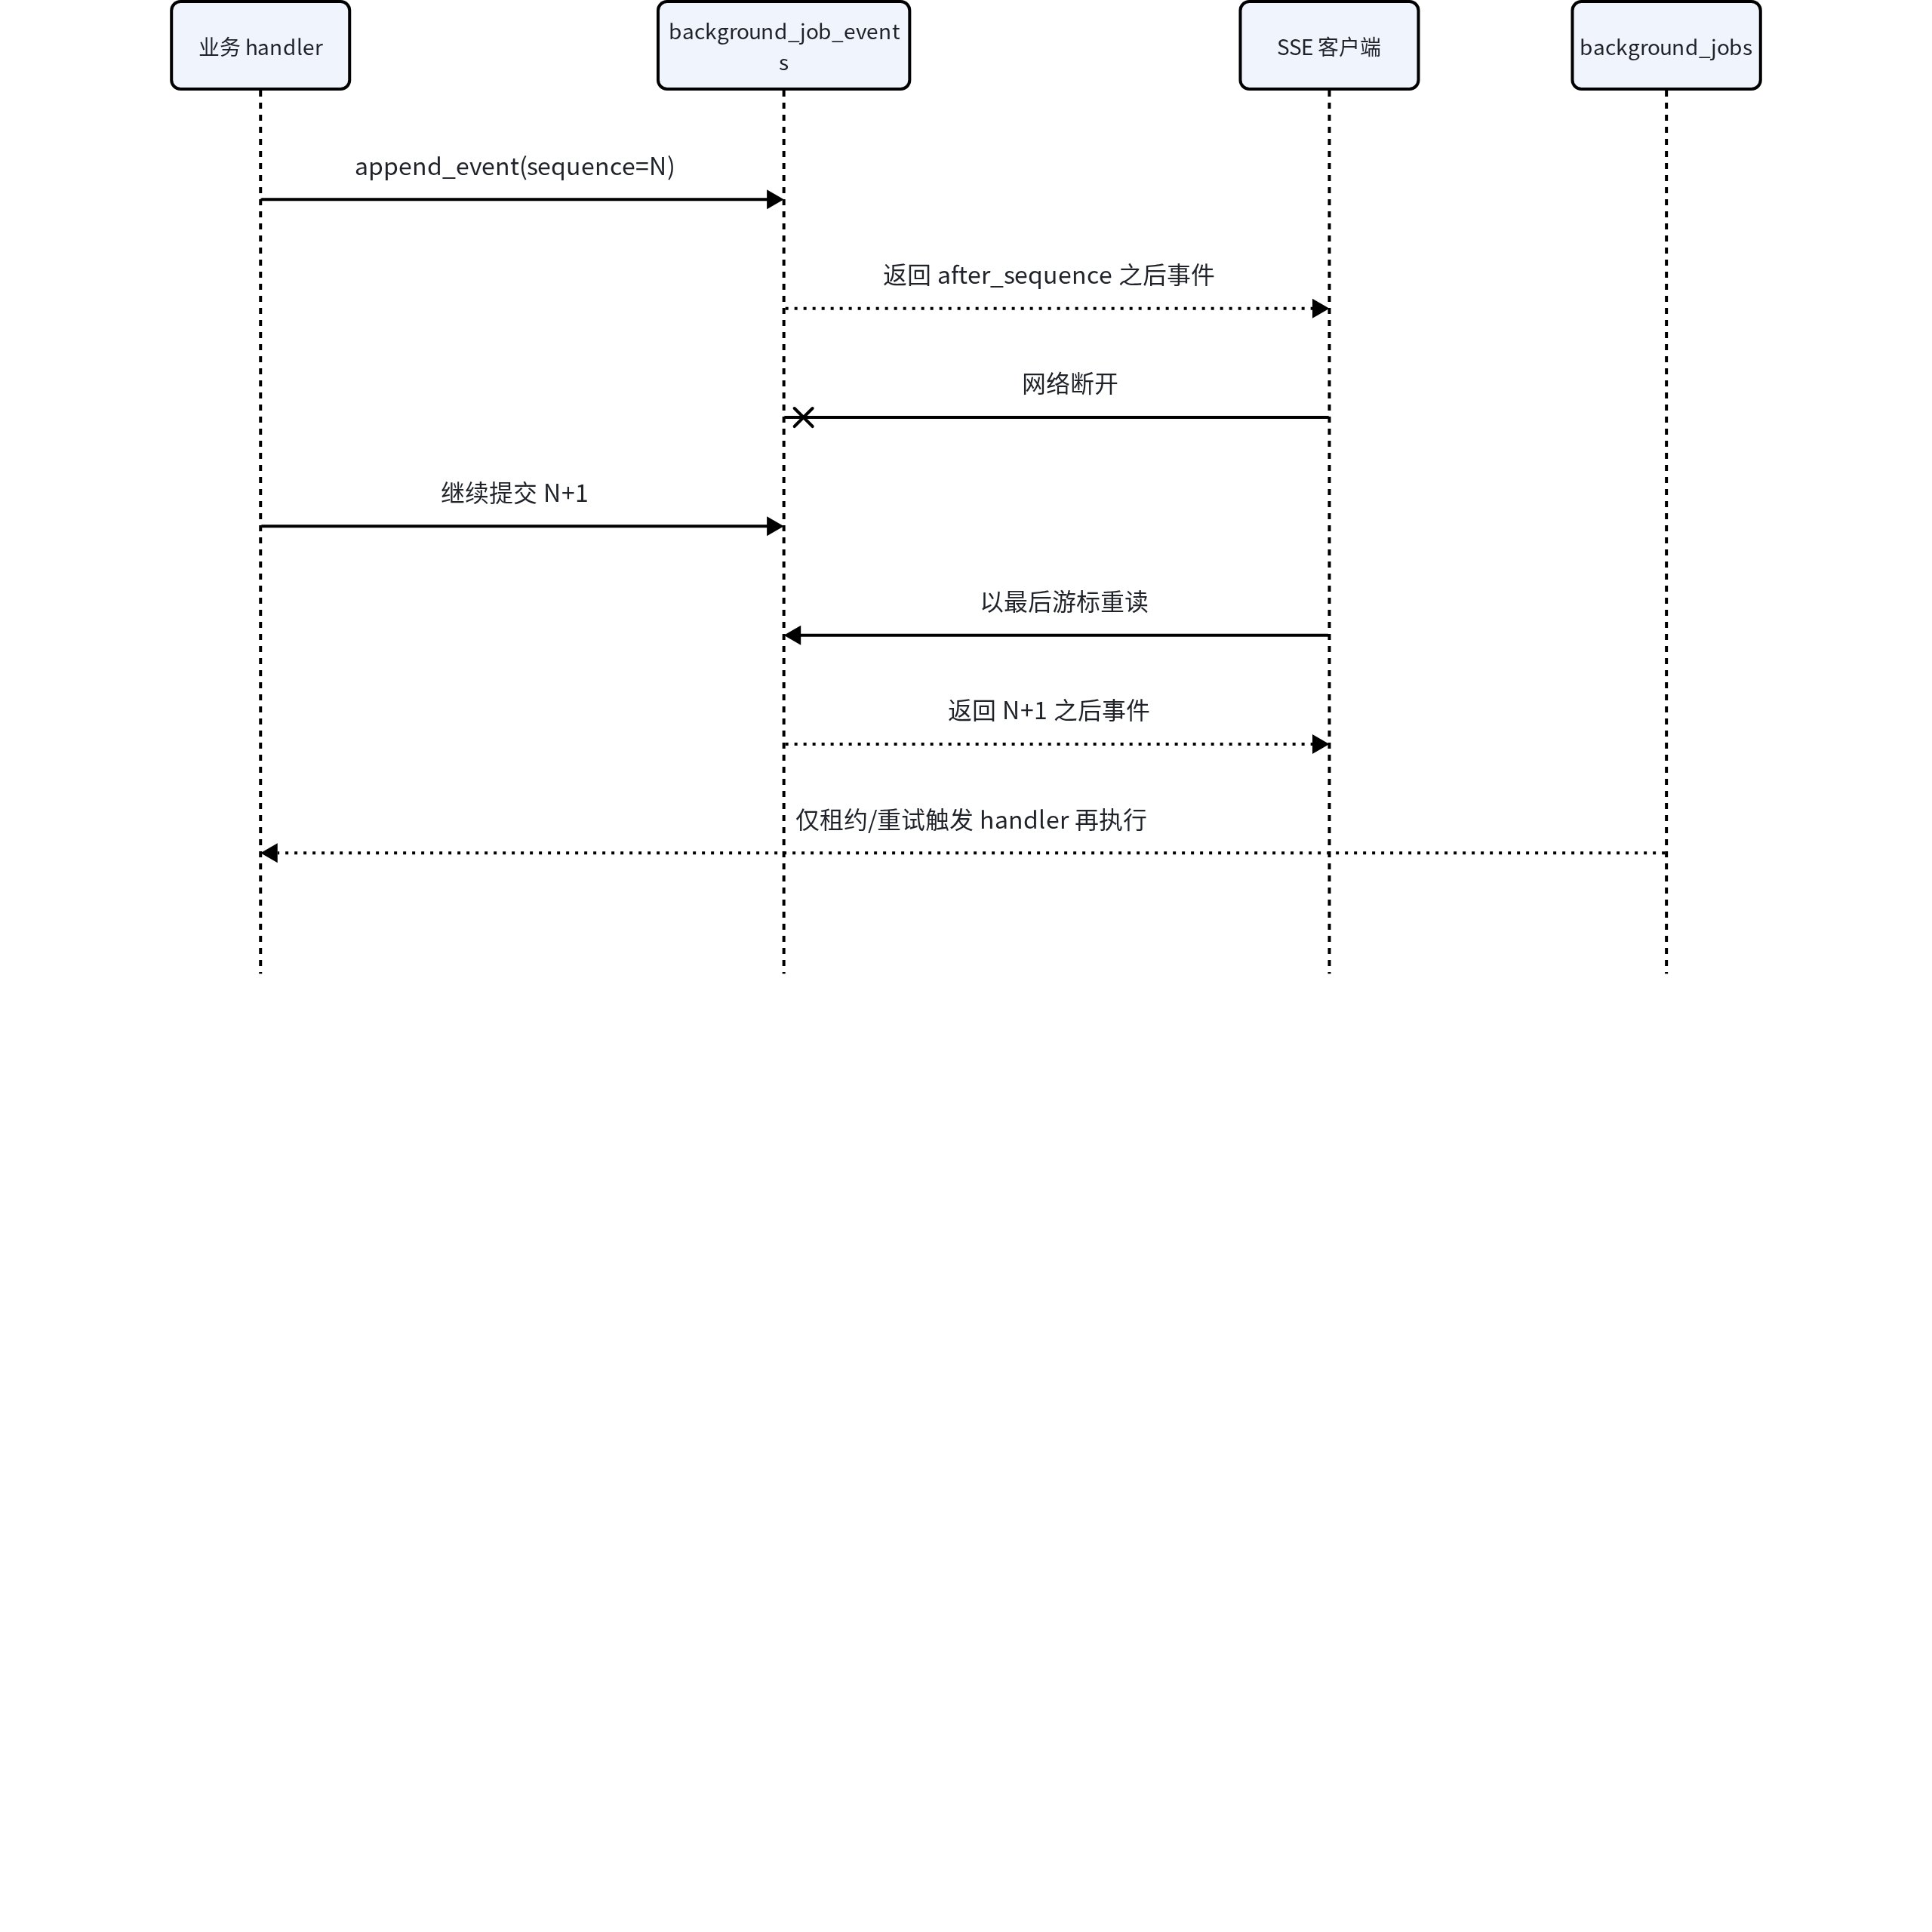
BackgroundJobContext.append_event 将事件写入 background_job_events。Repository 在事务中读取当前最大 sequence,加一后写入,并通过 owner、job、sequence 索引支持 after_sequence 断点读取。AIOps handler 在每个诊断事件后持久化事件,因此浏览器断线不等于任务停止。
📷 [图片 token=UCCsbrAGjoeIPaxzk87cnuMrnAg(未能下载,见飞书原文)]
取消是协作式的。queued job 会立即变为 cancelled;running job 只写 cancel_requested_at。Runtime 在 handler 前后检查一次,具体 handler 也可在安全边界调用 raise_if_cancelled。AIOps handler 在事件循环中反复检查,文档索引 handler 则在进入索引服务前检查;它不会强行中断正在进行的一次 embedding 或 Milvus 调用。API 的 _cancel_background_resource 还同步更新对应的文档索引任务或诊断任务业务状态。
📷 [图片 token=TLfTbClkcohotixcXO5c624vnGh(未能下载,见飞书原文)]
用一次故障过程理解状态机
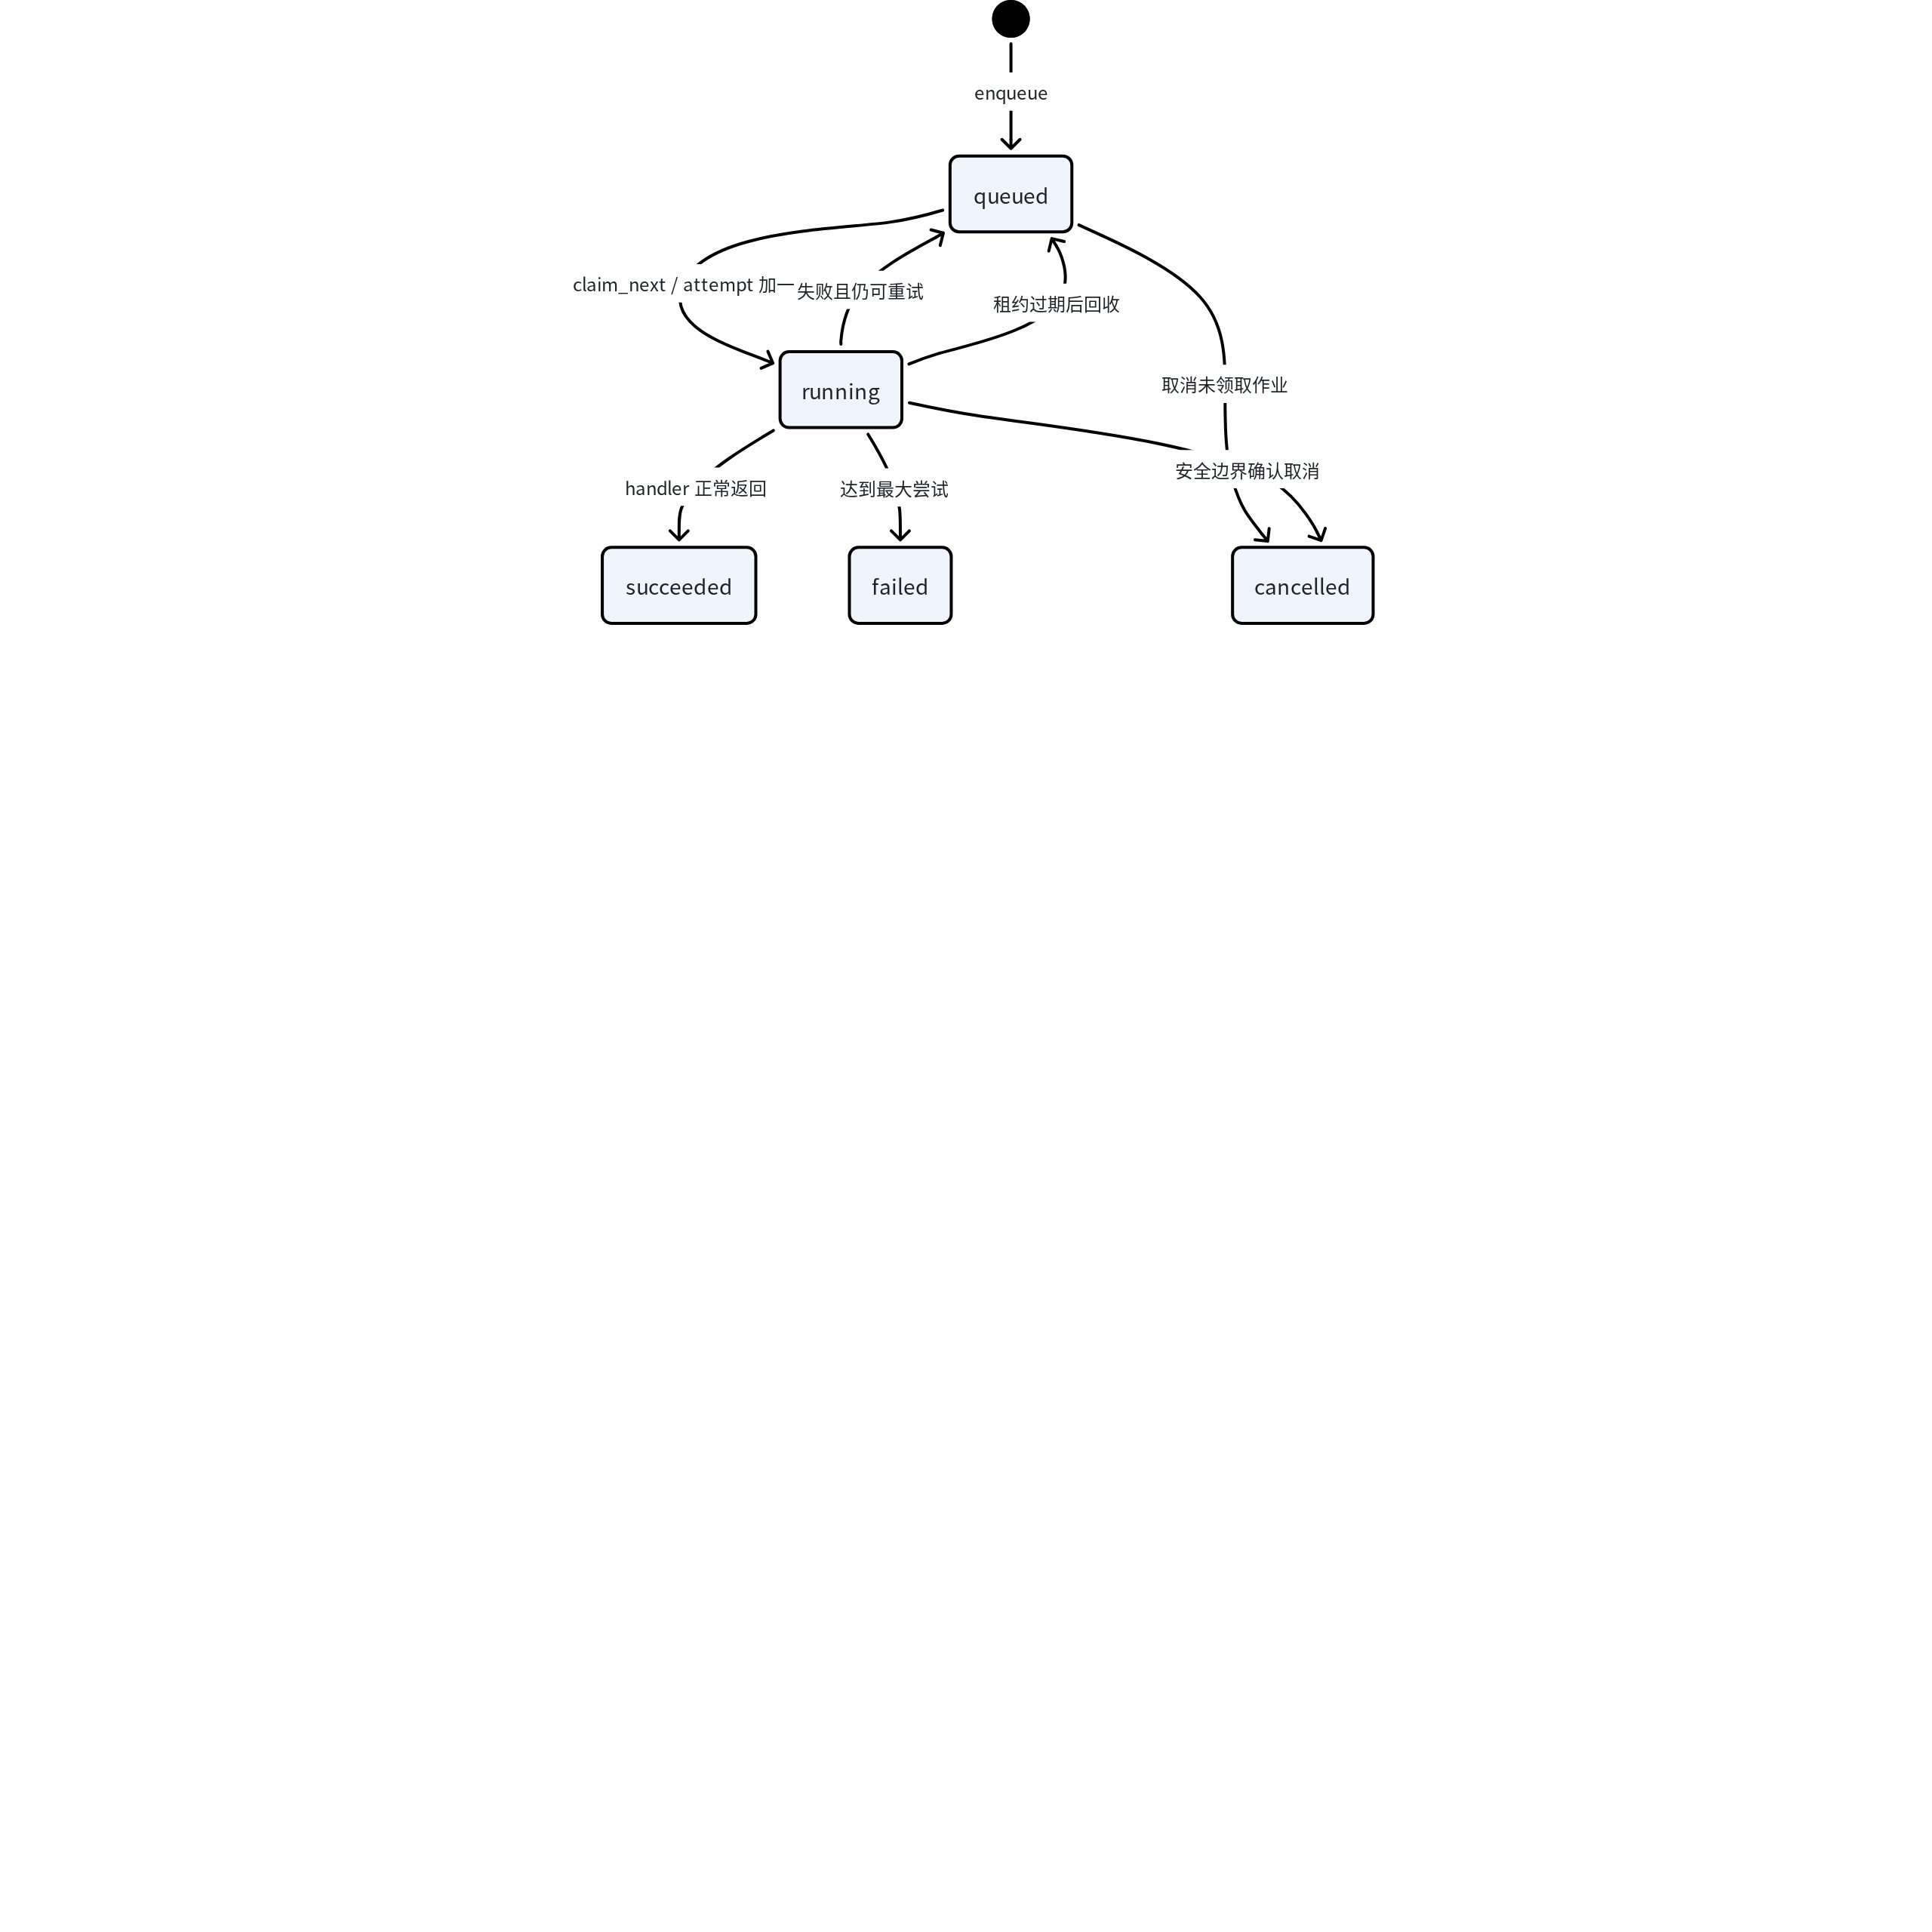
**看什么:**这张局部状态图只画通用 job 的持久状态;业务 task 的 running、failed、succeeded 在另一张表中更新,不能与这里误认为同一次提交。
📷 [图片 token=FTobbJHafogzLtxkqpJcdujunIc(未能下载,见飞书原文)]
📷 [图片 token=AOKsbAVYsoGAQ3x0zAEcO3G3ntd(未能下载,见飞书原文)]
图中 running 回到 queued 有两种不同原因:失败退避会把 available_at 推迟,租约回收则在下一次领取事务中恢复可用。两条路径都保留同一 job;如果业务记录已先更新,短时间观察到两个表状态不一致是当前设计允许的瞬态。
📷 [图片 token=COzab5NVmoddLixcuvfct8Vlnif(未能下载,见飞书原文)]
可以用“文档索引首次调用 embedding 超时、第二次成功”来串起全部字段。API 创建业务索引任务后,scheduler 入队 job,此时 status 是 queued、attempt 是 0、available_at 是当前时间。某个 worker 领取后,status 变为 running,attempt 变为 1,写入 worker 专属租约。handler 内部索引服务会先把业务任务设为 running;embedding 超时后,业务任务先记录 failed,handler 再抛出异常给通用 runtime。
📷 [图片 token=UYY2bhG70ovmhcxrkUqcwRBEnlc(未能下载,见飞书原文)]
通用 runtime 捕获异常后不会创建新 job。只要 attempt 尚未达到 max_attempts,它会清空租约,把同一 job 放回 queued,并把 available_at 推到退避时间。下一次领取把 attempt 增至 2。文档索引 handler 再次执行时会重新读取同一 owner 下的业务任务和文档;当前服务允许它从 failed 业务任务重新进入 running。第二次成功后,文档成为 indexed,业务任务成为 succeeded,通用 job 最后成为 succeeded。这个顺序也说明短时间内可能观察到“业务记录已成功、通用 job 仍是 running”的瞬态,消费者不应把多个表假设为一次原子提交。
📷 [图片 token=GnmubD7uPoLnWTxRsm1cbHQPnNg(未能下载,见飞书原文)]
若进程在第二次执行中直接退出,SQLite 中仍保留 running 和租约到期时间。新进程启动 worker 后,第一次 claim_next 会先回收所有过期 running 记录,再选择可用 job。它不会依据旧进程是否真的死亡做网络探测,而是完全信任租约时间。因此机器时钟和数据库时间语义必须稳定;当前实现统一使用带 UTC 时区的 datetime,Repository 也把更新时间写回同一模式。
📷 [图片 token=UzZabF1ckoBk3HxbMtrcxMChn49(未能下载,见飞书原文)]
并发限制与调度公平性
**看什么:**看 Runtime 如何把 concurrency 直接展开成固定数量的 worker task;每个 worker 都要等当前 handler 完整结束后才领取下一条。
📷 [图片 token=DlJobKsR2oxhGIxaNZLcq3wGn3d(未能下载,见飞书原文)]
    async def start(self) -> None:
        # 1. 已有 worker 时直接返回,重复 start 不扩容。
        if self._workers:
            return
        self._stopping.clear()
        self._workers = [
            asyncio.create_task(self._worker_loop(index), name=f"background-worker-{index}")
            for index in range(self._concurrency)
        ]

    # … 省略 stop 方法
    async def _worker_loop(self, index: int) -> None:
        worker_id = f"{self._runtime_id}:{index}"
        while not self._stopping.is_set():
            now = _utc_now()
            # 2. 单个 worker 一次只领取并执行一个 job。
            job = await self._repository.claim_next(
                worker_id=worker_id,
                lease_expires_at=now + timedelta(seconds=self._lease_seconds),
                now=now,
            )
            if job is None:
                await asyncio.sleep(self._poll_seconds)
                continue
            await self._execute(job, worker_id)
📷 [图片 token=ZgRMbwWwxoA6mzxiHKMczfrgn1c(未能下载,见飞书原文)]
总并发上限就是 worker 数,默认 2;它不是按 owner 或 kind 分配的配额。停止时 task 会被取消而不是等待全部 handler 排空,因此未完成工作依赖租约恢复,外部副作用仍须由 handler 自己设计成可重入或可辨识重复执行。
📷 [图片 token=OaqbbiqvBoUz5kx2DJTcvHC5nRg(未能下载,见飞书原文)]
BackgroundJobRuntime 默认创建两个 worker task,构造参数可调整 concurrency,但至少为 1。每个 worker 都是“领取一个、完整执行、再领取下一个”的串行循环,因此总并发上限就是 worker 数。没有作业时,worker 按 poll_seconds 轮询,最小间隔为 0.05 秒。停止 runtime 会设置 stopping event 并取消 worker tasks;它不是优雅等待全部 handler 结束的排空协议,所以进程关闭期间未完成的工作依赖租约过期恢复。
📷 [图片 token=QznCbiQvgolmBzxIX6QcqzHAnrg(未能下载,见飞书原文)]
Repository 按 available_at 升序、created_at 升序领取,先到可用的作业优先。它没有按 owner 做轮转,也没有 kind 级队列、优先级或资源配额。如果一个用户短时间入队大量长作业,后续其他用户作业可能等待。当前本地单机定位和两个业务 kind 使简单策略可用,但将来扩大并发或多租户负载时,公平调度必须作为新的显式能力设计,不能从现有 owner 过滤推断已经具备。
📷 [图片 token=UxQgbiWH0o7HM3x2shVcfFIrnXc(未能下载,见飞书原文)]
同一个 runtime 的 start 是幂等的:已有 worker 列表时直接返回。scheduler 可以在每次任务创建后安全调用 start,而不会重复创建整组 worker。handler 注册则相反,同一 kind 重复注册会抛 ValueError,避免后注册逻辑悄悄覆盖原处理器。这一约束让应用装配阶段的问题尽早暴露。
📷 [图片 token=VpRcb2WzFokpO4x6eWWck5N4nwc(未能下载,见飞书原文)]
事件恢复与业务恢复不是一回事
**看什么:**用这张序列图区分“事件游标恢复”和“业务 handler 重跑”。前者只读取已提交 payload,后者由 job 状态与租约决定是否再次执行。
📷 [图片 token=KGmWbVKd2oYn98xuzRzcmtMdnuh(未能下载,见飞书原文)]
📷 [图片 token=WB0GbxbQcosrUSxoCUoc2eIUnKb(未能下载,见飞书原文)]
sequence 只在单个 job 内单调递增,不能当作全局事件号。网络重连不会自动重放尚未提交的事件,也不会触发文档索引重新执行;而 handler 重跑可能产生新的业务副作用,却不保证所有 kind 都写逐步事件。
📷 [图片 token=Z04jbqAFLogULqxup1hcX2UwnKe(未能下载,见飞书原文)]
background job event 的 sequence 只在单个 job 内单调递增。list_events(after_sequence=n) 返回 n 之后的事件,适合订阅者保存游标后继续读取。事件 payload 是 JSON 字典,通用 runtime 不解释其业务含义;AIOps 可以写计划、工具、证据和报告事件,其他 kind 也能写自己的结构。事件恢复只保证曾经提交的 payload 仍可读,不会重新生成在进程崩溃前尚未提交的那一个事件。
📷 [图片 token=EFpjbg8daoHjo0xgrK2cpUBznHh(未能下载,见飞书原文)]
普通文档索引 handler 当前不调用 append_event,页面主要轮询 DocumentIndexTaskRecord;AIOps handler 才在流式诊断循环中持续保存事件。因此“runtime 支持持久事件”不等于每一种后台工作已经提供逐步骤事件流。通用 BackgroundJob 契约本身也只暴露任务字段,没有把事件列表合并进详情响应。
📷 [图片 token=A71ibiG8DouK5rxrFssccpOInuh(未能下载,见飞书原文)]
人工 retry 复制源 job 的 payload,但业务资源仍指向原 resource ID。对文档索引而言,页面通常使用领域级 retry API 新建一个业务 task,再由 scheduler 为这个新 task 建 job;通用 job retry 则直接重试同一 resource。两种入口都真实存在,产品层应根据是否需要新的业务 attempt 记录选择,不能无差别混用。
📷 [图片 token=D2P3bL2skouEm4xwYeScbiaanUc(未能下载,见飞书原文)]
迁移、索引与可观察字段
**看什么:**最后看 migration 中直接服务调度和恢复查询的索引,而不是只看 ORM 字段列表。
📷 [图片 token=URE5bCvFmoDBuOxRllQcdM16nLe(未能下载,见飞书原文)]
    # 1. worker 按状态和 available_at 找可领取作业。
    op.create_index(
        "ix_background_jobs_status_available", "background_jobs", ["status", "available_at"]
    )
    # 2. scheduler 的资源去重查询包含 owner scope。
    op.create_index(
        "ix_background_jobs_resource",
        "background_jobs",
        ["owner_user_id", "resource_type", "resource_id"],
    )
    # … 省略事件表字段定义
    # 3. 事件断点读取按 owner、job、sequence 定位。
    op.create_index(
        "ix_background_job_events_owner_job_sequence",
        "background_job_events",
        ["owner_user_id", "job_id", "sequence"],
    )
📷 [图片 token=C3MZbiB9Qo5vuIxa5IAcSePJngu(未能下载,见飞书原文)]
这些索引证明常用访问路径都把 owner 或状态条件落在持久层,但索引本身不是授权机制;Repository 仍必须在查询中显式带 owner。迁移还保留 payload 与 lease 内部字段,而公开契约刻意不返回它们,避免调度输入和 worker 身份泄露到客户端。
📷 [图片 token=DuwUbqyoCongyhxipiZcQbghnTf(未能下载,见飞书原文)]
Alembic migration 为 status 与 available_at 建联合索引,支持 worker 快速寻找可领取记录;owner 与 created_at 联合索引服务用户任务列表;owner、resource_type、resource_id 联合索引服务 scheduler 去重查找。租约 owner、租约到期时间和 retry 来源也有索引。事件表用外键关联 job,删除 job 时级联删除事件,并用 job_id 与 sequence 唯一约束保护单个事件位置。
📷 [图片 token=JGY0bBJEkoEpktxsUGXc7JplnBc(未能下载,见飞书原文)]
面向客户端的 BackgroundJob 有 attempt、maxAttempts、timeoutSeconds、availableAt、cancelRequestedAt、retryOfJobId、errorMessage 和完整生命周期时间。它不返回 payload,是为了避免把 handler 内部输入直接暴露;也不返回 lease 字段,避免把调度内部身份当成业务控制能力。用户能判断排队、执行、成功、失败或取消,却不能指定某个 worker 领取作业。
📷 [图片 token=LSY8btISyoB77HxUictcVdUInib(未能下载,见飞书原文)]
结构化可观察日志使用 background.job.started、background.job.completed、background.job.failed 和 background.job.cancelled 等事件,只记录 job ID、kind、是否最终失败和异常类别。runtime 没有记录 job payload 或 handler 输出。日志用于排查执行生命周期,SQLite 才是任务状态事实来源;进程日志丢失不会改变恢复语义。
📷 [图片 token=D28PbuGriocD94xouvkcuIHdncb(未能下载,见飞书原文)]
如果未来把 SQLite Repository 替换为其他数据库,业务 handler 和 Runtime 构造签名可以保持不变,但 claim_next 的并发领取实现必须重新证明原子性。当前“事务中先回收、再选择、再修改”适配本地 SQLite;多节点数据库可能需要行锁、跳过已锁行或原子更新返回。Repository abstraction 提供替换边界,并不自动保证任意实现都具备同样租约安全性。
📷 [图片 token=Wp01btS82oVxbkxhRw7cPhu2nvf(未能下载,见飞书原文)]
数据、契约与状态
BackgroundJobRecord 包含身份和路由字段 id、owner_user_id、kind、resource_type、resource_id;调度字段 status、attempt、max_attempts、timeout_seconds、available_at、租约;控制与追踪字段 cancel_requested_at、retry_of_job_id、error_message 和四类时间戳。共享 TypeScript 契约不向客户端暴露 lease owner 和 lease expiry,这是内部调度细节。
📷 [图片 token=ZHy0bC8kSol8CXxGnQbcE5Xgnqb(未能下载,见飞书原文)]
合法终态是 succeeded、failed、cancelled。queued 可以被取消、被领取或在失败退避后再次出现;running 可以成功、失败、收到取消请求,也可能因租约过期被回收到 queued。业务任务状态并不自动由数据库外键同步,而是 handler 与 API 显式维护。例如文档索引服务会更新 DocumentIndexTaskRecord,通用 runtime 再维护关联 background job。
📷 [图片 token=K8G7bJybzoB593xMIlMcY2Dbnae(未能下载,见飞书原文)]
权限、安全与失败边界
面向用户的 get、list、find、cancel 和 retry 都要求 owner_user_id。跨用户读取返回空,API 再映射为统一 AUTH_FORBIDDEN,不会暴露目标是否存在。事件追加先验证 job owner;事件列表也同时过滤 owner 与 job。系统 worker 的 claim_next 不带 owner,这是内部全局调度入口,但它返回记录后,handler 始终从 job 自身取得 owner 并继续向下传递。
📷 [图片 token=YYJJbqr4ooA2R1xw3B9cqmpJnYe(未能下载,见飞书原文)]
租约提供的是至少一次执行倾向,而不是分布式事务或恰好一次保证。进程可能在外部副作用完成后、终态提交前退出,租约过期后 handler 会再执行。因此具体 handler 需要使用范围删除、幂等写入或业务记录检查来降低重复执行风险。当前文档索引正是在插入前按 tenant、knowledge base、document 删除旧 chunks。
📷 [图片 token=PaXdbrE7XoC8mixSaGucvDOCnPc(未能下载,见飞书原文)]
运行中取消还有一个必须如实说明的竞态:通用取消 API 会立即把关联文档索引任务标成 cancelled,但文档 handler 在进入 run_task 后没有在 embedding 与 Milvus 步骤之间继续检查;索引任务 Repository 的完成转换也不要求前态。因此一次已在执行的索引可能稍后把业务任务改为 succeeded,而 runtime 在 handler 返回后的取消检查又把通用 job 改为 cancelled。当前代码没有把这两个记录包进同一条件事务,观察者需要分别看 job 与业务任务,不能假定它们在中途取消时始终同态。
📷 [图片 token=OF6Mb6OKzoPMNHxQhyAct3PrnKe(未能下载,见飞书原文)]
没有已注册 handler 的 kind 会进入失败处理,而不是被静默丢弃。事件表有 job 与 sequence 的唯一约束,但 append_event 使用“读取最大值再加一”,其正确性依赖 SQLite 事务串行化;若未来切换多节点数据库,需要重新审视高并发事件分配策略。
📷 [图片 token=BQFvbLLbSoRLGHxyFSfcrCApn9c(未能下载,见飞书原文)]
阅读顺序与小结
先读
BackgroundJobRecord与BackgroundJobRepository,建立状态字段词汇。再读
SQLiteBackgroundJobRepository.claim_next、renew_lease和handle_failure,理解状态转换的原子边界。随后读
BackgroundJobRuntime._worker_loop与_execute,观察 Repository 如何被执行器驱动。最后从
create_app的路由、scheduler 和两个 handler 回看业务集成,并沿状态机核对失败、重试和取消边界。
这套实现的核心不是“后台开一个 asyncio task”,而是把调度真相放进 SQLite:worker 可替换,租约可恢复,尝试可计数,控制操作有 owner 范围。与此同时,它明确保留了本地优先方案的现实边界:取消需要合作、外部副作用需要幂等、失败消息清理仍由各领域共同承担。读懂状态转换,比记住某个接口名称更重要。
📷 [图片 token=ETocbrr3toCCsixYlvtcaPI5ngd(未能下载,见飞书原文)]