OncallAgent 的本地运行拓扑刻意把“容器基础设施”和“应用进程”分开。infra/compose.yaml 只运行 etcd、MinIO、Milvus、Attu 与 Alertmanager;FastAPI 后端、Vue 前端和官方 CLS MCP Server 由宿主机启动器运行。这个边界让代码调试、Python 与 Node 依赖保持本机开发体验,同时用 Compose 管理需要持久卷和服务依赖的基础设施。
📷 [图片 token=SBg1bjM26oRTrsxv83qc5iudn7D(未能下载,见飞书原文)]
Milvus 在系统中的职责很窄:只保存知识文档 chunk 的向量和检索所需标量。用户、认证 session、聊天消息、Prompt、Skill、文档元数据、索引任务、AIOps 证据和报告仍由 SQLite Repository 管理。把“向量数据库”理解成应用主数据库会误读删除、恢复和权限语义;它是可重建的知识索引,而不是业务事实的唯一来源。
📷 [图片 token=MiWdbsb2Oo7EN7x5TvKcBozsnxc(未能下载,见飞书原文)]
向量边界同时承担权限责任。每条 chunk 都携带 owner、tenant、知识库、文档和 chunk ID;搜索、标量枚举与删除都必须包含明确范围。授权后的知识库集合为空时,代码直接返回空结果,不建立无范围查询。对 AI Native 系统而言,这条规则比召回率更优先,因为一次无范围检索就可能把其他用户知识暴露给模型。
📷 [图片 token=QqBWbHOrPoW6gVxBTTScX8ynn2c(未能下载,见飞书原文)]
学习目标
📷 [图片 token=Twm6bhNfGo4xCzxs9EHcqyMqnRf(未能下载,见飞书原文)]
理解 Compose 服务依赖、端口、健康检查和宿主机应用边界。
掌握 Milvus collection 的字段、HNSW/COSINE 设置与显式连接生命周期。
追踪文档从 SQLite 元数据、切分、embedding 到范围向量写入的完整流程。
理解向量召回、BM25L、RRF 与 Qwen rerank 如何组合,又如何共享 tenant 范围。
识别 Milvus、embedding 与容器失败时的安全状态和恢复路径。
功能入口与完整调用链
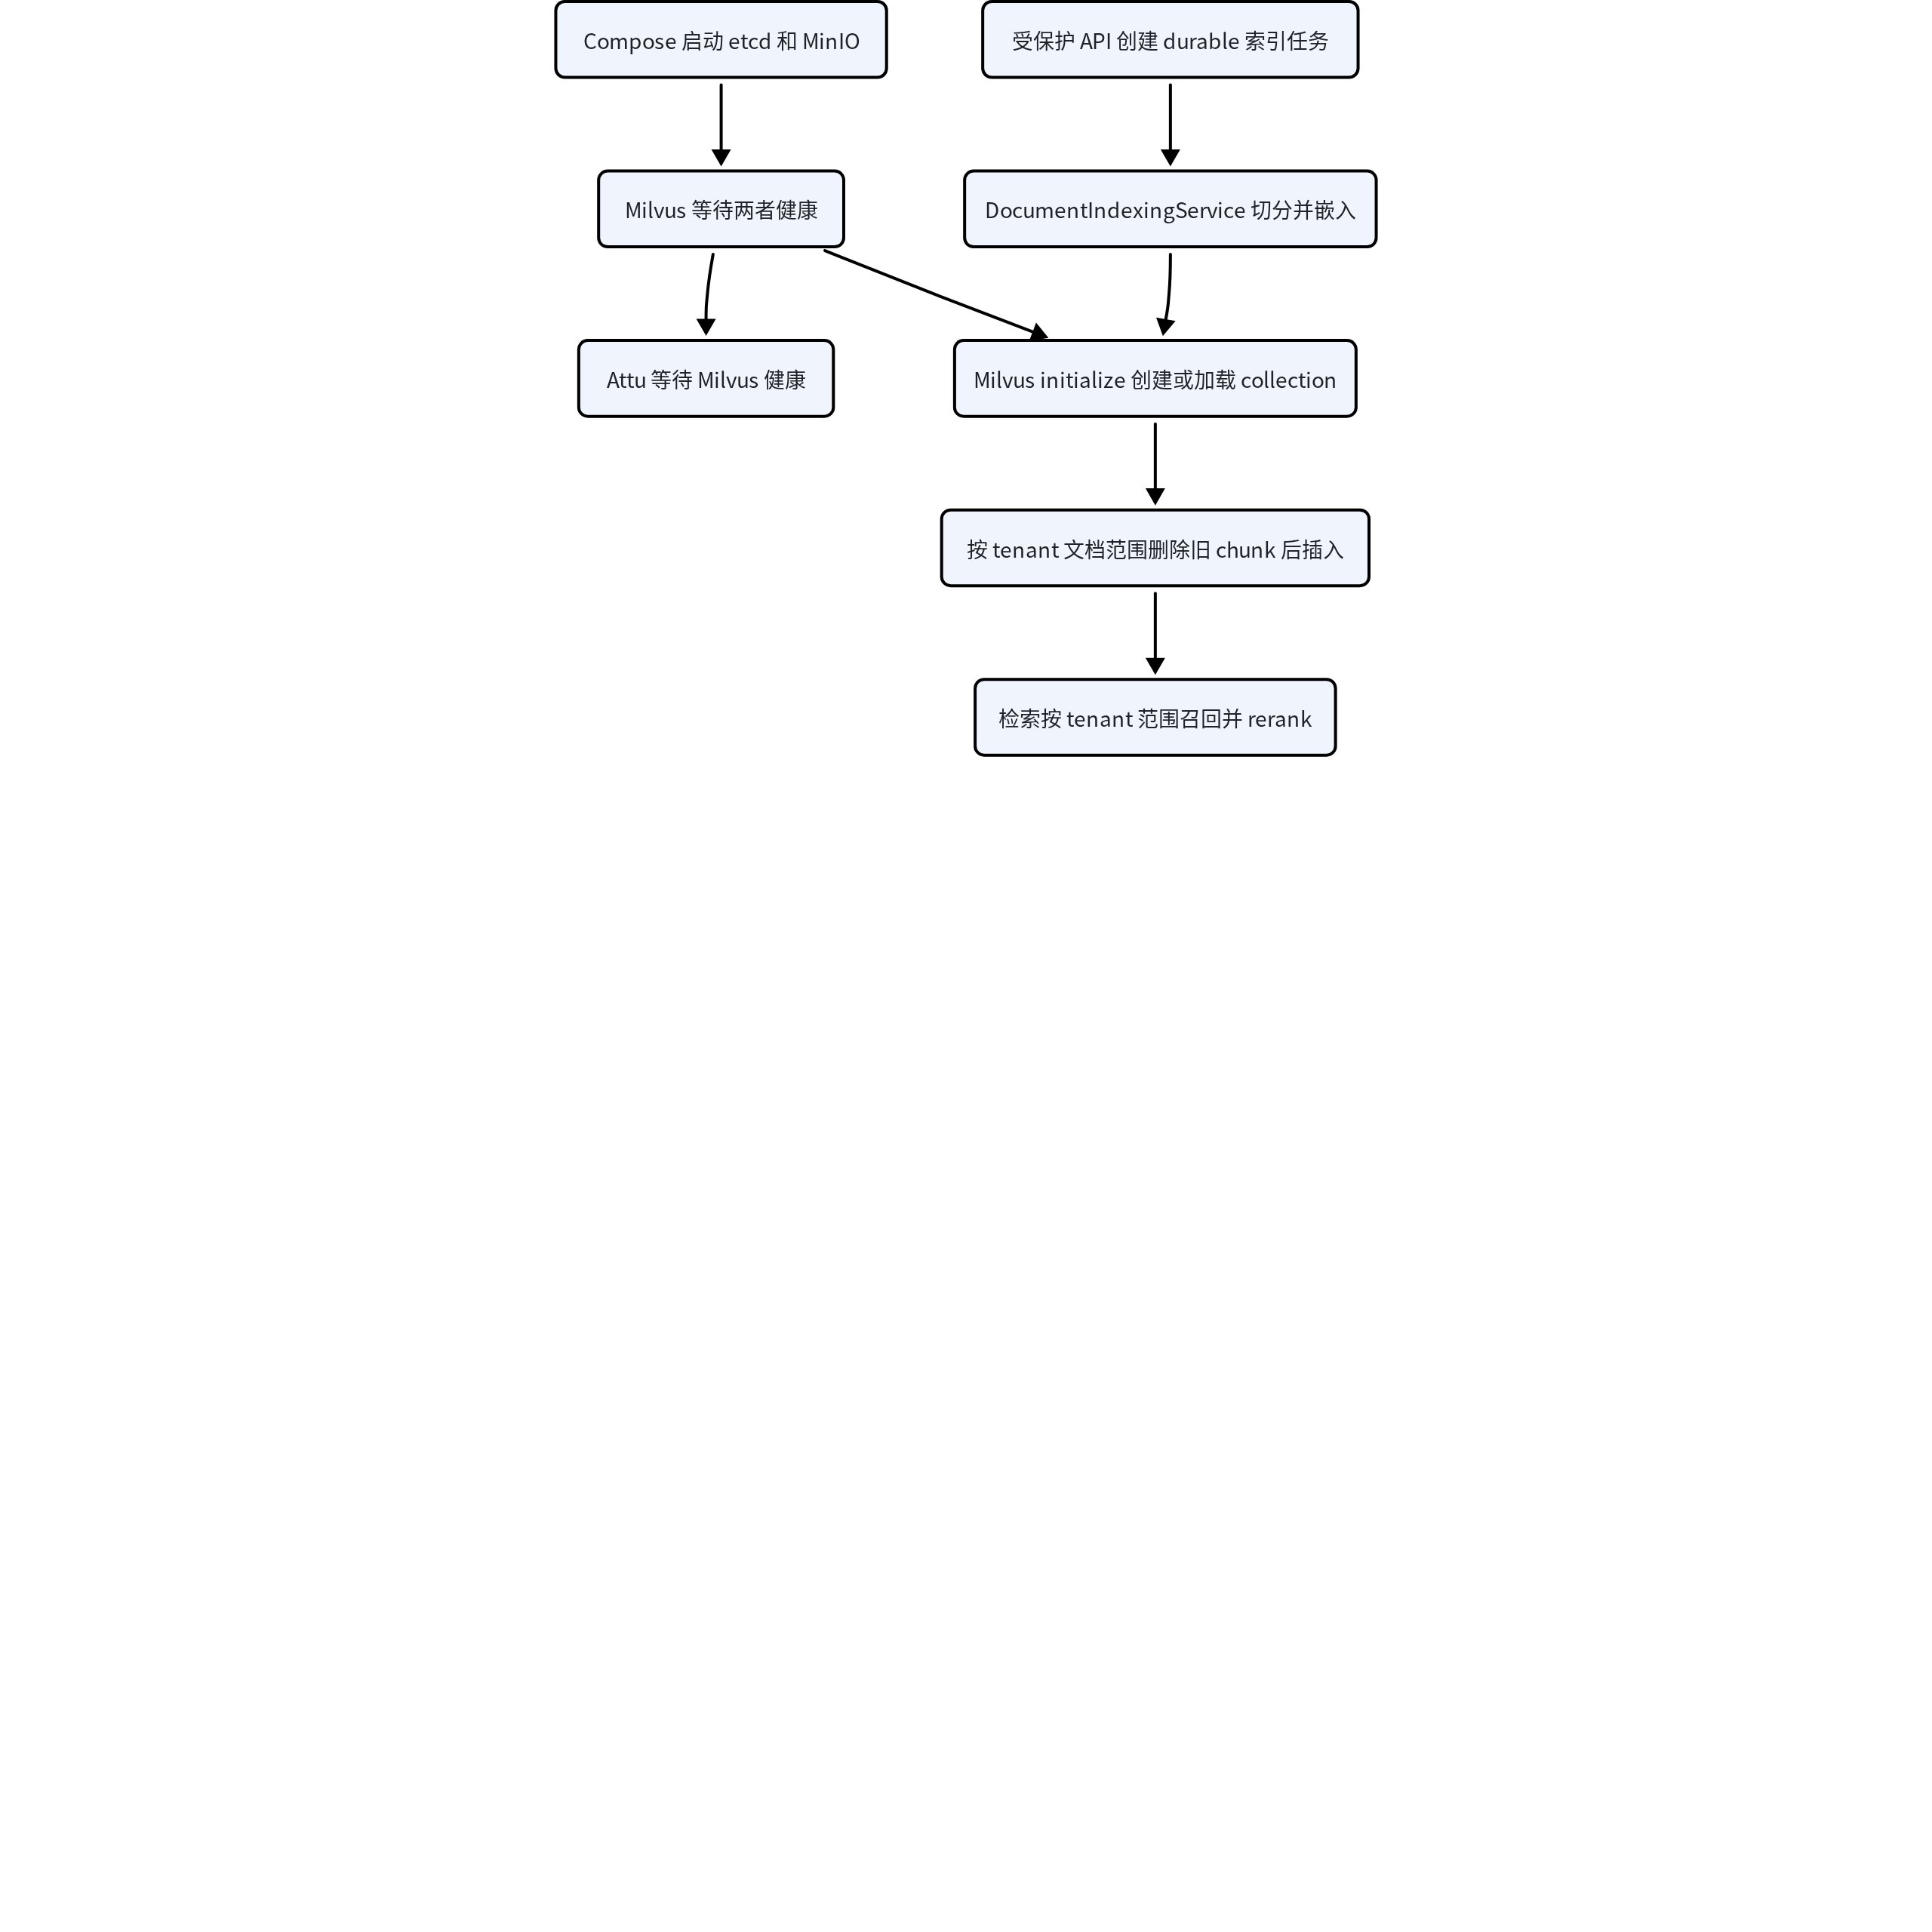
基础设施入口是仓库根目录执行 docker compose -f infra/compose.yaml up -d etcd minio milvus attu alertmanager。etcd 与 MinIO 先通过各自 healthcheck,Milvus 的 depends_on 要求二者 healthy 后启动 standalone 服务,并在 9091 的 healthz 报告健康;Attu 再等待 Milvus healthy。宿主机通过 19530 访问 Milvus,浏览器可通过映射后的 8001 打开 Attu。Alertmanager 独立暴露 9093,并挂载只读配置。
📷 [图片 token=QBSOb8ukJoGHefx08BpcDeZLniZ(未能下载,见飞书原文)]
scripts/start-local.sh 与 scripts/start-local.bat 是完整本机启动器:它们启动 Compose 基础设施,安装依赖、执行 Alembic migration,并在宿主机启动 CLS MCP、后端和前端。由于这些操作会拉取镜像、修改依赖、迁移数据库并创建进程,启动器不是无副作用验证命令。Compose 自身不构建应用镜像,也不包含 backend、frontend 或 MCP 服务。
📷 [图片 token=BDE1b9pY3o3YZ7xJP2ec87QlnBd(未能下载,见飞书原文)]
后端向量设置由 apps/backend/src/super_ai/vector_store/config.py 的 load_milvus_vector_store_settings 从合并项目配置的 vectorStore section 读取。默认语义是本机 19530、collection knowledge_chunks、1024 维、HNSW、COSINE、索引参数 M 16 与 efConstruction 200、搜索参数 ef 64。类型化设置创建 MilvusVectorStore,但不会在模块导入或对象构造时连接。
📷 [图片 token=Isz3bNweeotT2lx6V1ucGqwJnld(未能下载,见飞书原文)]
文档索引从受保护 API 创建 SQLite 业务任务和 durable background job。worker 调用 DocumentIndexingService.run_task,顺序是:owner-scoped 读取任务、标记 running/indexing、读取文档、按持久化策略切分、调用 embedding、验证向量数量、initialize collection、按 tenant/知识库/文档删除旧 chunk、insert_chunks 批量写入、更新 succeeded/indexed。读取文档以及后续切分、模型和向量步骤位于异常捕获范围内,失败会把任务与文档标记为 failed 并保存有界原因;最初的任务读取和 running/indexing 状态更新在该捕获块之外,若这些 Repository 操作本身失败,则由上层 durable job 记录失败,业务记录可能停留在原状态或中间状态。
📷 [图片 token=LVchbnXNSoicZbx1RhNczeHWnlf(未能下载,见飞书原文)]
Markdown / PDF 上传
  → SQLite 保存文档元数据与可索引文本
  → durable document_index job
  → chunk_document_text
  → OpenAI-compatible embedding
  → MilvusVectorStore.initialize
  → tenant + knowledgeBase + document 范围删除
  → 批量 insert knowledge chunk vectors
  → SQLite 更新任务和文档状态
📷 [图片 token=AzvMbewZLoExWexb9k4ciD0Lnc0(未能下载,见飞书原文)]
检索时,KnowledgeRetrievalTool.run 先把调用者请求的知识库与当前用户可访问集合求解;越权 filter 直接抛 AUTH_FORBIDDEN,空集合直接返回空 results/citations。非空时并行执行向量召回和关键词召回:前者为 query 生成 embedding 并调用 search_chunks,后者调用 list_chunks 只读取标量内容,再以内存 BM25L 排名。两路候选用 RRF 融合,最后由 rerank 模型精排并生成带各阶段排名、分数和来源的引用。
📷 [图片 token=ZparbLKkBoEaFJxwUIfcQsKpnwg(未能下载,见飞书原文)]
核心源码地图
| 源码位置 | 关键符号 | 职责 |
|---|---|---|
infra/compose.yaml | etcd、minio、milvus、attu、alertmanager | 定义本地容器拓扑、持久卷、端口、依赖和健康检查。 |
infra/README.md | 基础设施与宿主机应用说明 | 记录启动、停止、端口与“不自动索引/上传”的操作边界。 |
apps/backend/src/super_ai/vector_store/config.py | MilvusVectorStoreSettings、load_milvus_vector_store_settings | 从项目 JSON 加载 collection、维度、索引、metric 与超时。 |
apps/backend/src/super_ai/vector_store/schema.py | build_chunk_collection_schema、build_index_definitions | 以无连接的数据结构定义 collection 字段和标量/向量索引。 |
apps/backend/src/super_ai/vector_store/milvus.py | MilvusConnectionManager、MilvusVectorStore、VectorChunkRecord | 显式连接、初始化、写入、搜索、枚举、删除和健康检查。 |
apps/backend/src/super_ai/memory/vector_scope.py | build_vector_chunk_metadata、build_milvus_tenant_filter | 生成统一权限 metadata 和转义过的 Milvus 范围表达式。 |
apps/backend/src/super_ai/documents/indexing.py | DocumentIndexingService、chunk_document_text、_vector_chunk_record | 切分、embedding、范围重建向量并同步 SQLite 状态。 |
apps/backend/src/super_ai/retrieval/tool.py | KnowledgeRetrievalTool、_resolve_knowledge_base_ids | 授权知识库过滤、双路召回、融合、rerank 和引用构造。 |
apps/backend/src/super_ai/retrieval/hybrid.py | rank_bm25_documents、reciprocal_rank_fusion、RRF_K | 提供中英运维文本 token 化、BM25L 排名和确定性 RRF。 |
apps/backend/src/super_ai/api/app.py | _milvus_readiness_payload、文档与索引路由 | 把向量存储接到 API、后台任务和安全 readiness。 |
📷 [图片 token=F1EKbzOOFopP7sxflbTcQOkXnrc(未能下载,见飞书原文)]
代码调用流程图
图中上半部分是 Compose 基础设施依赖,下半部分是应用侧索引与检索链路。二者通过 Milvus 的连接和 collection 边界汇合。
📷 [图片 token=AhwvbenrDo1VBpxuIaTccj7Zn9c(未能下载,见飞书原文)]
关键实现拆解
Collection schema 与索引
build_chunk_collection_schema 定义十个字段:主键 chunkId,以及 documentId、knowledgeBaseId、ownerUserId、tenantId、content、source、createdAt、JSON metadata 和 FLOAT_VECTOR vector。vector 的 dimension 来自设置,而不是 schema 常量写死。dynamic field 被禁用,减少意外字段绕过审查。
📷 [图片 token=OscCbDjN0o2jslx5RZUcmJofnDb(未能下载,见飞书原文)]
build_index_definitions 为 tenant、知识库、owner、文档与时间标量字段生成 AUTOINDEX,再为 vector 使用配置的 HNSW/COSINE 参数。initialize 连接后构造 PyMilvus schema 和 index params;collection 不存在时创建,已存在时确保索引,然后 load collection。它不会在 Python import 阶段创建客户端,pymilvus 也通过 import_module 在构造真实 schema 时才加载。
📷 [图片 token=LYsNbN3r6o21WUxYWbxciM8pn0g(未能下载,见飞书原文)]
看什么:collection 把权限范围放在顶层标量,并让向量维度直接来自当前设置。
        fields=(
            MilvusFieldDefinition(CHUNK_ID_FIELD, "VARCHAR", is_primary=True, max_length=128),
            MilvusFieldDefinition(DOCUMENT_ID_FIELD, "VARCHAR", max_length=128),
            MilvusFieldDefinition(KNOWLEDGE_BASE_ID_FIELD, "VARCHAR", max_length=128),
            # 1. owner、tenant、知识库和文档都是可过滤标量。
            MilvusFieldDefinition(OWNER_USER_ID_FIELD, "VARCHAR", max_length=128),
            MilvusFieldDefinition(TENANT_ID_FIELD, "VARCHAR", max_length=128),
            MilvusFieldDefinition(CONTENT_FIELD, "VARCHAR", max_length=65535),
            MilvusFieldDefinition(SOURCE_FIELD, "VARCHAR", max_length=1024),
            MilvusFieldDefinition(CREATED_AT_FIELD, "INT64"),
            MilvusFieldDefinition(METADATA_FIELD, "JSON"),
            # 2. 向量维度由配置决定,不在 schema 中写死。
            MilvusFieldDefinition(
                VECTOR_FIELD,
                "FLOAT_VECTOR",
                dimension=settings.vector_dimension,
            ),
        )
📷 [图片 token=D4zNb858Po5LewxK7xwcsIdqnSd(未能下载,见飞书原文)]
代码证明 Milvus 只保存知识 chunk 及其权限标量,而不是用户、聊天或诊断表。维度不匹配会在写入边界失败;dynamic field 关闭后,新增字段必须通过 schema 变更显式进入审查,不能依赖任意 metadata 绕过顶层过滤。
📷 [图片 token=BeZ0bLmMto9JAvxJrQ4cqEPHnrg(未能下载,见飞书原文)]
看什么:初始化分支对缺失和已存在 collection 采取不同动作,但两者最终都确保索引并 load。
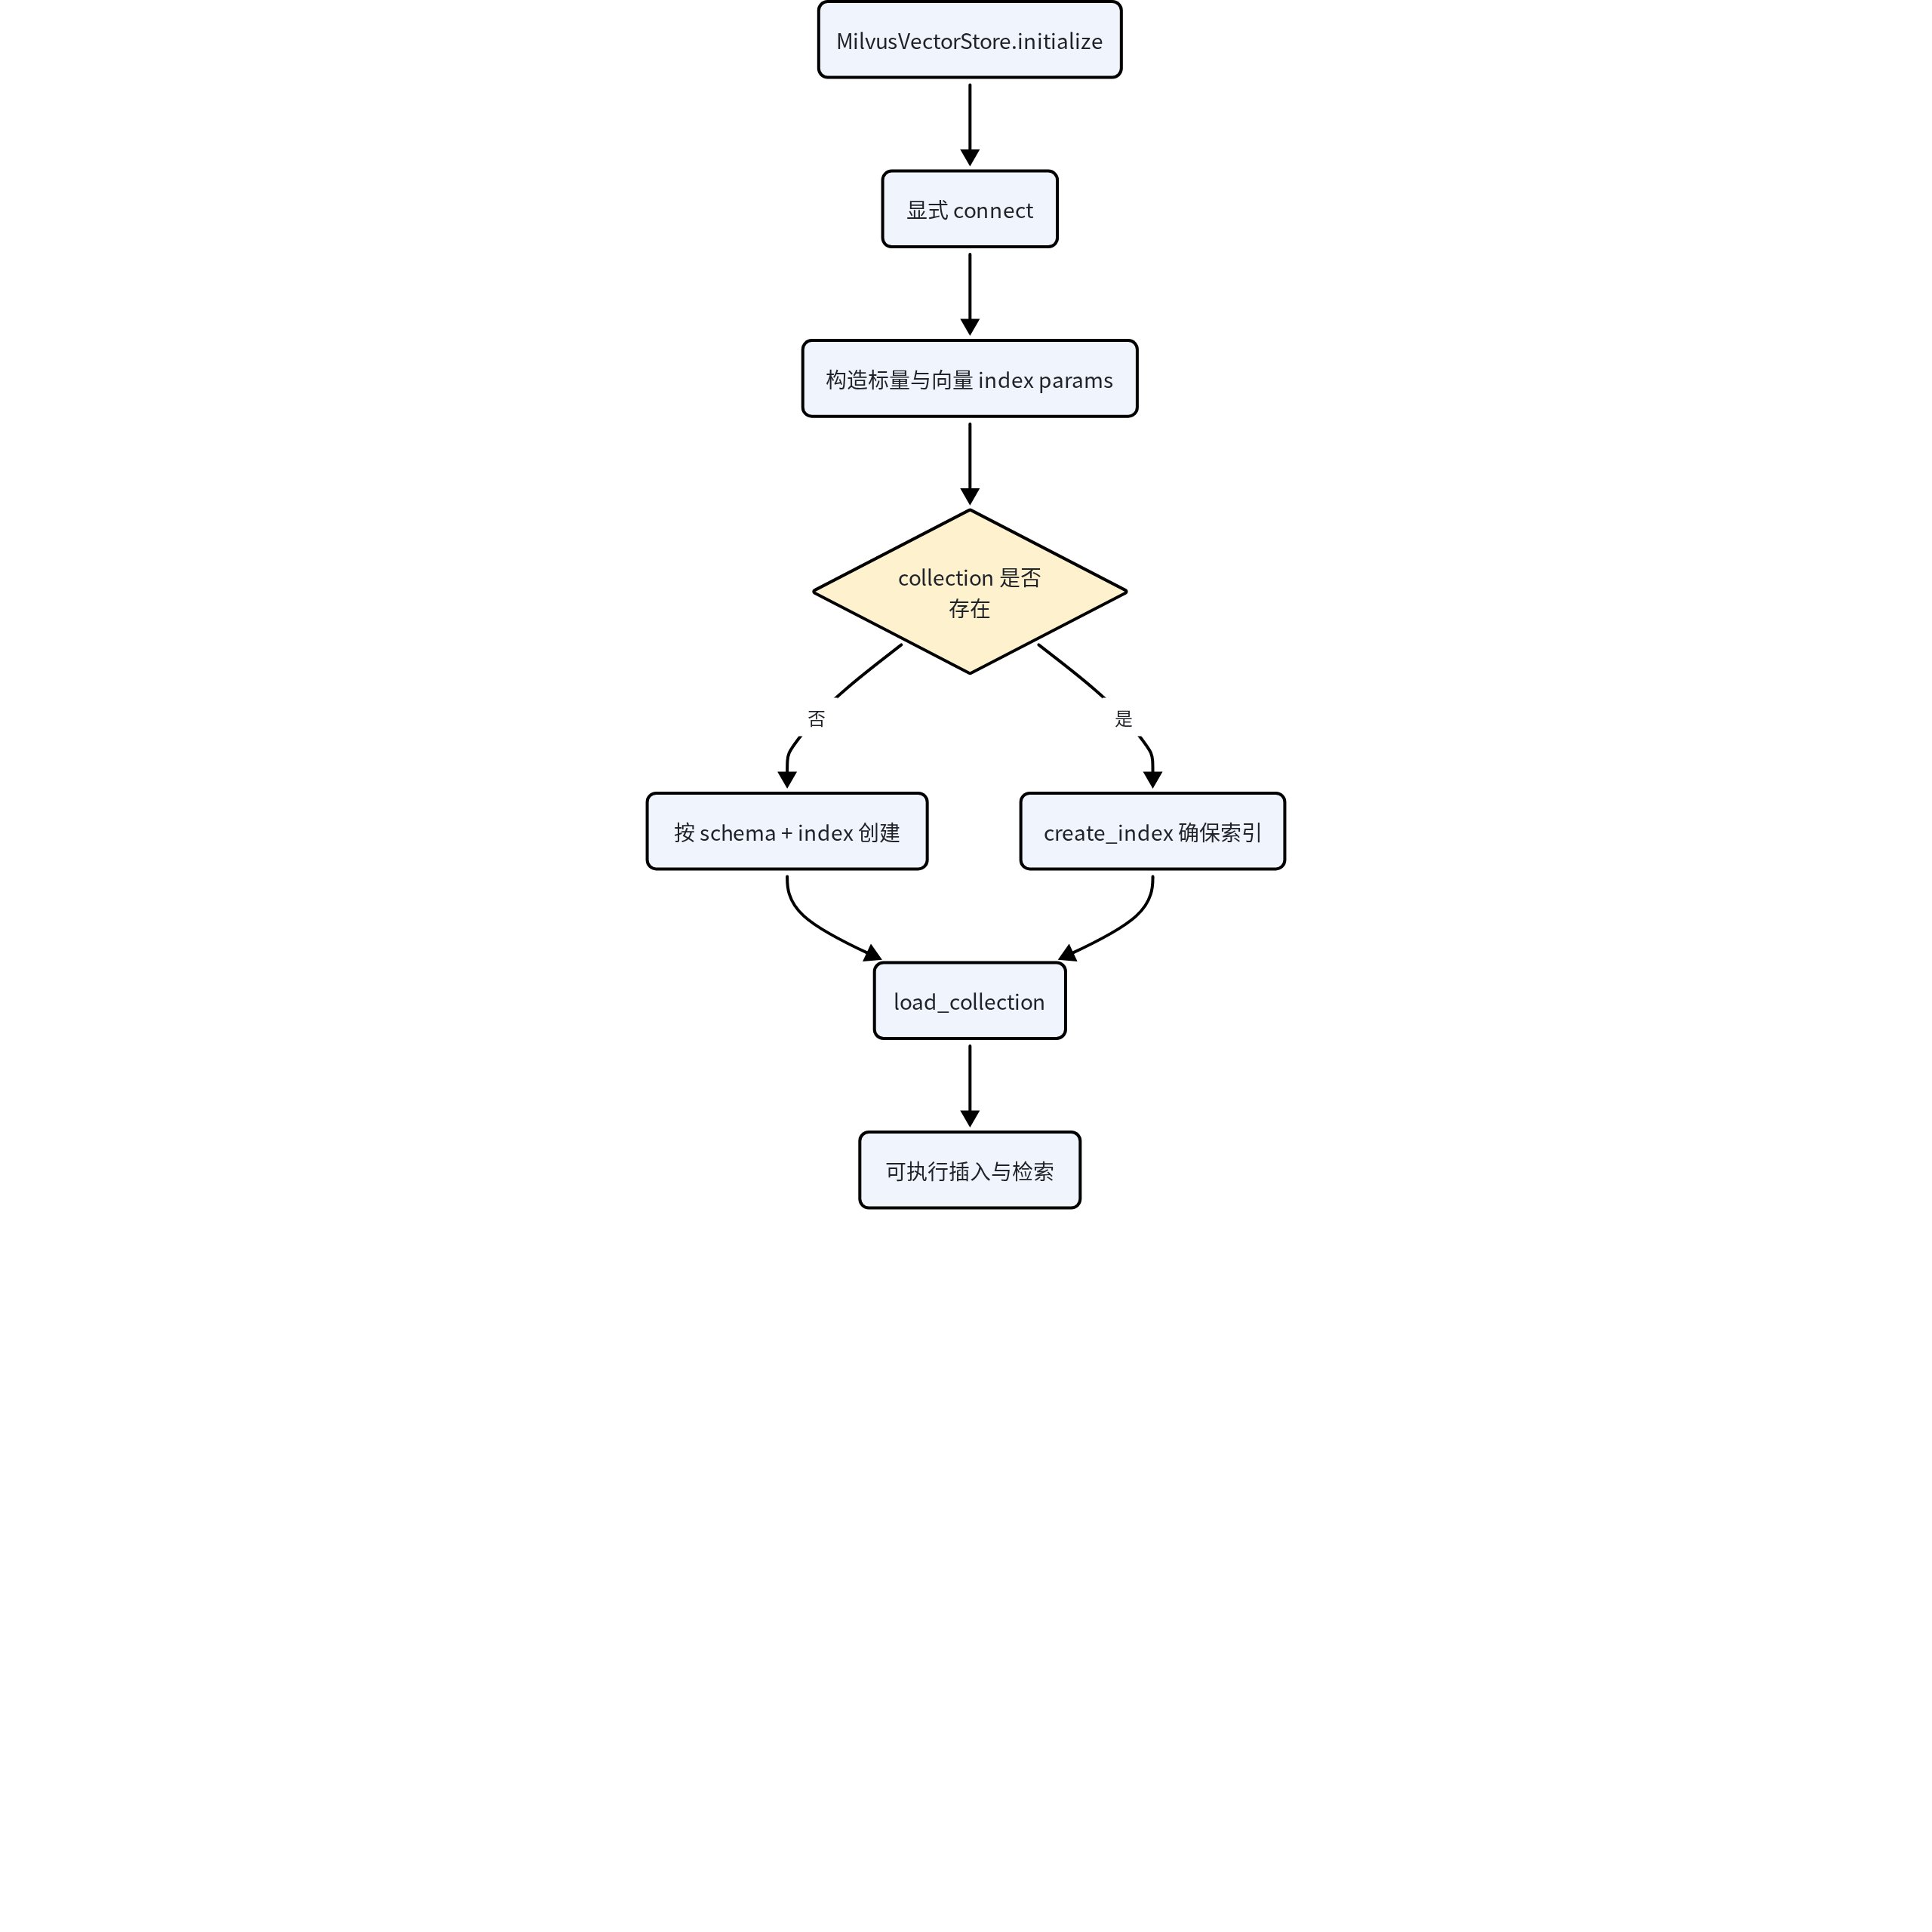
初始化不会从应用代码启动 Milvus 服务,只针对已可达的 Compose 依赖创建或复用 collection。连接、schema 构造、索引或 load 任一步失败都会阻断写入,不能被标记为索引成功。
📷 [图片 token=FYEkb4rKVo32iFxkQ1scZ6C1nqh(未能下载,见飞书原文)]
写入与重建语义
chunk_document_text 支持固定字符、Markdown 标题、段落和兼容旧文档的 word 策略。每个 DocumentChunk 有稳定序号、正文、起止位置和可选 heading path。_vector_chunk_record 用文档 ID 和四位 chunk 序号构造稳定 chunk ID,并在 metadata 加入切分策略、参数、知识类型和完整 owner/tenant 标识。
📷 [图片 token=KqshbvUNQopHK4xG7gVcWRLGn3g(未能下载,见飞书原文)]
MilvusVectorStore._chunk_to_entity 在写入前检查向量长度等于配置维度,再把权限字段既写入顶层标量,也更新到 metadata。重建不是直接追加:服务先初始化,再调用 delete_document_chunks 删除同 tenant、知识库和文档的旧向量,最后插入新批次。若 tenant、知识库或文档 ID 为空,删除方法在连接 Milvus 前抛错,防止退化成大范围清理。
📷 [图片 token=K7ezbZnKIonc7MxheeYcVXNfn8f(未能下载,见飞书原文)]
SQLite 与 Milvus 没有一个跨系统原子事务。当前顺序能保证业务任务记录先存在,并让失败可见、可重试,但如果外部进程在删除旧向量与插入新向量之间终止,向量索引可能暂时为空。durable job、失败状态和手动重建是当前恢复机制;不能声称两库强一致。
📷 [图片 token=P9hAbr6aHoCgtFxRtvocQOMGnyh(未能下载,见飞书原文)]
看什么:在 Milvus 重建之前,服务已得到全部 chunk 和 vectors,并严格检查数量对应。
            # 1. 一条 chunk 必须精确对应一条向量。
            if len(vectors) != len(chunks):
                raise DocumentIndexingError(
                    "Embedding provider returned an unexpected vector count."
                )
            self._vector_store.initialize()
            # 2. 先删除同 tenant、知识库、文档的旧向量。
            self._vector_store.delete_document_chunks(
                tenant_id=owner_user_id,
                knowledge_base_id=document.knowledge_base_id,
                document_id=document.id,
            )
            # 3. 使用 strict zip 防止静默截断。
            self._vector_store.insert_chunks(
                [
                    _vector_chunk_record(
                        document=document,
                        tenant_id=owner_user_id,
                        chunk=chunk,
                        vector=vector,
                    )
                    for chunk, vector in zip(chunks, vectors, strict=True)
                ]
            )
📷 [图片 token=USqSbTz44ogGTvx2swecISFCnFg(未能下载,见飞书原文)]
片段证明重建是文档范围的替换,而非无界追加,并且向量与 chunk 不会静默错位。当前一致性边界仍不是事务:删除成功而插入前崩溃会暂时留下空范围;SQLite 任务失败、durable retry 与确定性 chunk ID 是恢复手段。
📷 [图片 token=PLlTb82OWorz0RxYdBGcrch1nod(未能下载,见飞书原文)]
看什么:下面的时序图区分 SQLite 业务事实与 Milvus 派生索引,重点看非原子窗口。
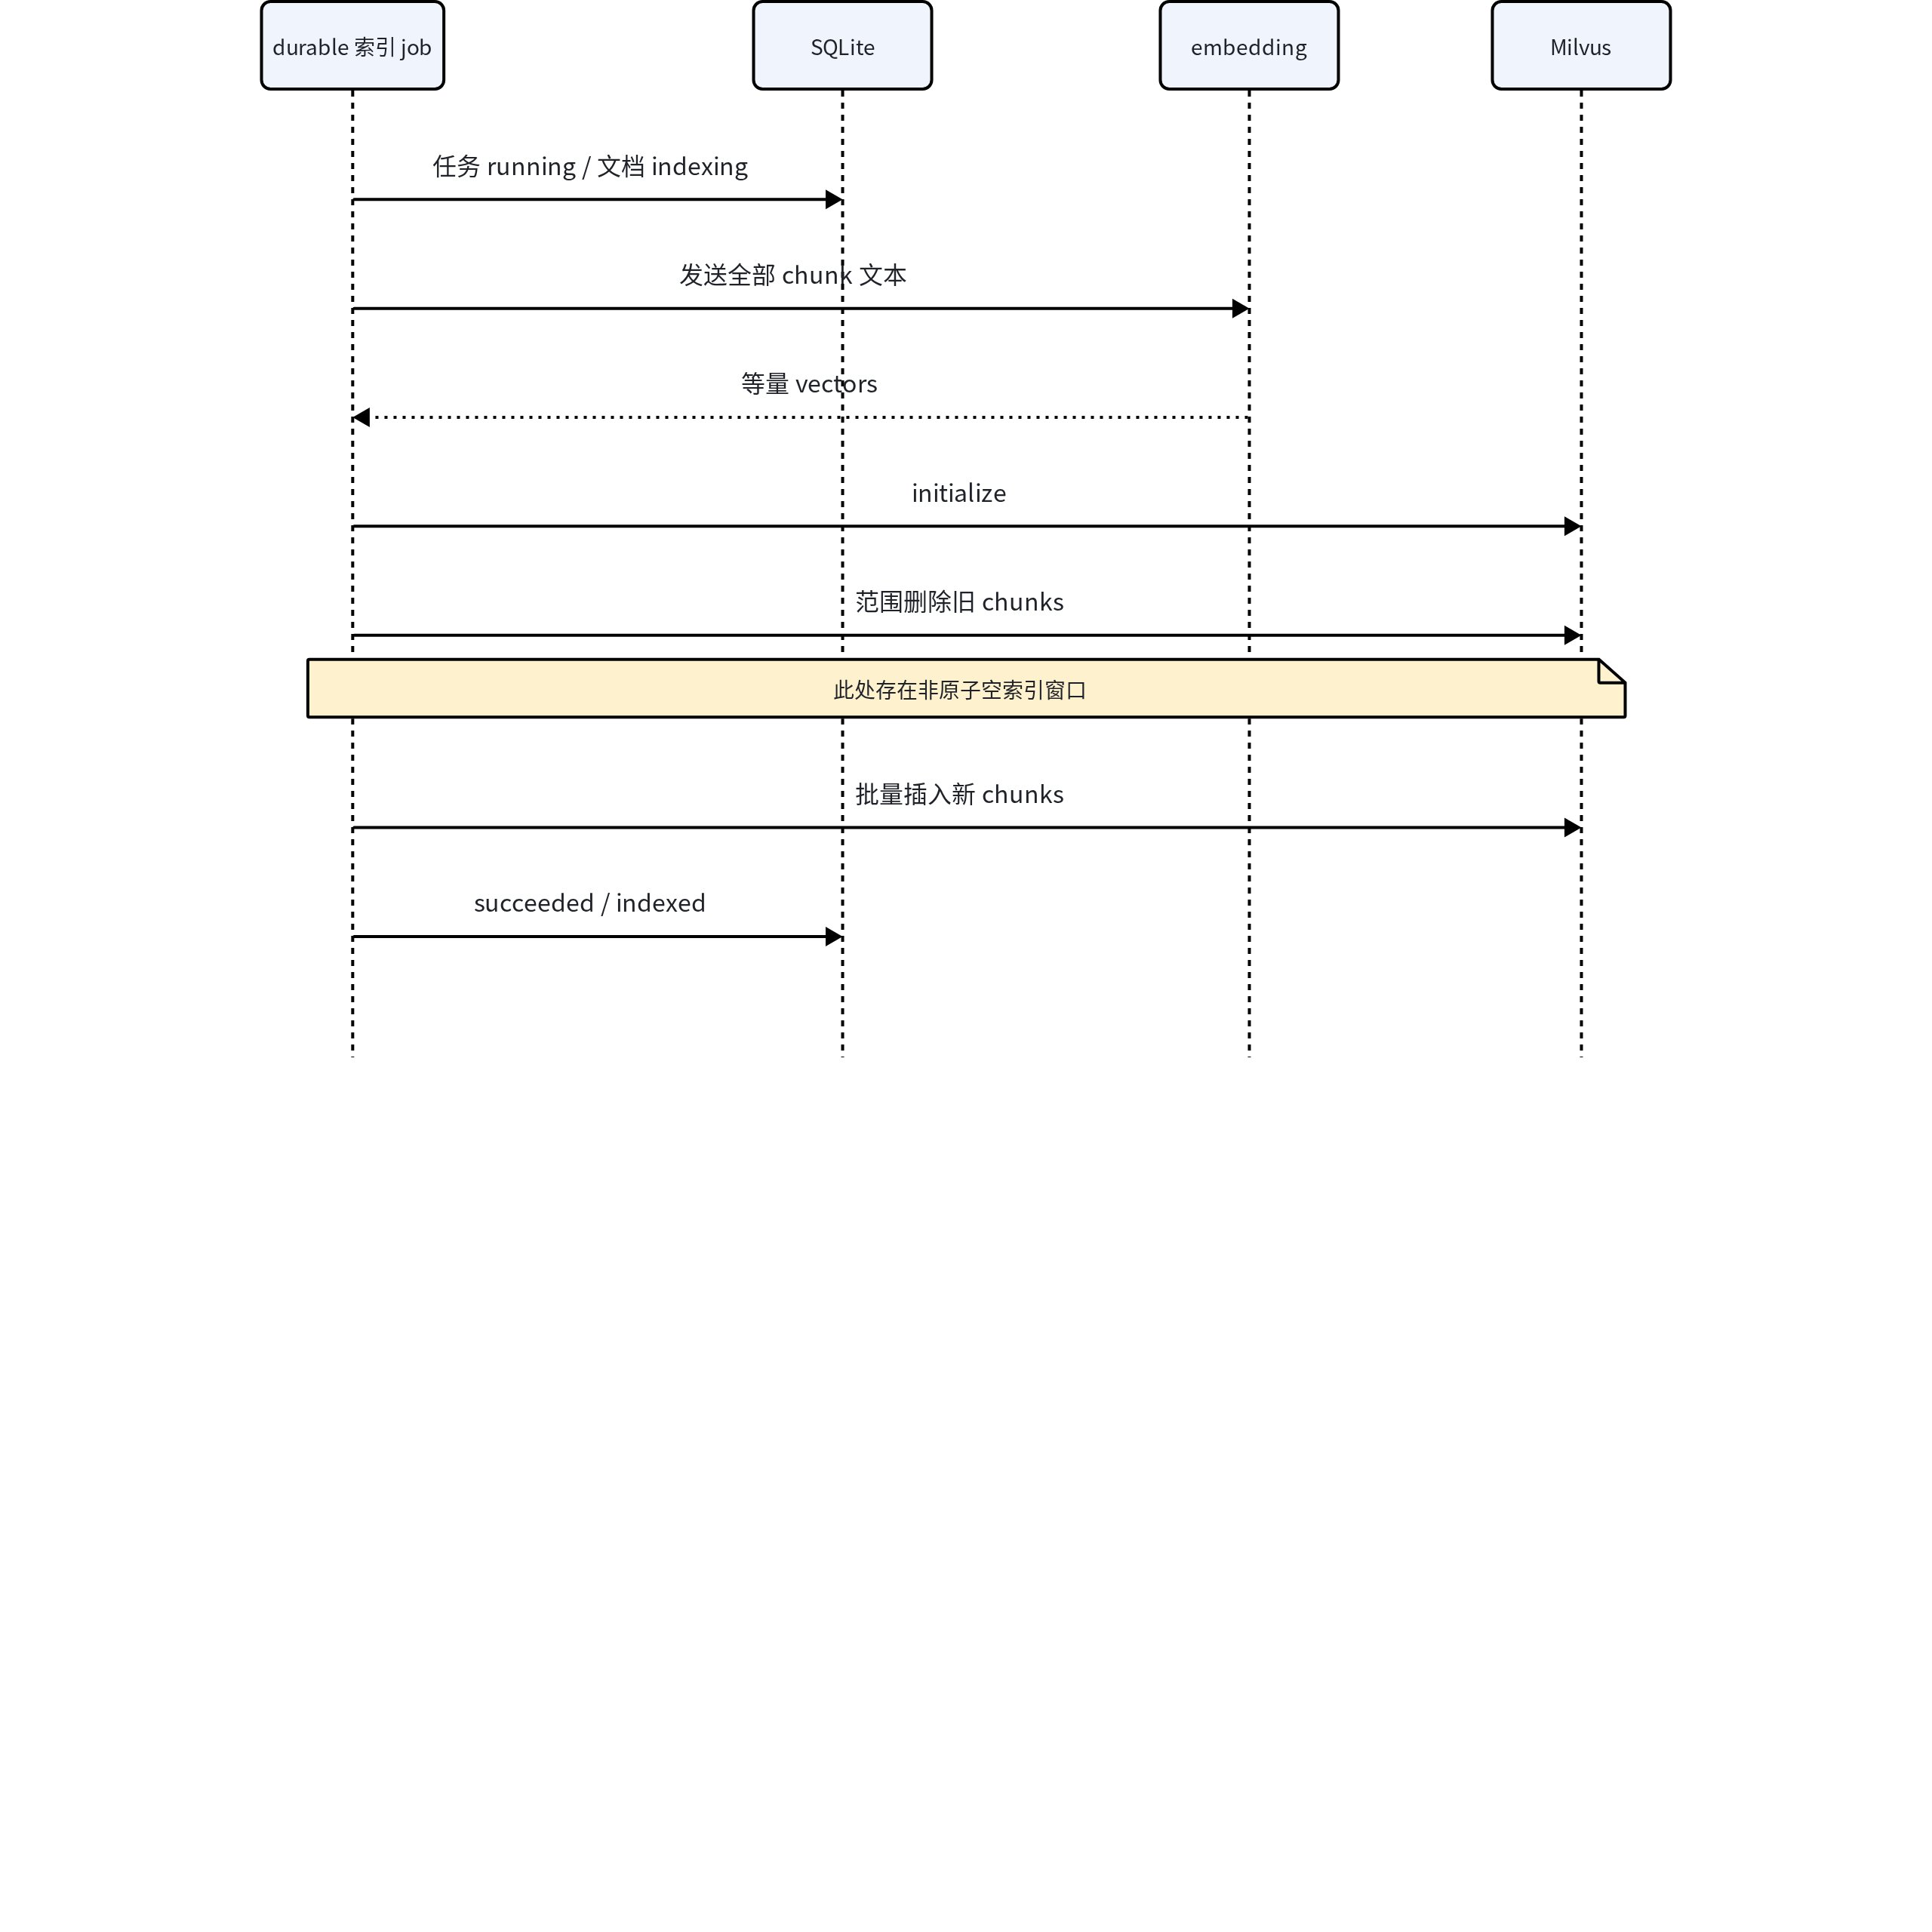
图中只有最后一次 SQLite 更新能证明完整流程结束。embedding 或 Milvus 失败时要保存安全原因;任务再次运行时按同一文档范围重建,而不是把旧失败任务改写成从未失败。
📷 [图片 token=VRH2bo4zDo0mRTxdEJDc2462nYg(未能下载,见飞书原文)]
范围搜索、标量枚举与混合召回
search_chunks 要求 query vector、tenant ID、允许知识库 IDs 和 limit。它把 build_milvus_tenant_filter 生成的表达式交给 Milvus search,指定 COSINE 与搜索参数,并只返回检索所需字段。list_chunks 使用同样 filter,通过每批 1000 的 query iterator 读取标量;输出字段不包含 vector,因为 BM25 只需要正文和标识。iterator 无论成功失败都在 finally 中关闭。
📷 [图片 token=Hc6ebTf6HozpnwxzHULcWOybn3c(未能下载,见飞书原文)]
KnowledgeRetrievalTool 对 Milvus 返回结果再做一层 owner、tenant、知识库、可选文档和 metadata 检查,形成纵深防御。向量候选与 BM25L 候选以 RRF_K = 60 融合,再调用 rerank。无候选时返回空结果,不生成“可能相关”的虚假 chunk;Milvus、embedding 或关键词召回异常转换为 SYSTEM_UNAVAILABLE,rerank 失败也以明确的临时不可用错误结束。
📷 [图片 token=Ncw8bGrwKoqRoyxzPgnc5zV4nuf(未能下载,见飞书原文)]
看什么:向量 search 对空知识库集合先短路,非空时才连接并把 tenant filter 传给 Milvus。
        # 1. 空授权范围不连接、不发起无范围搜索。
        if not knowledge_base_ids:
            return []
        client = self._connection_manager.connect()
        search_result = client.search(
            collection_name=self._settings.collection_name,
            data=[list(query_vector)],
            anns_field=VECTOR_FIELD,
            filter=build_milvus_tenant_filter(
                tenant_id=tenant_id,
                knowledge_base_ids=knowledge_base_ids,
            ),
            limit=limit,
            # 2. metric 与 search params 来自类型化配置。
            search_params={
                "metric_type": self._settings.metric_type,
                "params": dict(self._settings.search_params),
            },
            # 3. 只取检索所需标量,不回读 vector。
            output_fields=list(OUTPUT_FIELDS),
            timeout=self._settings.timeout_seconds,
        )
📷 [图片 token=NfbmbbaJgoXtQUxLEdpc572knsc(未能下载,见飞书原文)]
代码证明向量召回必须有明确 tenant 与允许知识库集合,空集合不是“搜索全部”的别名。返回后检索工具还会校验 owner 和 metadata;任何粗召回分支失败都会成为安全系统错误,不静默使用另一分支补齐。
📷 [图片 token=Tjjibjpp1oYzxYxBp7UcfDt5nyc(未能下载,见飞书原文)]
看什么:混合召回的两个分支共享相同授权范围,但读取的数据和评分方式不同。
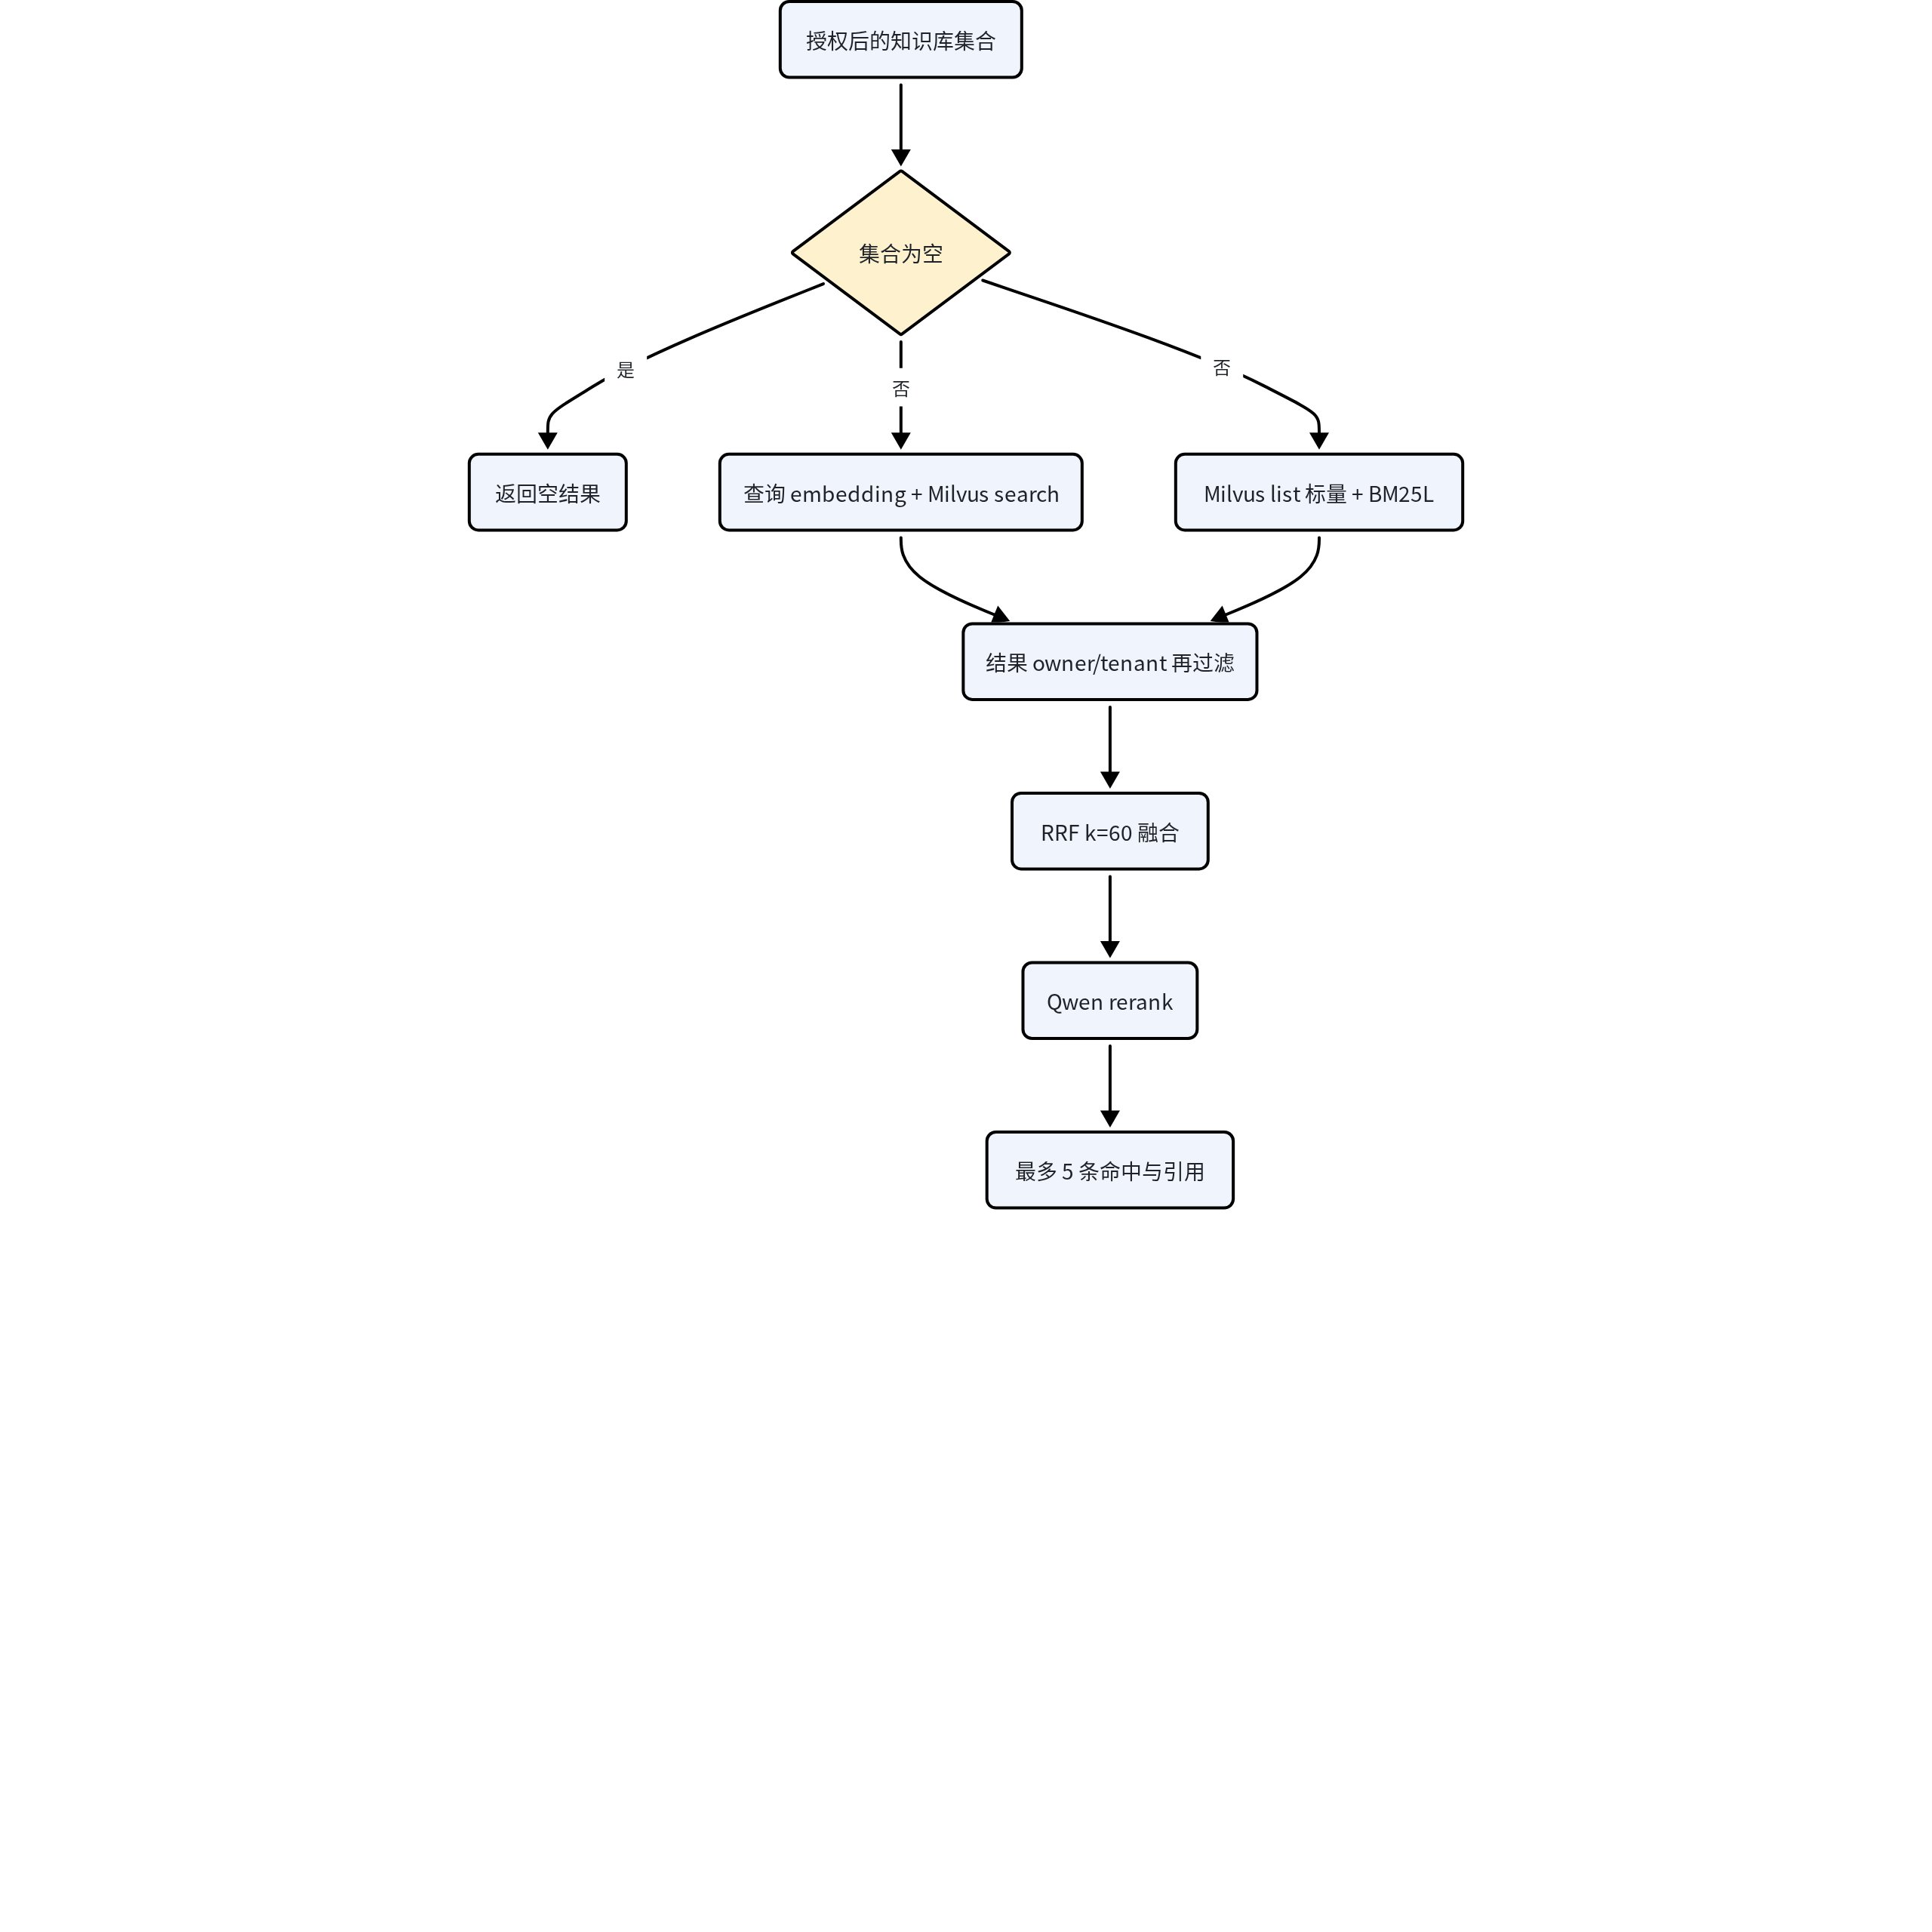
空结果不会生成回退文档内容;向量、枚举、BM25 或 rerank 任一步异常也不会伪造精排分数。BM25 枚举虽然分批读取,仍会收集 tenant 范围语料,性能优化必须保留同一 filter 与空范围短路。
📷 [图片 token=Cn9PbJSwWo2Br0xhY2vc207HnIe(未能下载,见飞书原文)]
显式连接与 readiness
MilvusConnectionManager.connect 在首次调用时才用 settings 创建 MilvusClient,后续复用。build_default_milvus_vector_store 只加载配置并创建边界对象。由此 create_app 可以完成装配而不在启动导入阶段访问网络,单元测试也能注入 fake client。
📷 [图片 token=Rx8OboF9TouJh0xCowwco6m4nCd(未能下载,见飞书原文)]
health_check 通过列出 collections 判断连接并返回 URI、collection、延迟和错误字段。API 层 _milvus_readiness_payload 在线程池运行同步检查;异常或不健康结果对外统一为“Milvus is unavailable”,不把传输内部异常放进 /ready。/health 不探测 Milvus,所以可用于判断后端进程存活;/ready 才代表依赖聚合状态。
📷 [图片 token=No7Hbr4PSofESnxSfOxchHs2nib(未能下载,见飞书原文)]
看什么:连接管理器只有在 connect 被显式调用时才创建客户端,并缓存同一个实例。
    def connect(self) -> MilvusClientProtocol:
        """Create the client on first explicit use and return it."""
        # 1. import 或 store 构造阶段都不会创建客户端。
        if self._client is None:
            self._client = self._client_factory(self._settings)
        return self._client

    # … 省略与本节无关的代码
    def health_check(self) -> MilvusHealthCheckResult:
        """Return a readiness result without leaking transport internals."""
        started_at = monotonic()
        try:
            client = self._connection_manager.connect()
            # 2. readiness 通过真实轻量调用验证连接。
            client.list_collections(timeout=self._settings.timeout_seconds)
        except Exception as exc:
            return MilvusHealthCheckResult(
                ok=False,
                uri=self._settings.uri,
                collection_name=self._settings.collection_name,
                latency_ms=_elapsed_ms(started_at),
                error=_safe_error_message(exc),
            )
📷 [图片 token=XeTmbxDgkocm6Jx65ZfcaSJUnYf(未能下载,见飞书原文)]
片段证明“对象已装配”不等于“Milvus 已连接”,并让导入测试可以断言 pymilvus 尚未加载。health_check 内部保留有界诊断,API 对外再归一化安全消息;/health 不调用它,不能据此宣称向量依赖 ready。
📷 [图片 token=XAG1bbBblo8XWExGPx4cPxFgnnd(未能下载,见飞书原文)]
基础设施生命周期与数据保留
Compose 为 etcd、MinIO、Milvus 和 Alertmanager 声明命名卷,因此普通 down 不等于删除数据;down -v 才会移除卷,是需要谨慎执行的本地重置动作。Milvus 使用 etcd 保存元数据、MinIO 保存对象数据,自身服务健康依赖二者。只看到 19530 端口打开不足以判断完整可用,Compose healthcheck 与后端 /ready 分别从容器和应用视角提供证据。
📷 [图片 token=PCRjb0JkqoQgHbxQPN7cz8nfn0r(未能下载,见飞书原文)]
Attu 依赖 Milvus healthy 后启动,但 Attu 可访问不代表后端配置指向同一 collection,也不代表 embedding 与 rerank 可用。Alertmanager 与 Milvus 同处 Compose 只是本地运维便利,它们没有数据耦合:前者提供告警入口,后者提供知识检索。把五个容器视为一个“全栈应用”会掩盖宿主机前端、后端、MCP 和远端模型仍需单独检查。
📷 [图片 token=R4ODbezcDoAyWjxD0JpcU1gonST(未能下载,见飞书原文)]
看什么:Compose 只定义基础设施依赖,Milvus 等 etcd 和 MinIO healthy 后启动;这里没有 backend 或 frontend 服务。
  milvus:
    image: milvusdb/milvus:v3.0-beta
    command: ["milvus", "run", "standalone"]
    environment:
      ETCD_ENDPOINTS: etcd:2379
      MINIO_ADDRESS: minio:9000
      MINIO_ACCESS_KEY: minioadmin
      MINIO_SECRET_KEY: minioadmin
    ports:
      - "19530:19530"
      - "9091:9091"
    # 1. named volume 让普通 down 不删除 Milvus 数据。
    volumes:
      - milvus-data:/var/lib/milvus
    # 2. 服务启动依赖两个有状态组件的健康检查。
    depends_on:
      etcd:
        condition: service_healthy
      minio:
        condition: service_healthy
📷 [图片 token=IPREbZxonoM0jqxxTGVcFiuxnsf(未能下载,见飞书原文)]
代码证明本地 Compose 拓扑和数据保留边界:普通停止与删除卷不是同一操作,down -v 才是破坏性重置。默认基础设施凭据只适合本地开发;宿主机 FastAPI、Vue 和 CLS MCP 仍需单独启动、配置和检查。
📷 [图片 token=H73xbp48Zot9avxBcQDcia0pnWh(未能下载,见飞书原文)]
看什么:容器健康、应用 readiness 和模型能力是三层证据,不应由 Attu 页面或一个端口互相替代。
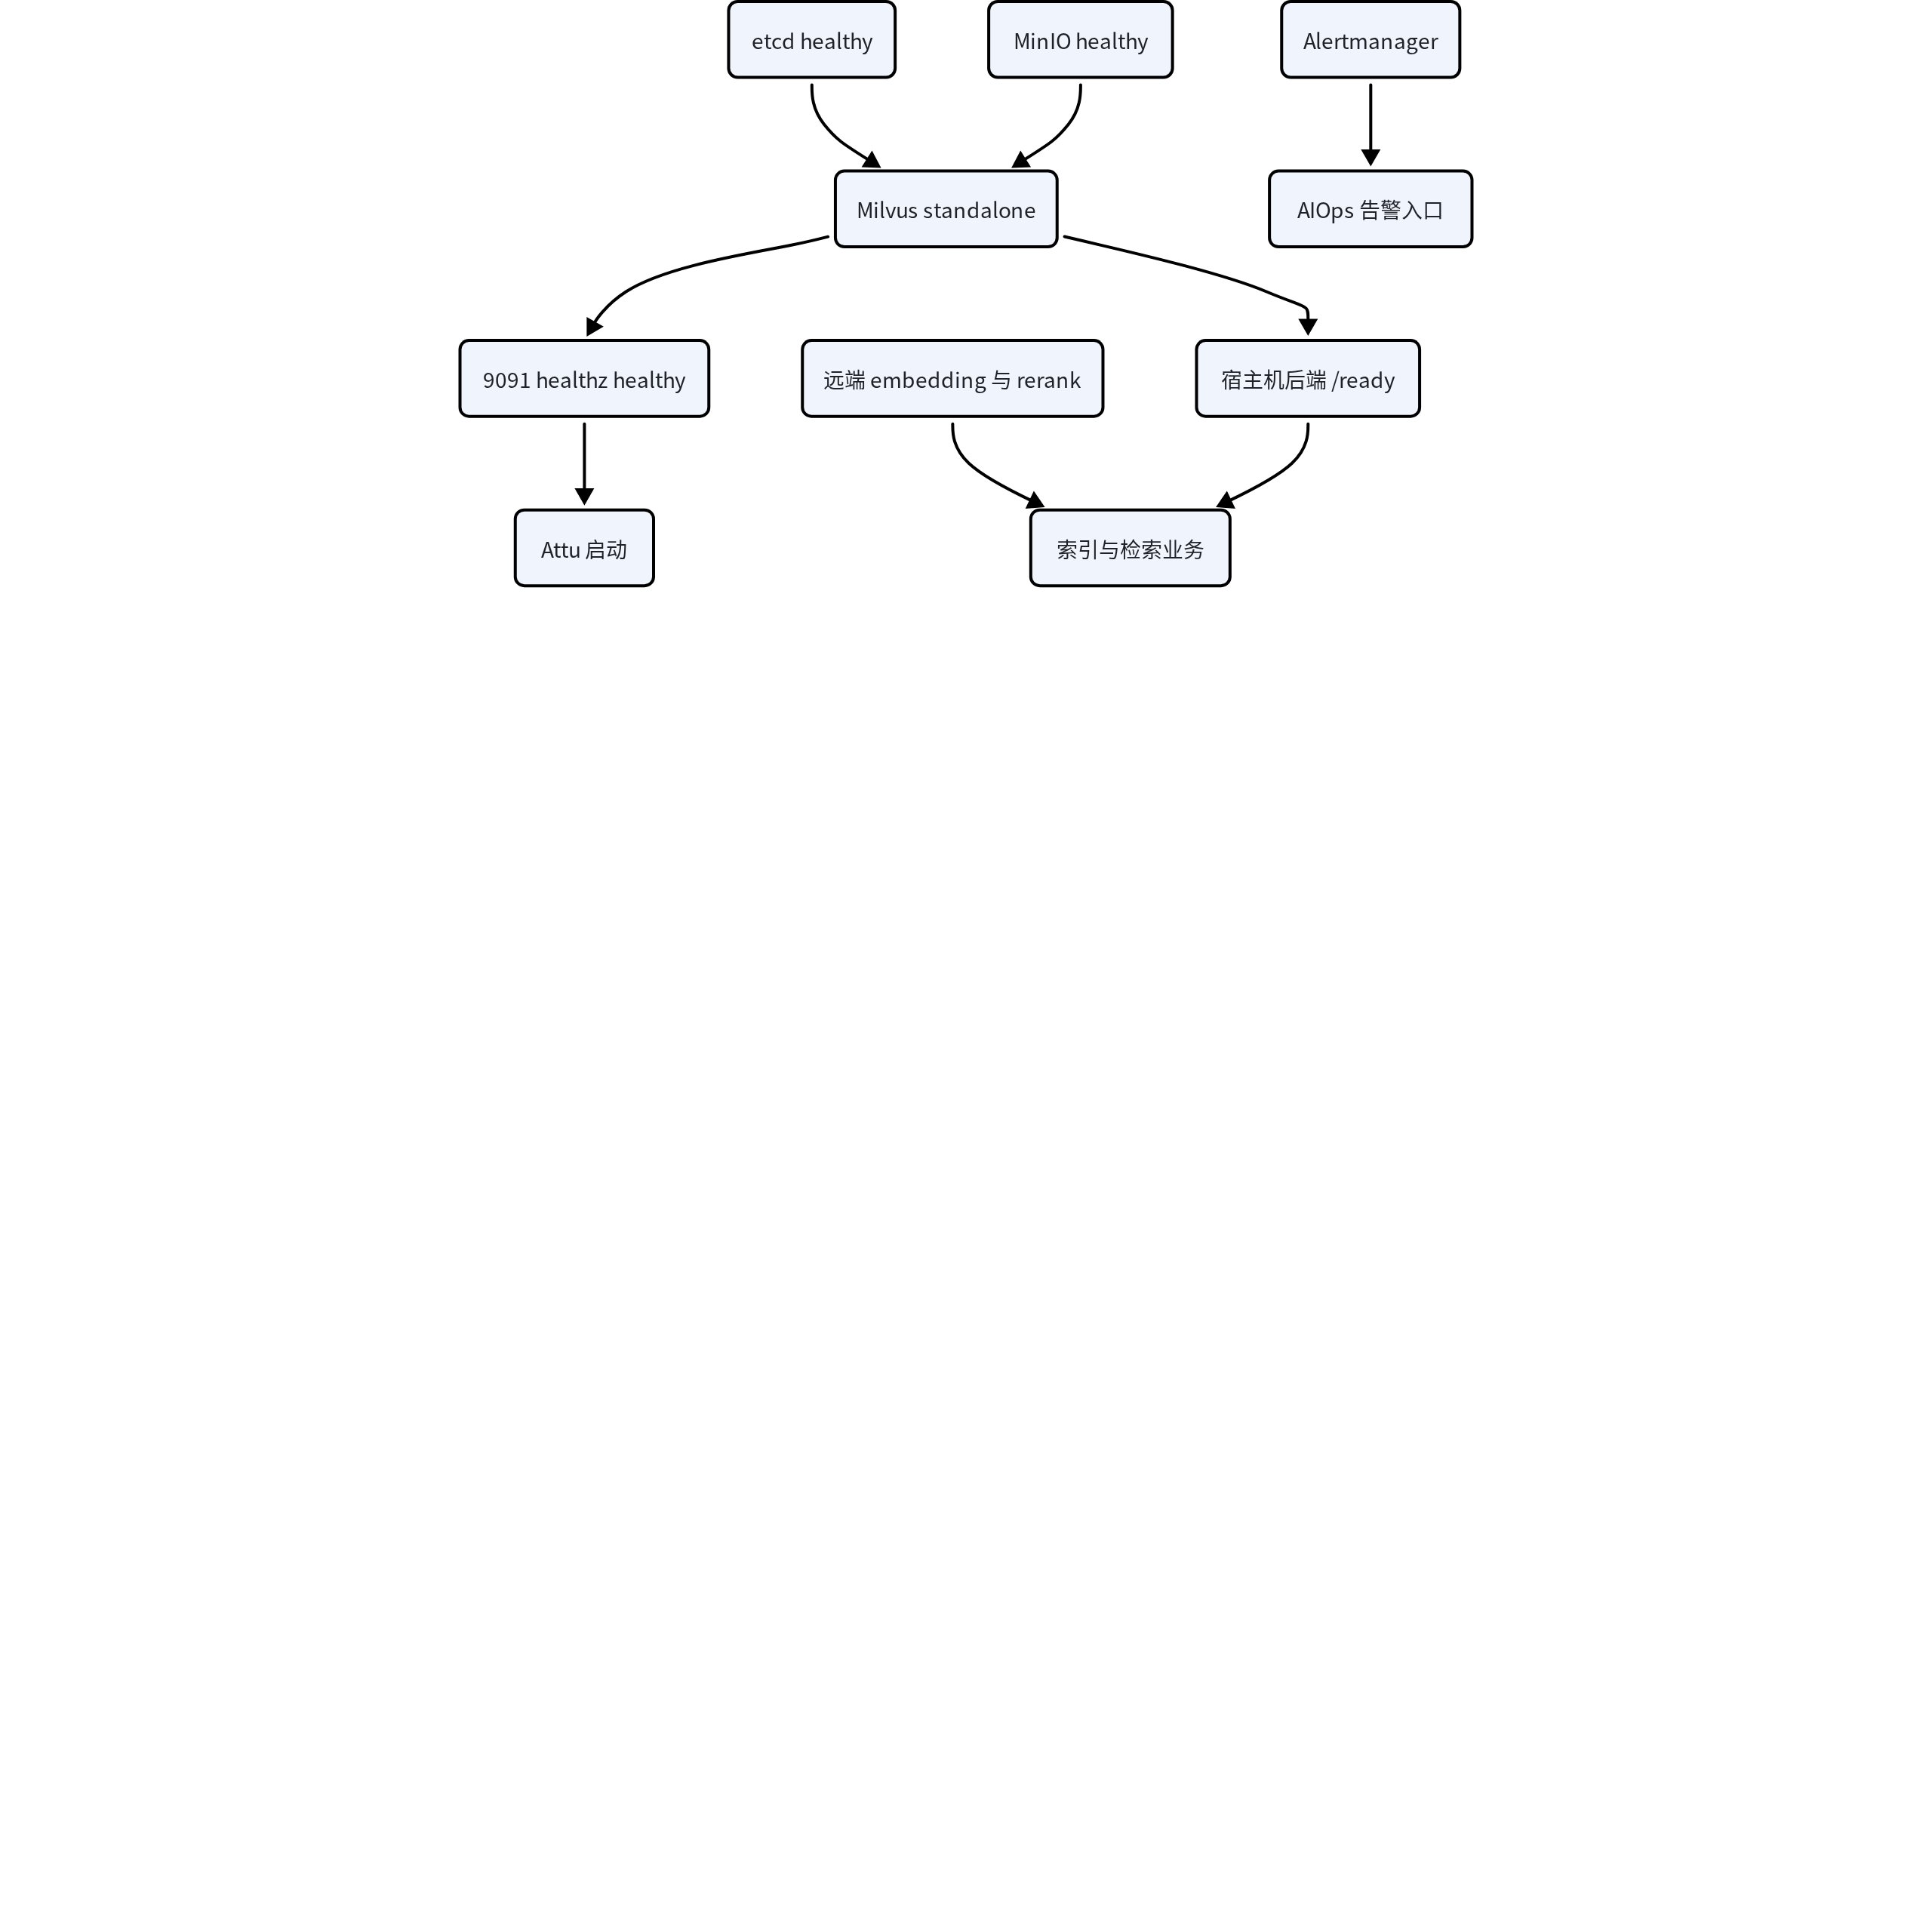
Attu 能打开只证明管理界面与某个 Milvus 可通信,不证明后端 collection 配置、embedding 或 rerank 正常。Alertmanager 与向量库同处 Compose 也不产生数据耦合,排障时应沿实际业务链逐层取证。
📷 [图片 token=Penvbr7LToXGDLxFi28cSkfmnIg(未能下载,见飞书原文)]
索引任务的恢复观察
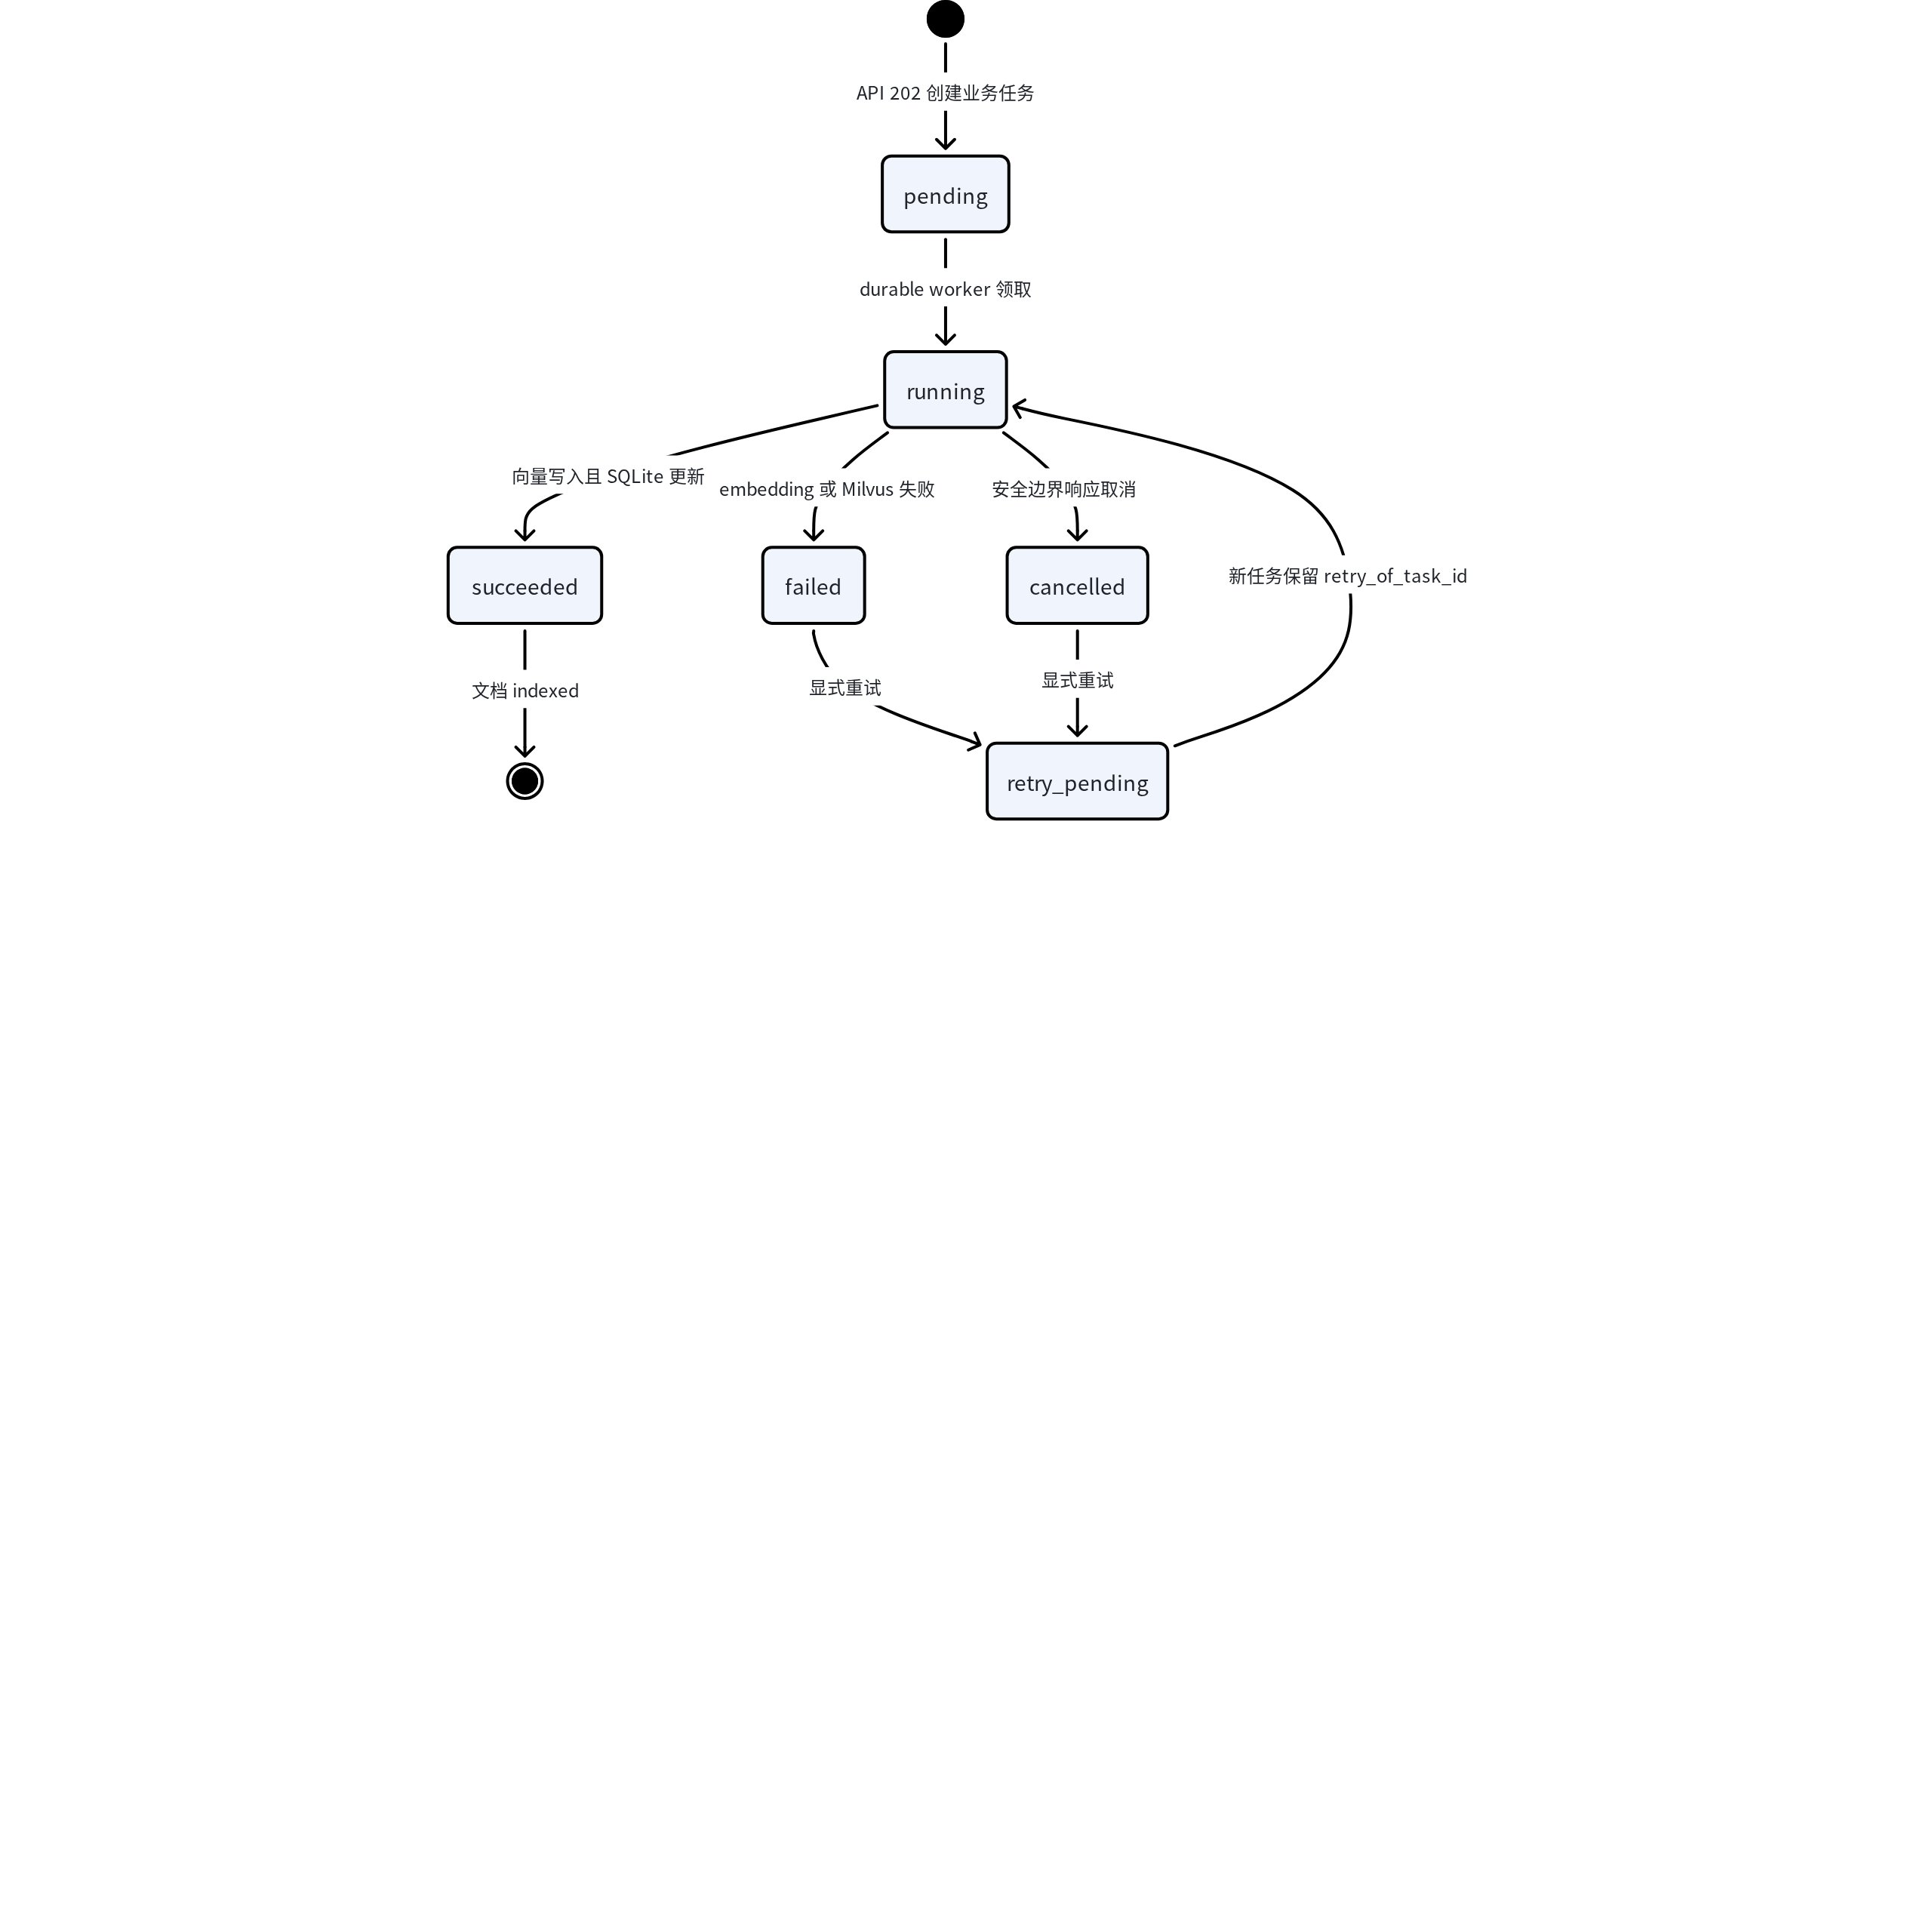
创建文档索引 API 返回 202 时,含义是业务任务与 durable job 已接受,不是向量已经可检索。界面应观察 DocumentIndexTask.status 和文档 indexStatus,只有 succeeded/indexed 才表示完整写入流程结束。pending 或 running 可由 worker 继续处理,failed 保存原因并允许显式 retry,cancelled 表示取消路径。
📷 [图片 token=OkTWbRFbVoJONLxstJtcrpfInEh(未能下载,见飞书原文)]
任务失败后,SQLite 中的上传文档与可索引文本仍存在,所以重试不要求重新上传。重试创建新的索引任务并保留 retry_of_task_id,而不是把旧失败记录改成成功。这个审计链能区分多次尝试。若文档已删除或不属于当前 owner,Repository 拒绝任务,worker 不应从 Milvus 猜测其存在。
📷 [图片 token=SZvrberYqoy0KjxFFOFc5UYgnIC(未能下载,见飞书原文)]
看什么:恢复图同时查看业务索引任务和 durable job,防止只根据一个状态推断另一侧已经完成。
📷 [图片 token=B0pJbZOM2oQtTixlHiUcDpmPn8f(未能下载,见飞书原文)]
图中重试是新记录,不会抹去旧 attempt;服务重启后 queued 或租约过期 job 可再次领取。若最初 Repository 状态更新失败,业务任务可能停在中间态,因此排障要同时检查 background job 的 attempt、租约和安全错误。
📷 [图片 token=GCFDbHtDTolN6ExnON1ckVfCngc(未能下载,见飞书原文)]
检索可解释性来自阶段数据
向量 search 的 score、BM25L 的 score、RRF score 和 rerank relevance 含义不同,不能直接横向比较。KnowledgeRetrievalHit 同时保存 vectorRank、bm25Rank、rerankRank 及各阶段分数;最终兼容字段 score 等于 rerankScore。前端引用视图据此展示候选如何从两路召回进入融合与精排,而不是只给出一个来源不明的“相关度”。
📷 [图片 token=I8qDb7VaYoyidQx5ASycpe6rn6f(未能下载,见飞书原文)]
关键词召回从 Milvus 枚举当前 tenant 的标量 chunk 到内存构建 BM25L,这意味着语料越大,读取成本越需要关注;当前实现通过 iterator 分批读取但仍会收集范围内 chunks。优化时可以改变存储或索引策略,但必须保留 tenant filter、空范围短路和同一引用字段语义。性能优化不能把全 collection 缓存成跨用户共享语料。
📷 [图片 token=WaE0beHzIoVKs1xzZghc3vxrnQb(未能下载,见飞书原文)]
看什么:最终命中把三个阶段的 rank/score 分开保存,并让兼容 score 明确等于 rerank 分数。
def _hit_from_fused_candidate(
    candidate: _FusedCandidate, *, rerank_rank: int, rerank_score: float
) -> KnowledgeRetrievalHit:
    result = candidate.chunk
    return KnowledgeRetrievalHit(
        chunk_id=result.chunk_id,
        document_id=result.document_id,
        knowledge_base_id=result.knowledge_base_id,
        owner_user_id=result.owner_user_id,
        tenant_id=result.tenant_id,
        content=result.content,
        source=result.source,
        metadata=result.metadata,
        # 1. 兼容 score 只表示最终 rerank 分数。
        score=rerank_score,
        vector_rank=candidate.vector_rank,
        bm25_rank=candidate.bm25_rank,
        rerank_rank=rerank_rank,
        vector_score=candidate.vector_score,
        bm25_score=candidate.bm25_score,
        rrf_score=candidate.rrf_score,
        rerank_score=rerank_score,
    )
📷 [图片 token=D4HqbwKWYoXMNgxDzpTc23mPnjf(未能下载,见飞书原文)]
代码证明向量、BM25、RRF 和 rerank 不是一个可混用的分数轴,单路未命中时相应字段允许为空。引用从同一个 hit 派生,保持 chunk 与各阶段排名一致;rerank 失败时不能回填其他分数伪装最终相关度。
📷 [图片 token=RB3tbsFusocUEvxcLpFcsaZynyc(未能下载,见飞书原文)]
看什么:阶段图解释同一 chunk 如何携带可空的粗召回排名,再获得唯一最终排名。
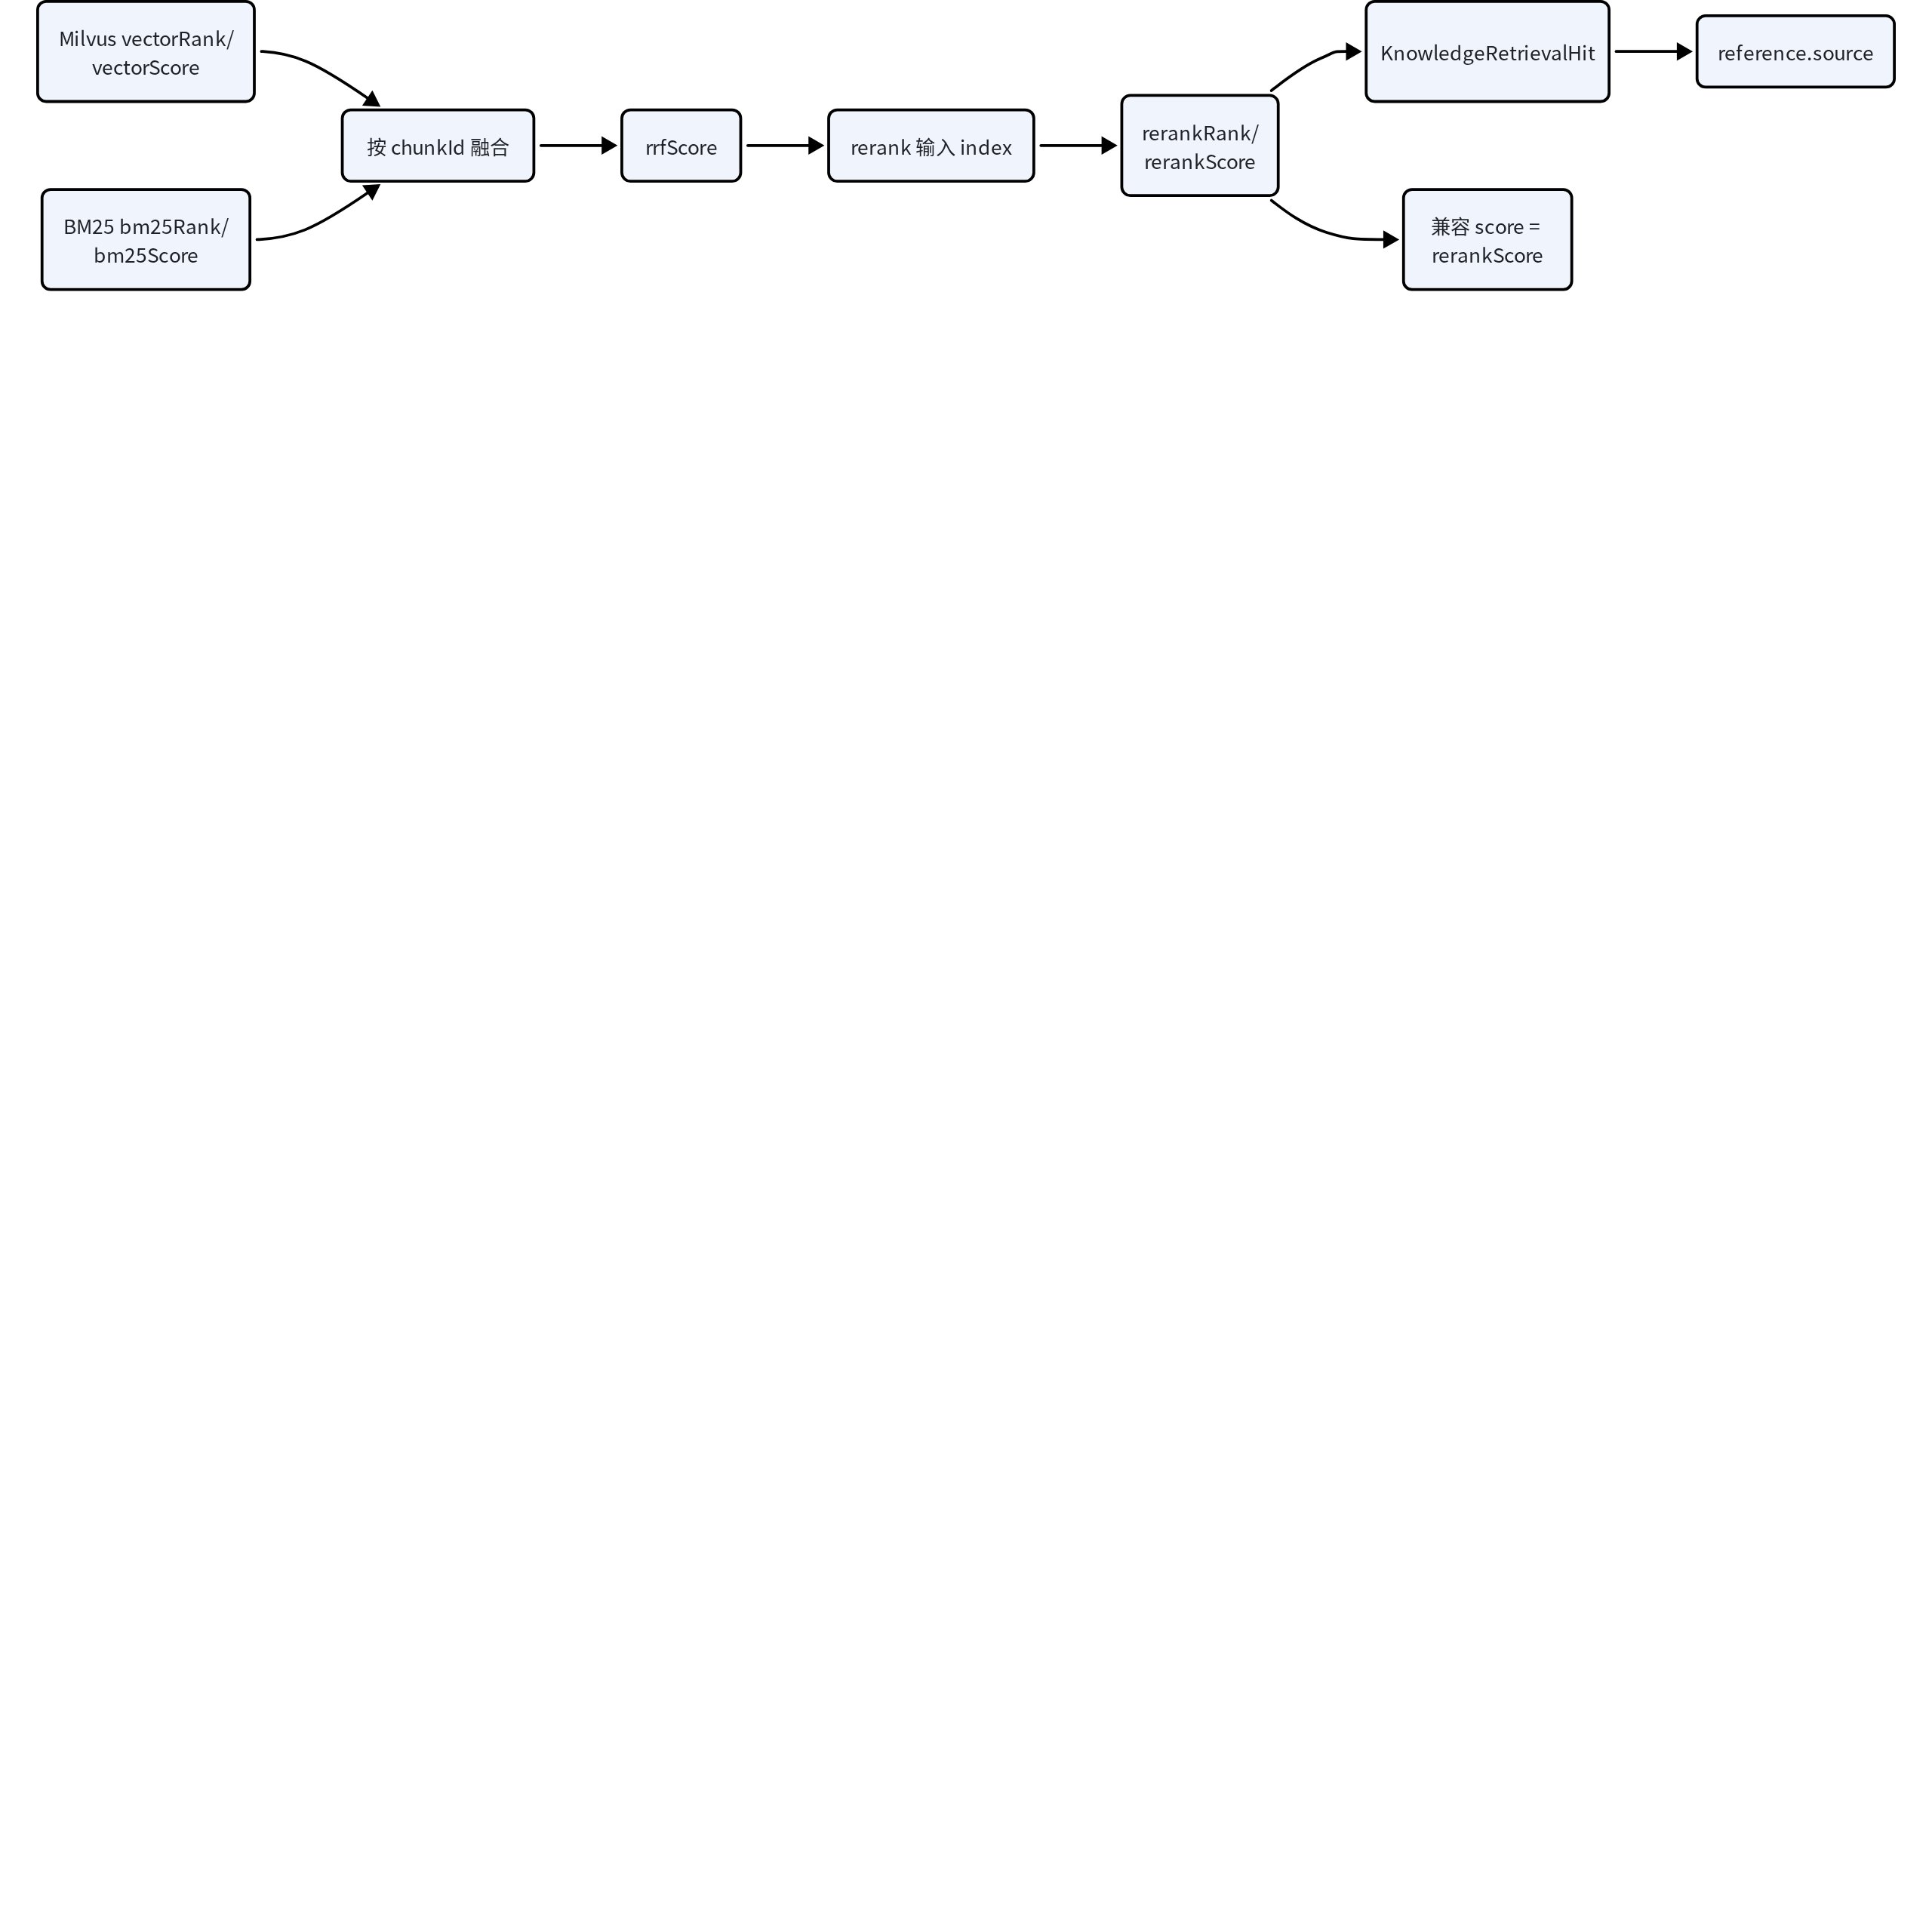
某个 chunk 可只来自一条粗召回分支,所以未命中一侧保留空值而不是零分。前端应展示字段来源,不能把不同算法分数直接比较或合成一个未经声明的“置信度”。
📷 [图片 token=SSvNbNnfpoCE3dxpPavcpRcInWf(未能下载,见飞书原文)]
运维检查的最小顺序
遇到知识检索不可用时,可先检查 Compose 服务状态,再访问后端 /ready 看 Milvus 组件;如果 Milvus ready 而索引失败,再检查 embedding 与具体 document task;若索引成功但检索为空,核对当前用户知识库范围、文档 indexStatus、collection 和查询 filter;若已有候选但最终失败,再检查 rerank。按调用链排查比直接在 Attu 中手工改数据更安全。
📷 [图片 token=RG9CbpYXnoHZ7VxkhCkcqoX8ncf(未能下载,见飞书原文)]
手工操作 collection 可能绕过确定性 chunk ID、权限 metadata 和 SQLite 状态,因此不属于正常文档管理流程。需要重建时应使用受保护的索引任务 API,让服务先做 owner 校验并同步状态。真实文档上传、SOP 索引、日志上传和告警发布也都保持显式动作,启动基础设施本身不会制造演示数据。
📷 [图片 token=HbmDbRCQyoQUDQxDZB9czchInwd(未能下载,见飞书原文)]
看什么:最小排障路径从无侵入的基础设施证据逐层进入业务状态,最后才检查 rerank。
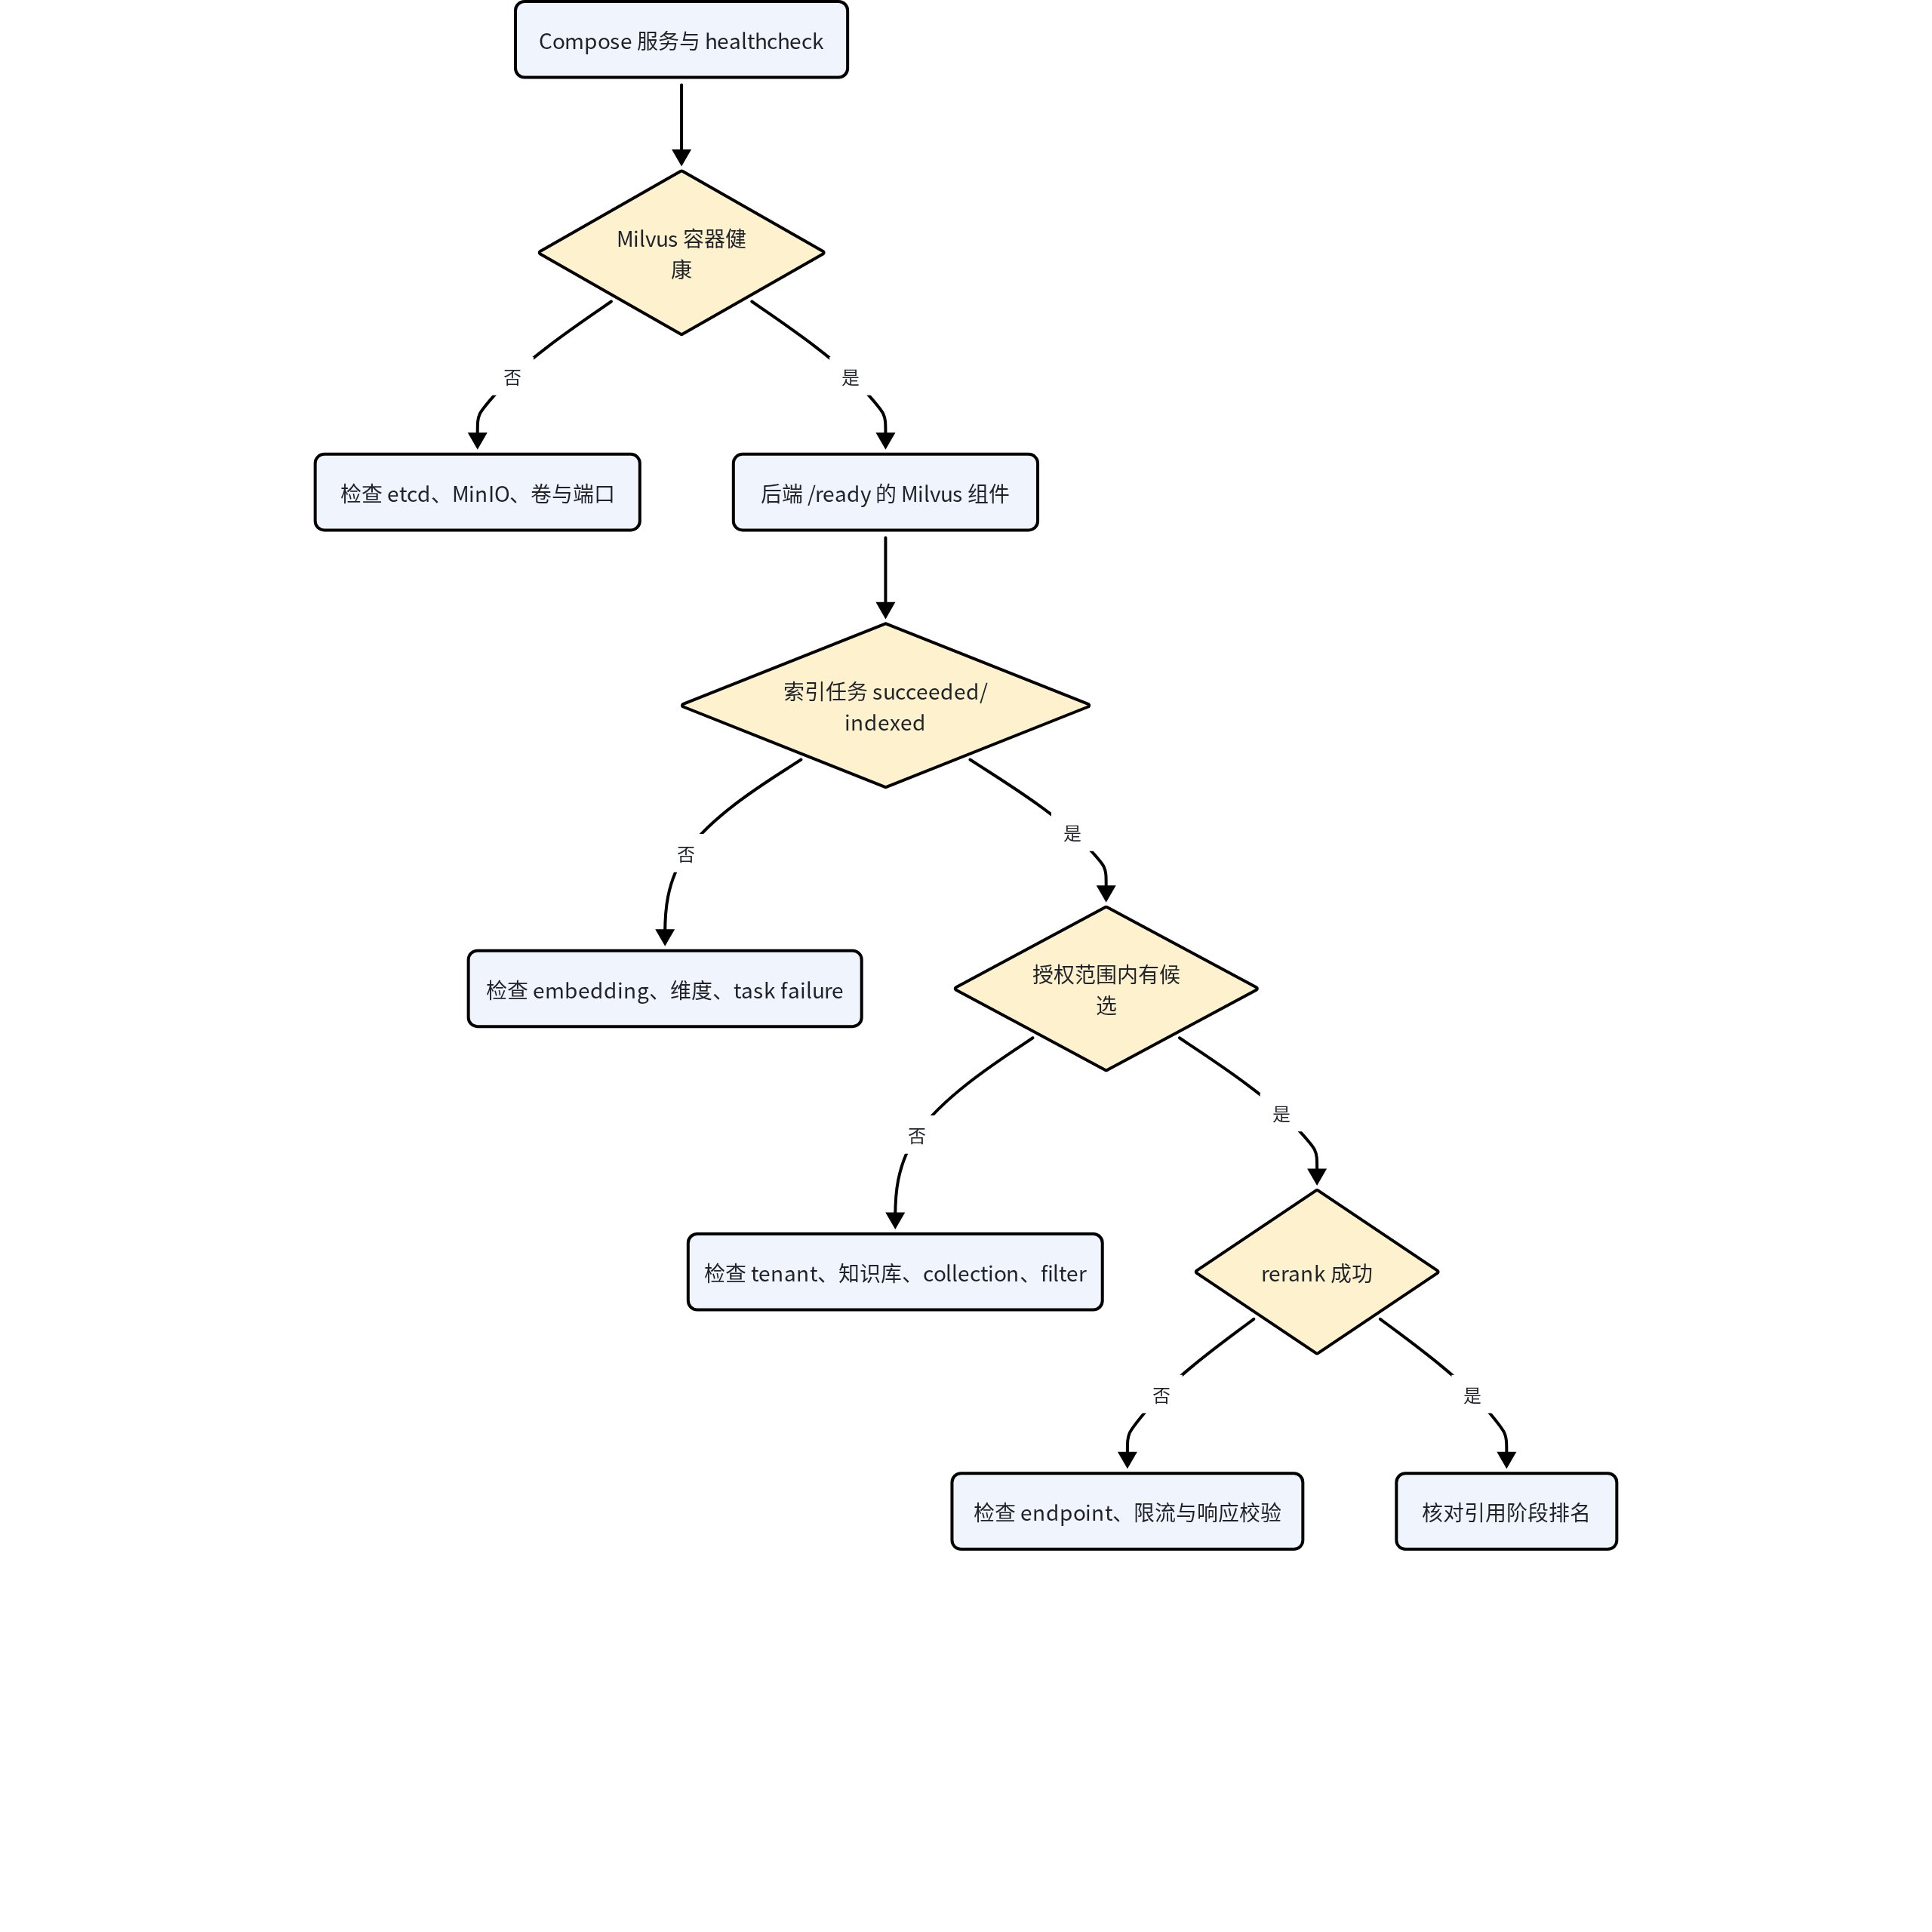
这条顺序避免一开始就在 Attu 中改数据,从而绕过 owner metadata、确定性 chunk ID 和 SQLite 状态。启动基础设施不会自动上传真实文档、SOP、日志或告警;这些仍需授权用户显式操作并留下业务记录。
📷 [图片 token=VFlvbciGDo3ERNxCdnbcyzgfnjg(未能下载,见飞书原文)]
数据、契约与状态
Milvus 顶层标量中的 ownerUserId 和 tenantId 当前通常都等于认证用户 ID,但两者都保留是为了明确所有权与查询范围语义。knowledgeBaseId 和 documentId 进一步收窄检索与删除。JSON metadata 存放 chunk 边界、heading、知识类型和切分参数,同时复制权限标识供下游契约使用。
📷 [图片 token=Hsd5bDaINoa8lyxF8TzcLtBLn0e(未能下载,见飞书原文)]
业务文档与任务状态在 apps/backend/src/super_ai/memory/models.py 中。KnowledgeDocumentModel 保存文件名、大小、MIME、哈希、status、index_status、来源、metadata 和软删除时间;DocumentIndexTaskModel 保存 pending、running、succeeded、failed 或 cancelled、失败原因、重试来源与时间。向量库中没有这些完整状态,因此列表页面和恢复逻辑必须读 SQLite。
📷 [图片 token=NphMb5R4vo7QopxIljqclihdnxe(未能下载,见飞书原文)]
packages/api-contracts/src/vector.ts 在前端共享层也定义 VectorChunkMetadata 与 tenant filter builder,packages/api-contracts/src/documents.ts 和 packages/api-contracts/src/indexing.ts 定义文档与任务 DTO。真正执行 Milvus filter 的是后端 Python;TypeScript helper 用于保持字段语义和测试一致,不能被误解为浏览器侧权限控制。
📷 [图片 token=UsZSbXuSKoE8Aix1QzMcJTuMncd(未能下载,见飞书原文)]
权限、安全与失败边界
没有可访问知识库时,KnowledgeRetrievalTool、search_chunks 与 list_chunks 都有空范围短路。请求指定了不在授权集合中的知识库时,_resolve_knowledge_base_ids 返回 AUTH_FORBIDDEN,不调用 embedding 或 Milvus。删除则必须同时提供三个非空范围字段。任何为了“默认搜索全部”而省略集合的行为都与当前安全边界冲突。
📷 [图片 token=Gbf6bc9fRot0z9xiLHYclkHhnPf(未能下载,见飞书原文)]
Milvus 只保存知识 chunk 向量,不用于存储用户、聊天、诊断证据、工具审计或 MCP 配置。Attu 是本地管理界面,不是最终用户权限层;能访问本机 Attu 的开发者可能直接查看 collection,因此其端口与主机访问也属于开发环境安全范围。Compose 中的本地默认基础设施凭据不应被当作生产安全方案。
📷 [图片 token=R1opbtlU5oQMfXxWzDpcc9k4nY0(未能下载,见飞书原文)]
外部依赖失败必须留下真实状态。Milvus 不可用时 readiness 降级,索引任务失败且可重试,检索返回结构化不可用错误;embedding 不可用时不应写入空向量;rerank 不可用时不应伪造最终分数。启动流程不会自动上传真实 CLS 日志、发布告警或索引文档,这些只能由开发者显式执行。
📷 [图片 token=SeKsbHWJtoQur1xV0o3ccYUrnAe(未能下载,见飞书原文)]
阅读顺序与小结
先读
infra/compose.yaml和infra/README.md,画出容器与宿主机边界。阅读
apps/backend/src/super_ai/vector_store/config.py与apps/backend/src/super_ai/vector_store/schema.py,掌握静态设置和 collection 结构。逐方法阅读
MilvusVectorStore,重点看 connect、空范围、filter、output fields 和删除。沿
DocumentIndexingService追踪写入,沿KnowledgeRetrievalTool追踪读取。最后沿 Compose、Milvus、索引与 tenant filter 串起完整路径,核对失败和越权边界。
本地基础设施的设计重点是边界清楚:Compose 管有状态基础设施,宿主机运行应用;SQLite 保存业务事实,Milvus 保存可重建的知识 chunk 向量;模型和向量服务都按需连接且允许失败;每一次向量操作都携带 tenant 与知识范围。掌握这些边界后,才能安全地优化 chunk、索引或召回,而不会用性能改动破坏数据隔离与可恢复性。
📷 [图片 token=MdY0b4QcVo5yHTxwhSTcaGkungh(未能下载,见飞书原文)]