OncallAgent 通过 OpenAI-compatible 协议接入 Qwen,而不是让业务代码直接依赖厂商私有 SDK。聊天模型与 embedding 使用 langchain-openai 的 ChatOpenAI 和 OpenAIEmbeddings,rerank 则被封装为独立的异步协议和 HTTP 客户端。这样做的重点不是隐藏模型名称,而是让聊天、索引、检索和 readiness 依赖稳定的 provider 抽象。
📷 [图片 token=KgZGbxgcZo0YYTxVicxcVgf6ngh(未能下载,见飞书原文)]
模型配置来自仓库根目录的两个本地 JSON:config/project.json 提供基础设置,config/user.project.json 只覆盖个人字段。两者均被 .gitignore 忽略,运行时递归合并对象;数组、字符串、数字和布尔值整体替换。应用不会从 .env 或本机环境变量补齐项目配置,这使实际生效值可以从一条确定的 JSON 合并链解释。
📷 [图片 token=Q5ZIbfCLbo8yKFxyRyucV7dlnof(未能下载,见飞书原文)]
“本地安全配置”不等于把密钥写进源码。模型 API key、CLS 凭据和真实资源 ID 只能留在被忽略的本地文件中,并且不能出现在日志、readiness、配置检查或异常正文中。本篇只讨论字段与调用关系,不展示任何本机真实凭据。
📷 [图片 token=YiR4bs7QFooMQjxCxljcxiQknJS(未能下载,见飞书原文)]
学习目标
理解基础 JSON 与用户 JSON 的递归合并规则及默认路径。
追踪配置如何变成
LlmProviderConfig,再创建聊天、embedding 与 rerank 能力。理解 provider protocol 如何让业务服务和测试脱离真实网络。
掌握 embedding 每批十条、显式维度、rerank 校验与有限重试的实现边界。
区分 liveness、模型 readiness、配置有效性和真实业务调用成功。
📷 [图片 token=JwtIbNZZbozroPxoPPGcMSVCnTc(未能下载,见飞书原文)]
功能入口与完整调用链
配置入口是 apps/backend/src/super_ai/project_config.py 的 load_project_config。默认基础路径由 DEFAULT_PROJECT_CONFIG_PATH 指向根目录 config/project.json,默认用户路径指向 config/user.project.json。_read_json_object 要求文件可读且顶层为 JSON object;用户文件存在时,_deep_merge 对两边都是 object 的字段递归处理,否则以用户值整体替换基础值。
📷 [图片 token=GzVabIHGfoMnhQxEoxscTSbKnXb(未能下载,见飞书原文)]
apps/backend/src/super_ai/llm/config.py 的 load_llm_provider_config 读取 llm section,要求 provider、apiKey、baseUrl、chatModel、embeddingModel、embeddingDimensions、rerankModel、rerankUrl、temperature、timeoutSeconds 和 maxRetries。它还以当前 chatModel 为键读取 modelCapabilities,取得 contextWindowTokens;没有匹配 profile 会安全失败。api key 字段在 dataclass 中标记 repr=False,减少对象调试输出意外带出密钥的风险。
📷 [图片 token=Mqpubxss1oGe0axCjKnco7AtnDg(未能下载,见飞书原文)]
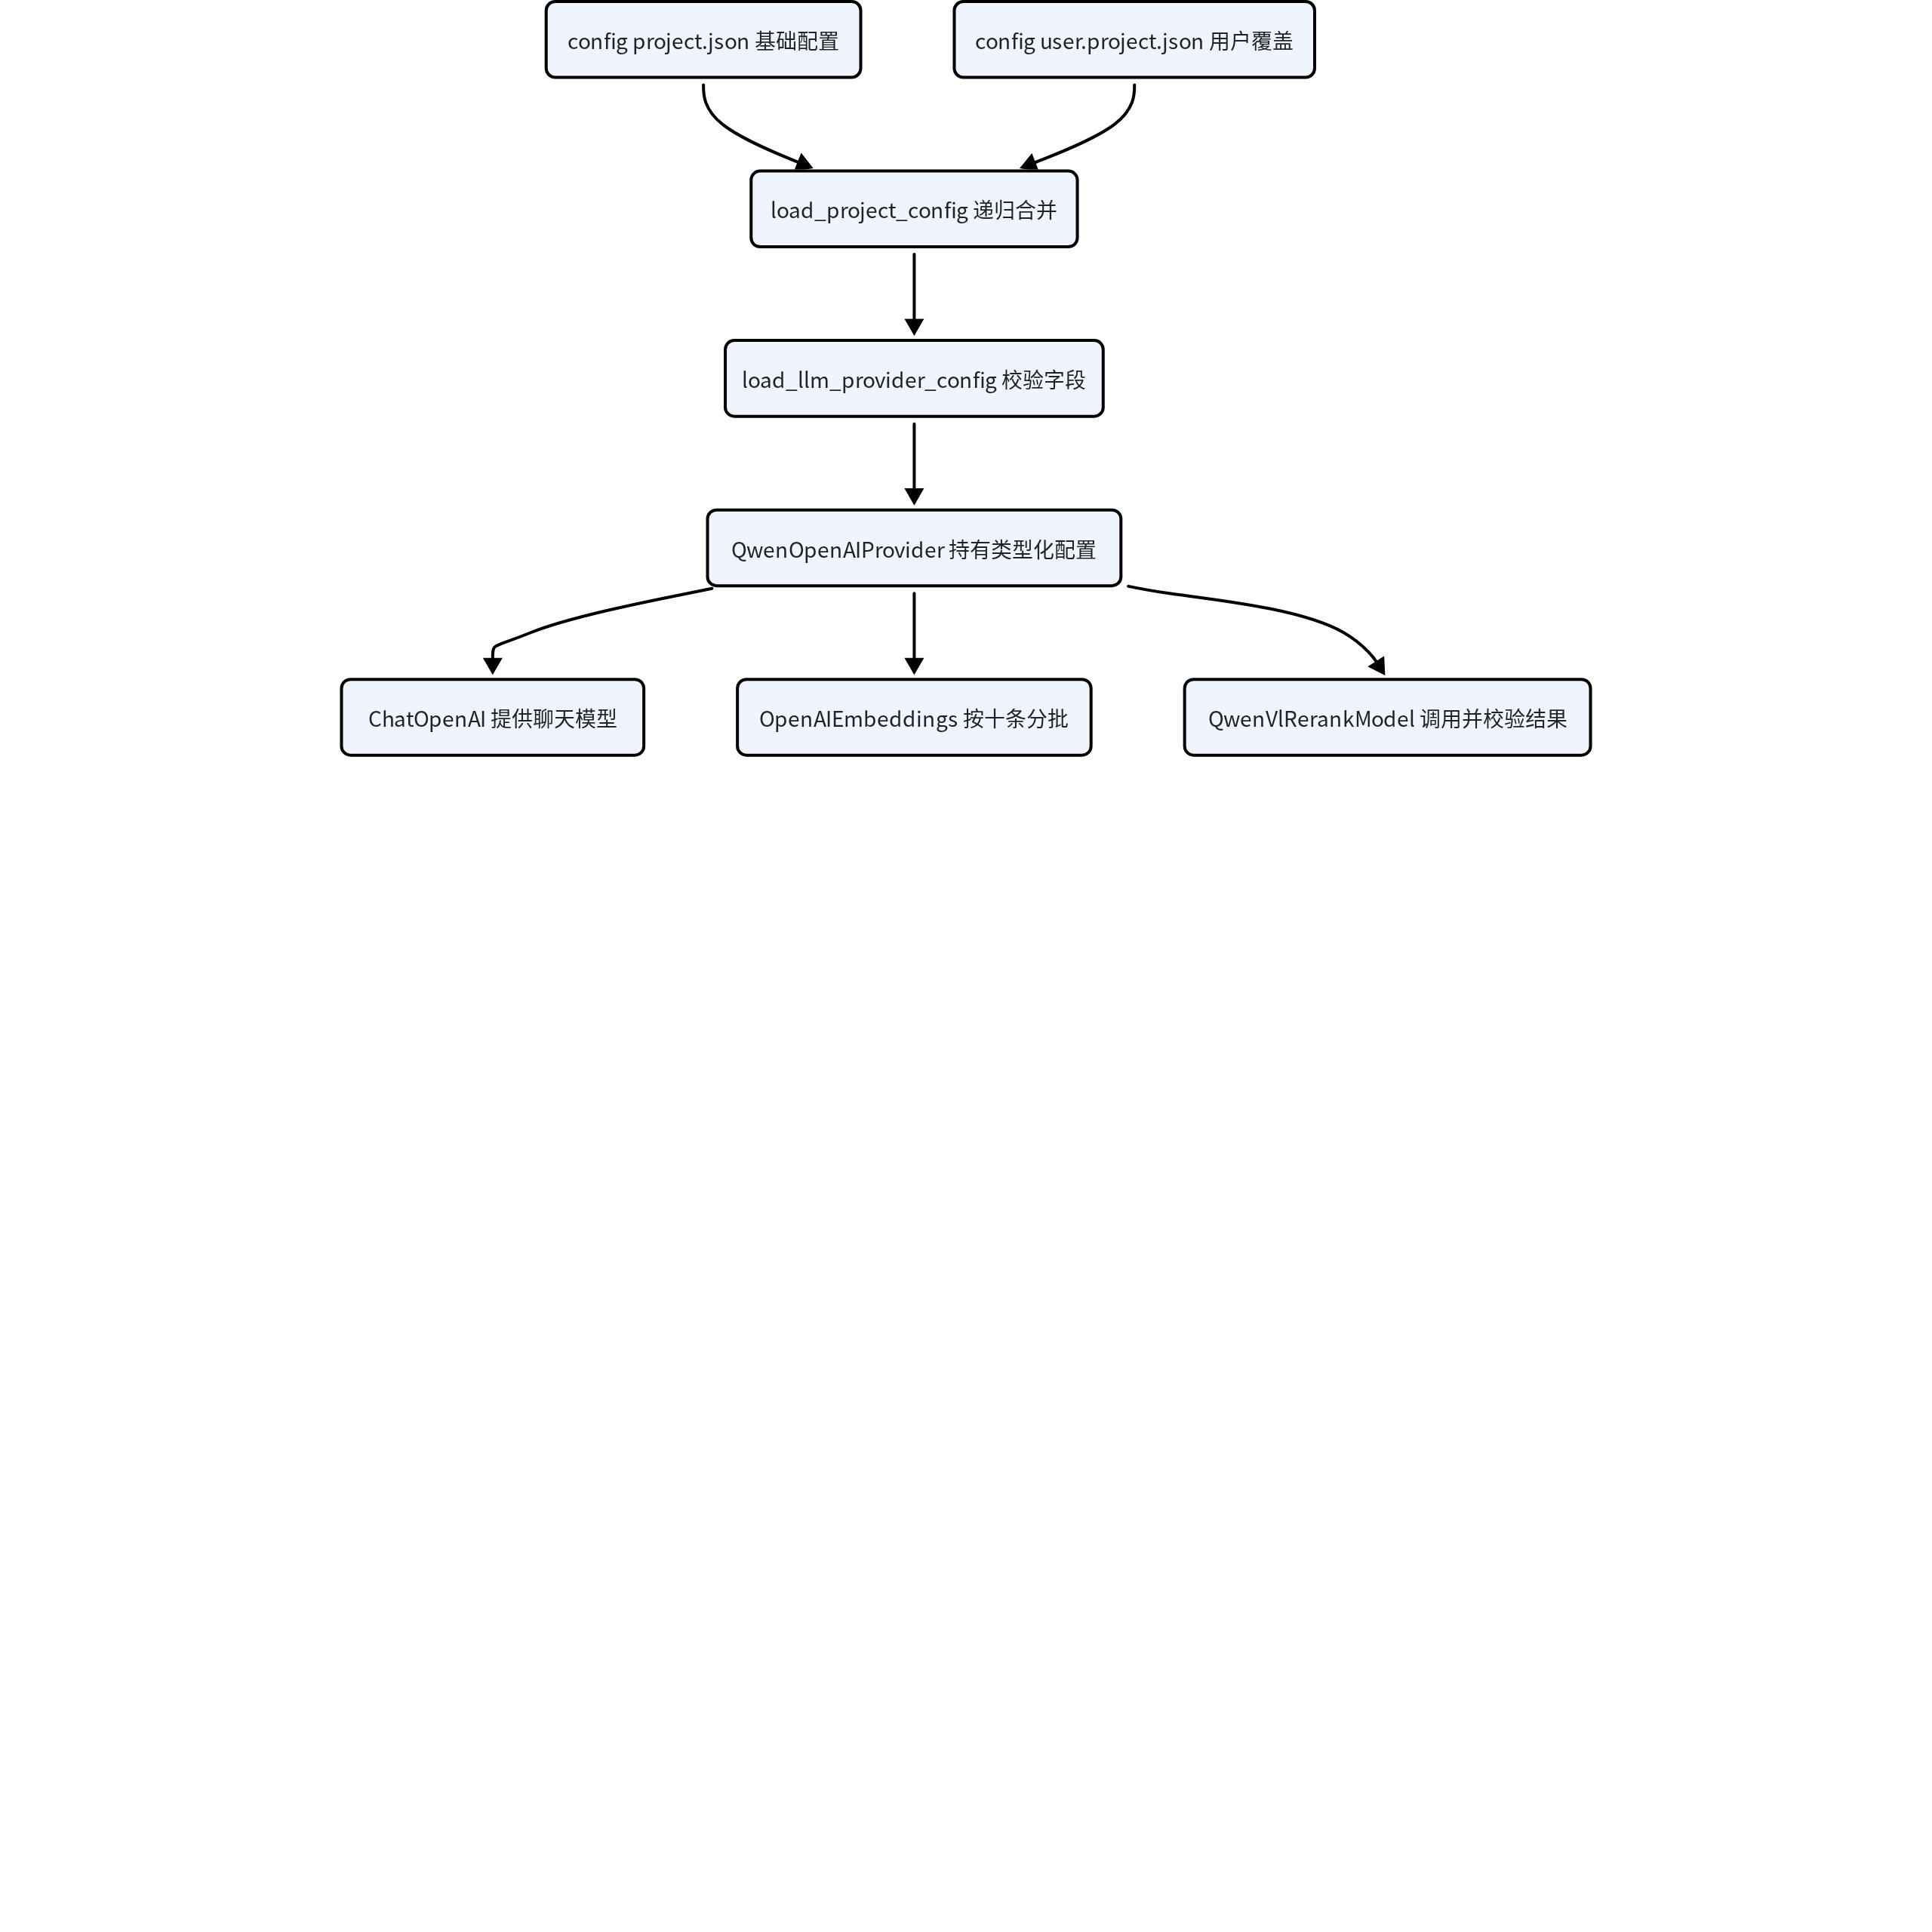
build_default_llm_provider 把类型化配置交给 QwenOpenAIProvider。聊天链路调用 create_chat_model,得到配置过的 ChatOpenAI;文档索引调用 create_embedding_model,得到 OpenAIEmbeddings;混合检索精排调用 create_rerank_model,得到 QwenVlRerankModel。业务模块只依赖 ChatModel、EmbeddingModel、RerankModel 或 LlmProvider 协议。
📷 [图片 token=VjeGbVITqoqJFoxi4VGcrrNVnHg(未能下载,见飞书原文)]
config/project.json
        + 递归覆盖
config/user.project.json
        ↓
load_project_config
        ↓
load_llm_provider_config
        ↓
QwenOpenAIProvider
   ├─ ChatOpenAI:聊天与 Agent
   ├─ OpenAIEmbeddings:知识索引与查询向量
   └─ QwenVlRerankModel:候选精排
📷 [图片 token=Hp8HbfFwJovImKxvjhicYfgInze(未能下载,见飞书原文)]
当前本地配置与测试固定的非敏感模型上下文包括 OpenAI-compatible Qwen provider、qwen3.7-max 聊天模型、text-embedding-v4 embedding、1024 维向量和 qwen3-vl-rerank。基础 URL、温度、超时、重试次数和 model capability 都来自合并配置,不应在业务代码散落硬编码。模型名称是配置事实,不代表外部服务在任意时刻都可用。
📷 [图片 token=EdzEbQRctoMPa6xbp0rcGU6fnZg(未能下载,见飞书原文)]
核心源码地图
| 源码位置 | 关键符号 | 职责 |
|---|---|---|
.gitignore | config/project.json、config/user.project.json 规则 | 阻止本地运行配置和个人覆盖进入版本控制。 |
apps/backend/src/super_ai/project_config.py | load_project_config、_deep_merge、project_config_section | 加载、校验并递归合并两个本地 JSON。 |
apps/backend/src/super_ai/llm/config.py | LlmProviderConfig、load_llm_provider_config | 把弱类型 JSON 转成完整模型运行配置并验证 capability profile。 |
apps/backend/src/super_ai/llm/provider.py | LlmProvider、QwenOpenAIProvider、QWEN_EMBEDDING_BATCH_SIZE | 创建聊天、embedding、rerank 客户端并执行安全 readiness。 |
apps/backend/src/super_ai/llm/rerank.py | RerankModel、QwenVlRerankModel、LlmRerankError | 封装异步 rerank HTTP、重试、响应验证和安全错误。 |
apps/backend/src/super_ai/api/app.py | _llm_provider、_embedding_model、_rerank_model、_llm_readiness_payload | 按需装配模型能力,并将 readiness 转换为安全 API 数据。 |
apps/backend/src/super_ai/documents/indexing.py | DocumentIndexingService | 把文档 chunks 交给 embedding protocol,并验证向量数量后写 Milvus。 |
apps/backend/src/super_ai/retrieval/tool.py | KnowledgeRetrievalTool | 生成查询向量、融合候选并通过 RerankModel 精排。 |
apps/backend/tests/test_llm_provider.py | FakeChatModel、FakeEmbeddingModel | 在无网络环境验证配置、工厂、批处理和 readiness 脱敏。 |
📷 [图片 token=Fei3bh74IoAGPQxqBwhcTS4xn5c(未能下载,见飞书原文)]
代码调用流程图
模型接入从两份本地 JSON 开始,经过递归合并和类型校验后,分别装配聊天、embedding 与 rerank 三条调用边界。
📷 [图片 token=JZ8ebn4lwos2BtxaPMDcqtxrnJc(未能下载,见飞书原文)]
关键实现拆解
确定的 JSON 合并,而不是隐式环境注入
_deep_merge 只在 base 与 override 同一键的值都是 dict 时递归。例如用户文件仅覆盖 llm.apiKey 和 llm.chatModel,基础文件中的 baseUrl 与 timeout 仍保留;若覆盖一个数组,则整个数组替换。用户文件缺失时使用基础配置。没有任何 os.environ 兜底,因此排查配置时只需检查两个 JSON 和显式传入的测试路径。
📷 [图片 token=DsfjbzUijoxByjxovQMcauRen9v(未能下载,见飞书原文)]
required_str 拒绝空字符串,required_int 与 required_float 检查类型,required_dict 约束简单参数对象。底层 ProjectConfigurationError 会被 LlmConfigurationError 包装,但消息只指出缺失或无效字段。缺 apiKey 时错误包含字段名,不包含其他 secret。
📷 [图片 token=VnMXbrE5poOhBZxAaj3cD6Oun4d(未能下载,见飞书原文)]
看什么:配置加载器只确定两个 JSON 路径;用户文件存在时递归合并,否则直接返回基础对象。
📷 [图片 token=FT1Gb1ao7oDAXMxQUcictyKOnJb(未能下载,见飞书原文)]
def load_project_config(
    config_path: Path | str | None = None,
    *,
    user_config_path: Path | str | None = None,
) -> Mapping[str, Any]:
    """Load the repository-level JSON configuration file with user overrides."""
    # 1. 基础配置路径来自显式参数或仓库内固定位置。
    path = Path(config_path) if config_path is not None else DEFAULT_PROJECT_CONFIG_PATH
    config = _read_json_object(path)
    override_path = _default_user_config_path(path, user_config_path)
    # 2. 用户文件存在时递归覆盖,不从环境变量补值。
    if override_path.exists():
        override = _read_json_object(override_path)
        return _deep_merge(config, override)
    return config
📷 [图片 token=U3pfbx1luodg8lxHaZgcXuYSnib(未能下载,见飞书原文)]
代码证明配置来源是确定的文件合并,而不是 shell 当前状态;测试也可以传入隔离路径。失败边界包括文件不可读、非法 JSON、顶层不是 object 和必填字段为空,错误只描述字段与路径,不应把相邻 secret 一并打印。
📷 [图片 token=C01FbggPbo8Xqvxp6jrc3EyznNe(未能下载,见飞书原文)]
看什么:递归合并只发生在两侧都是 dict 的同一键,数组、数字、布尔和字符串会整体替换。
📷 [图片 token=LIy9bdijeo7zbUxHT9FczGCmnEe(未能下载,见飞书原文)]
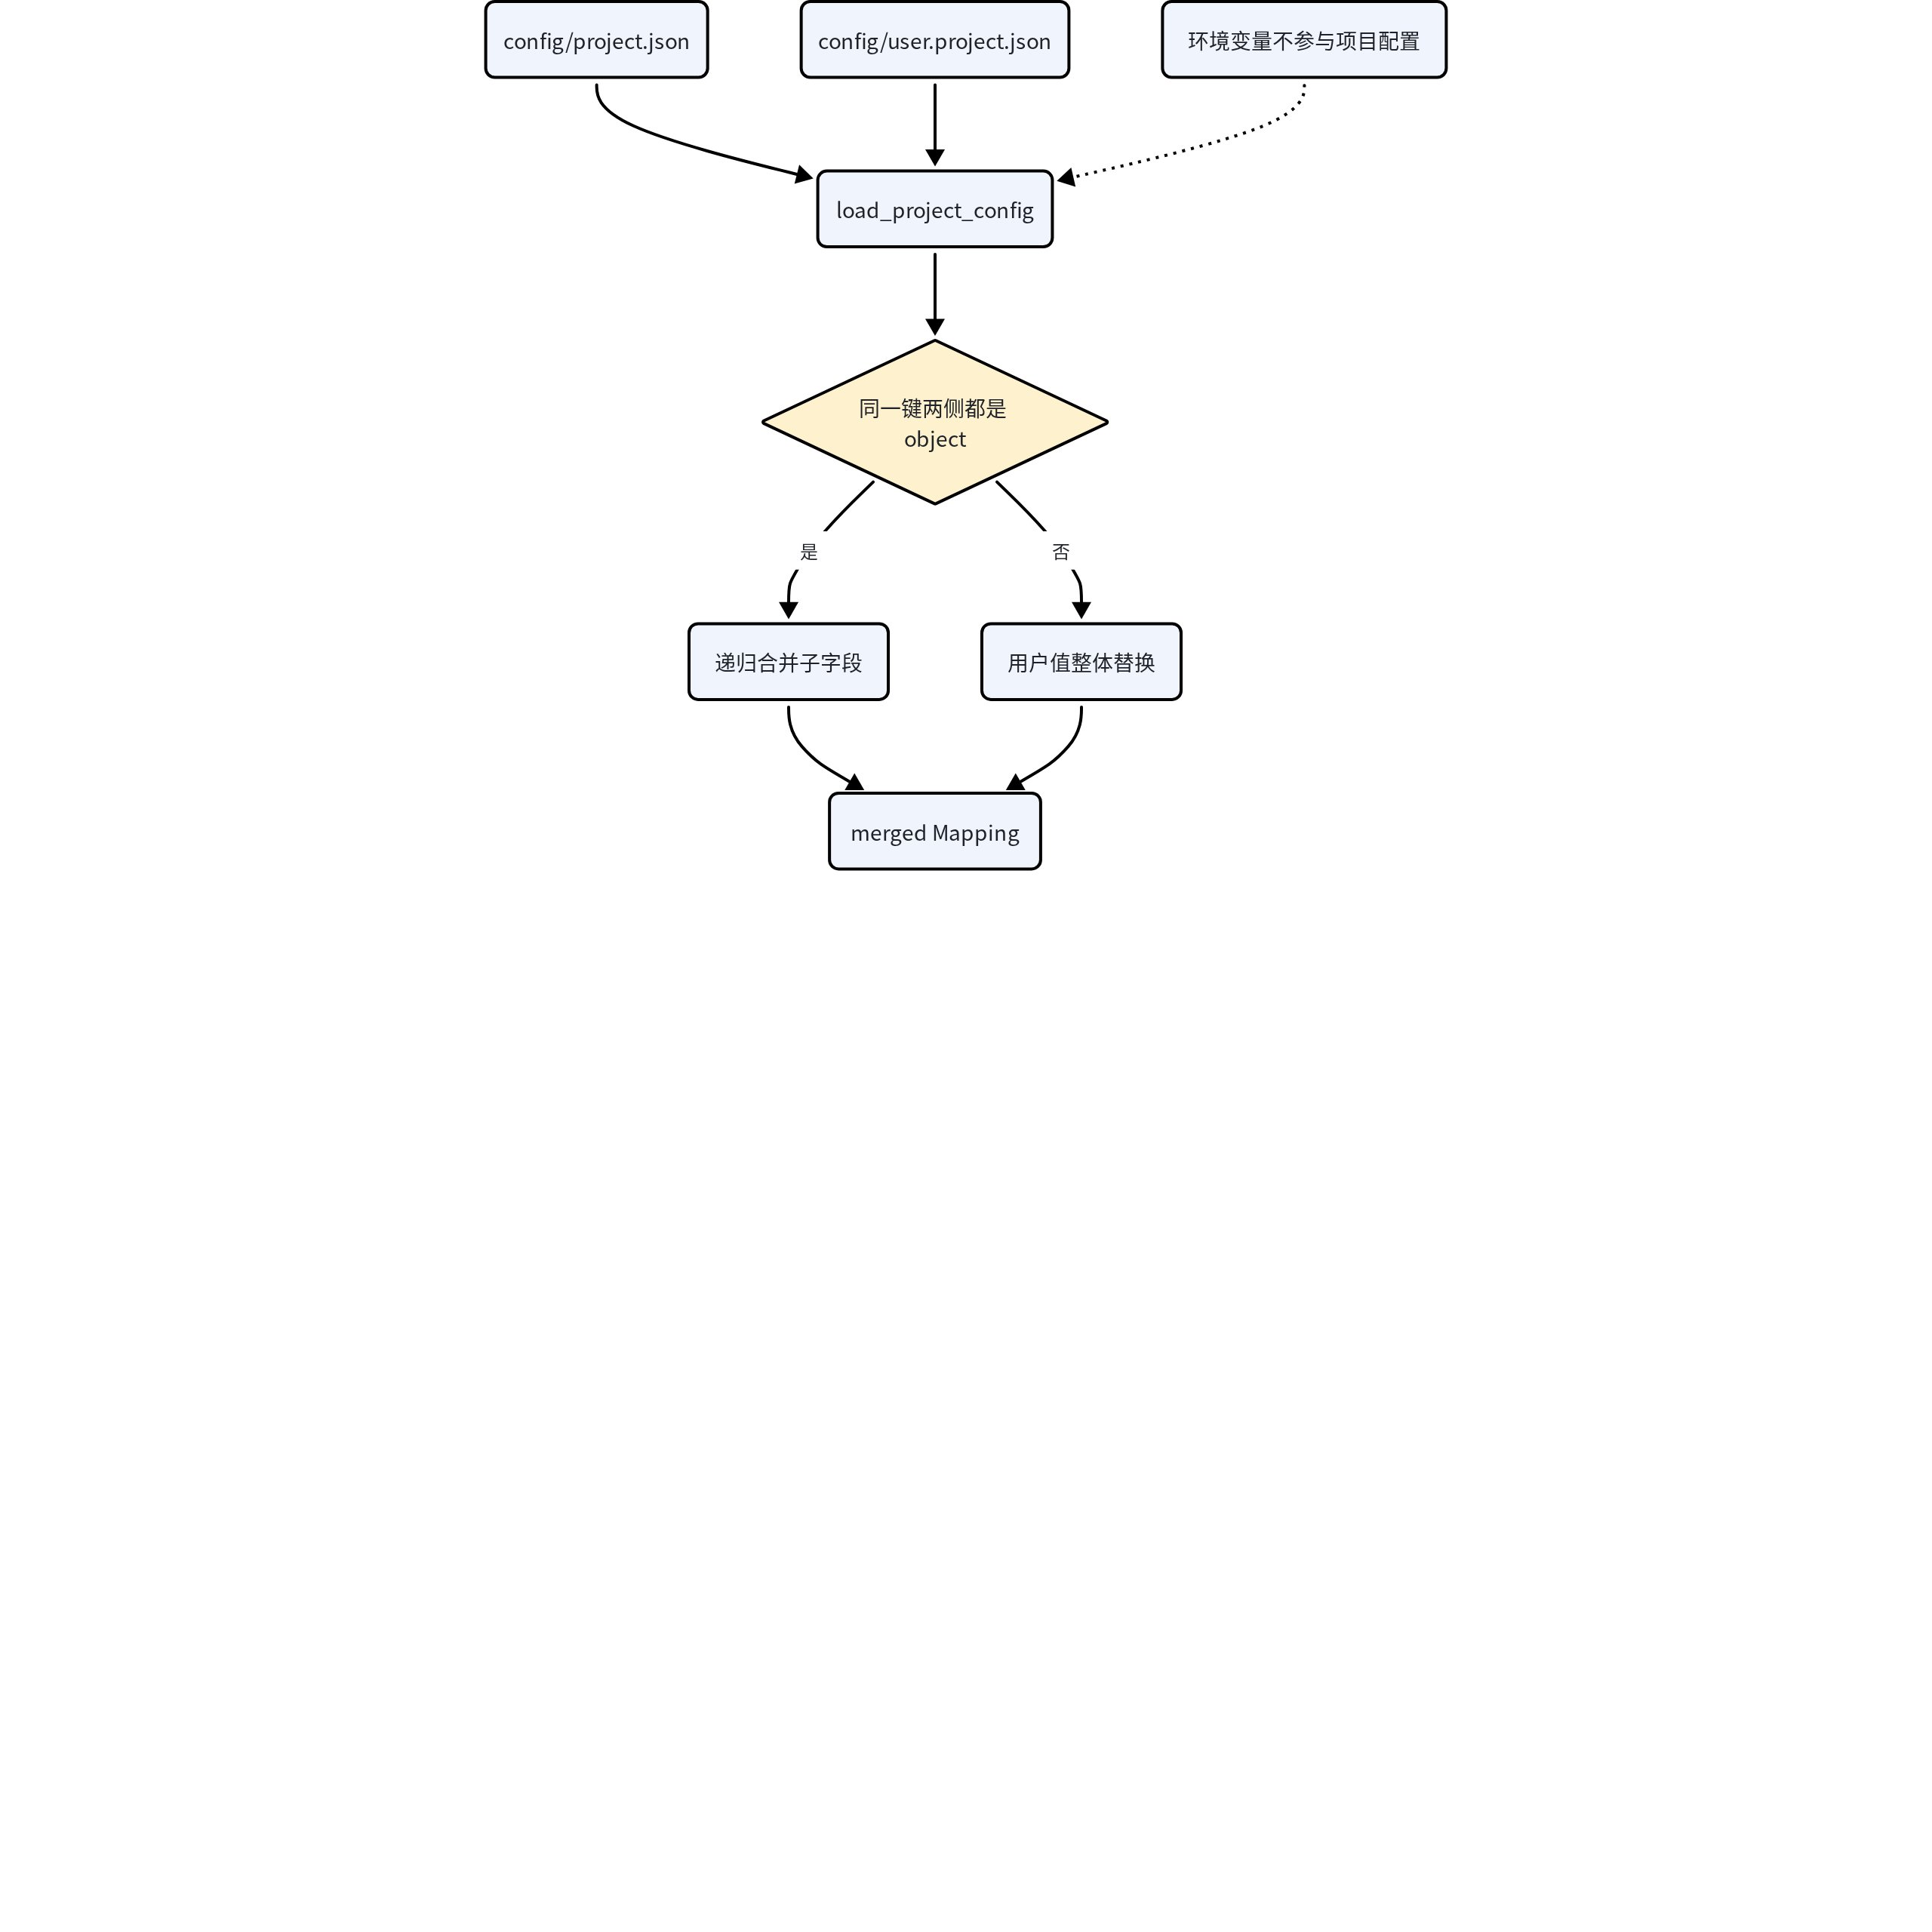
图中虚线表示明确不存在的配置补值路径。用户文件缺失时基础值保留;若基础模板中的必填个人字段仍为空,类型化配置创建会失败,而不是静默从环境取一个可能过期的值。
📷 [图片 token=WDrDbq1SnoAWtExqKUpcm5B2ngd(未能下载,见飞书原文)]
聊天与 embedding 走 OpenAI-compatible 客户端
_create_chat_openai_model 把 api key 作为回调传给 ChatOpenAI,同时设置 base URL、model、temperature、timeout 和 max retries。Provider 协议只要求异步 ainvoke,因此聊天服务、标题生成、记忆压缩或诊断规划可以注入 fake model,而不直接构造厂商客户端。
📷 [图片 token=OszWb7p8SomttwxD7BRc2rw8n6b(未能下载,见飞书原文)]
_create_openai_embedding_model 明确设置 model、dimensions、timeout 和 max retries。它把 chunk_size 设为常量 10,并关闭客户端的 token-ID 上下文切分,让原始字符串或字符串数组送往 Qwen-compatible embedding 接口。超过十个文档 chunk 时,客户端分批请求并按输入顺序汇总;DocumentIndexingService 还验证返回向量数必须等于 chunk 数。
📷 [图片 token=Yuzobe4UeoWVOaxz6MlcVNOVn9e(未能下载,见飞书原文)]
embedding dimension 必须与 Milvus vectorDimension 一致。Provider 只负责生成配置维度的向量,MilvusVectorStore._chunk_to_entity 在写入前再次比较实际向量长度与 collection 设置。这是跨配置边界的防线:模型切换若只改一侧,会明确失败而不是写入不可搜索的数据。
📷 [图片 token=U951bWuqvorUUPxIzyMcymW1n1d(未能下载,见飞书原文)]
看什么:embedding 工厂把模型、维度和每批十条文本的兼容约束一次性传给 LangChain 客户端。
📷 [图片 token=RustbKRRNoSnuYxzDiDcXLLlnJb(未能下载,见飞书原文)]
def _create_openai_embedding_model(config: LlmProviderConfig) -> EmbeddingModel:
    # 1. 继续依赖 OpenAI-compatible 抽象,而非厂商 SDK。
    return cast(
        EmbeddingModel,
        OpenAIEmbeddings(
            api_key=lambda: config.api_key,
            base_url=config.base_url,
            model=config.embedding_model,
            dimensions=config.embedding_dimensions,
            # 2. 这是 provider 批次上限,不是文档文本 chunk 大小。
            chunk_size=QWEN_EMBEDDING_BATCH_SIZE,
            check_embedding_ctx_length=False,
            timeout=config.timeout_seconds,
            max_retries=config.max_retries,
        ),
    )
📷 [图片 token=YNPcbqnc0o2xMgxJl3ic8akBnSn(未能下载,见飞书原文)]
片段证明 embedding 保留原始字符串输入,并由客户端按十条分批;当前测试用十一条输入验证顺序与两次请求。它不保证向量可写入任意 collection,Milvus 仍会检查实际长度与 vectorDimension,不匹配时索引任务必须失败并保留重试状态。
📷 [图片 token=GhLjblOFEosXJDxy9ZQc5irqncd(未能下载,见飞书原文)]
看什么:聊天和 embedding 虽共享 provider 配置与 base URL,却创建不同客户端、服务于不同业务调用。
📷 [图片 token=RsjfbcEAhobQyFx19dCcqdB4nub(未能下载,见飞书原文)]
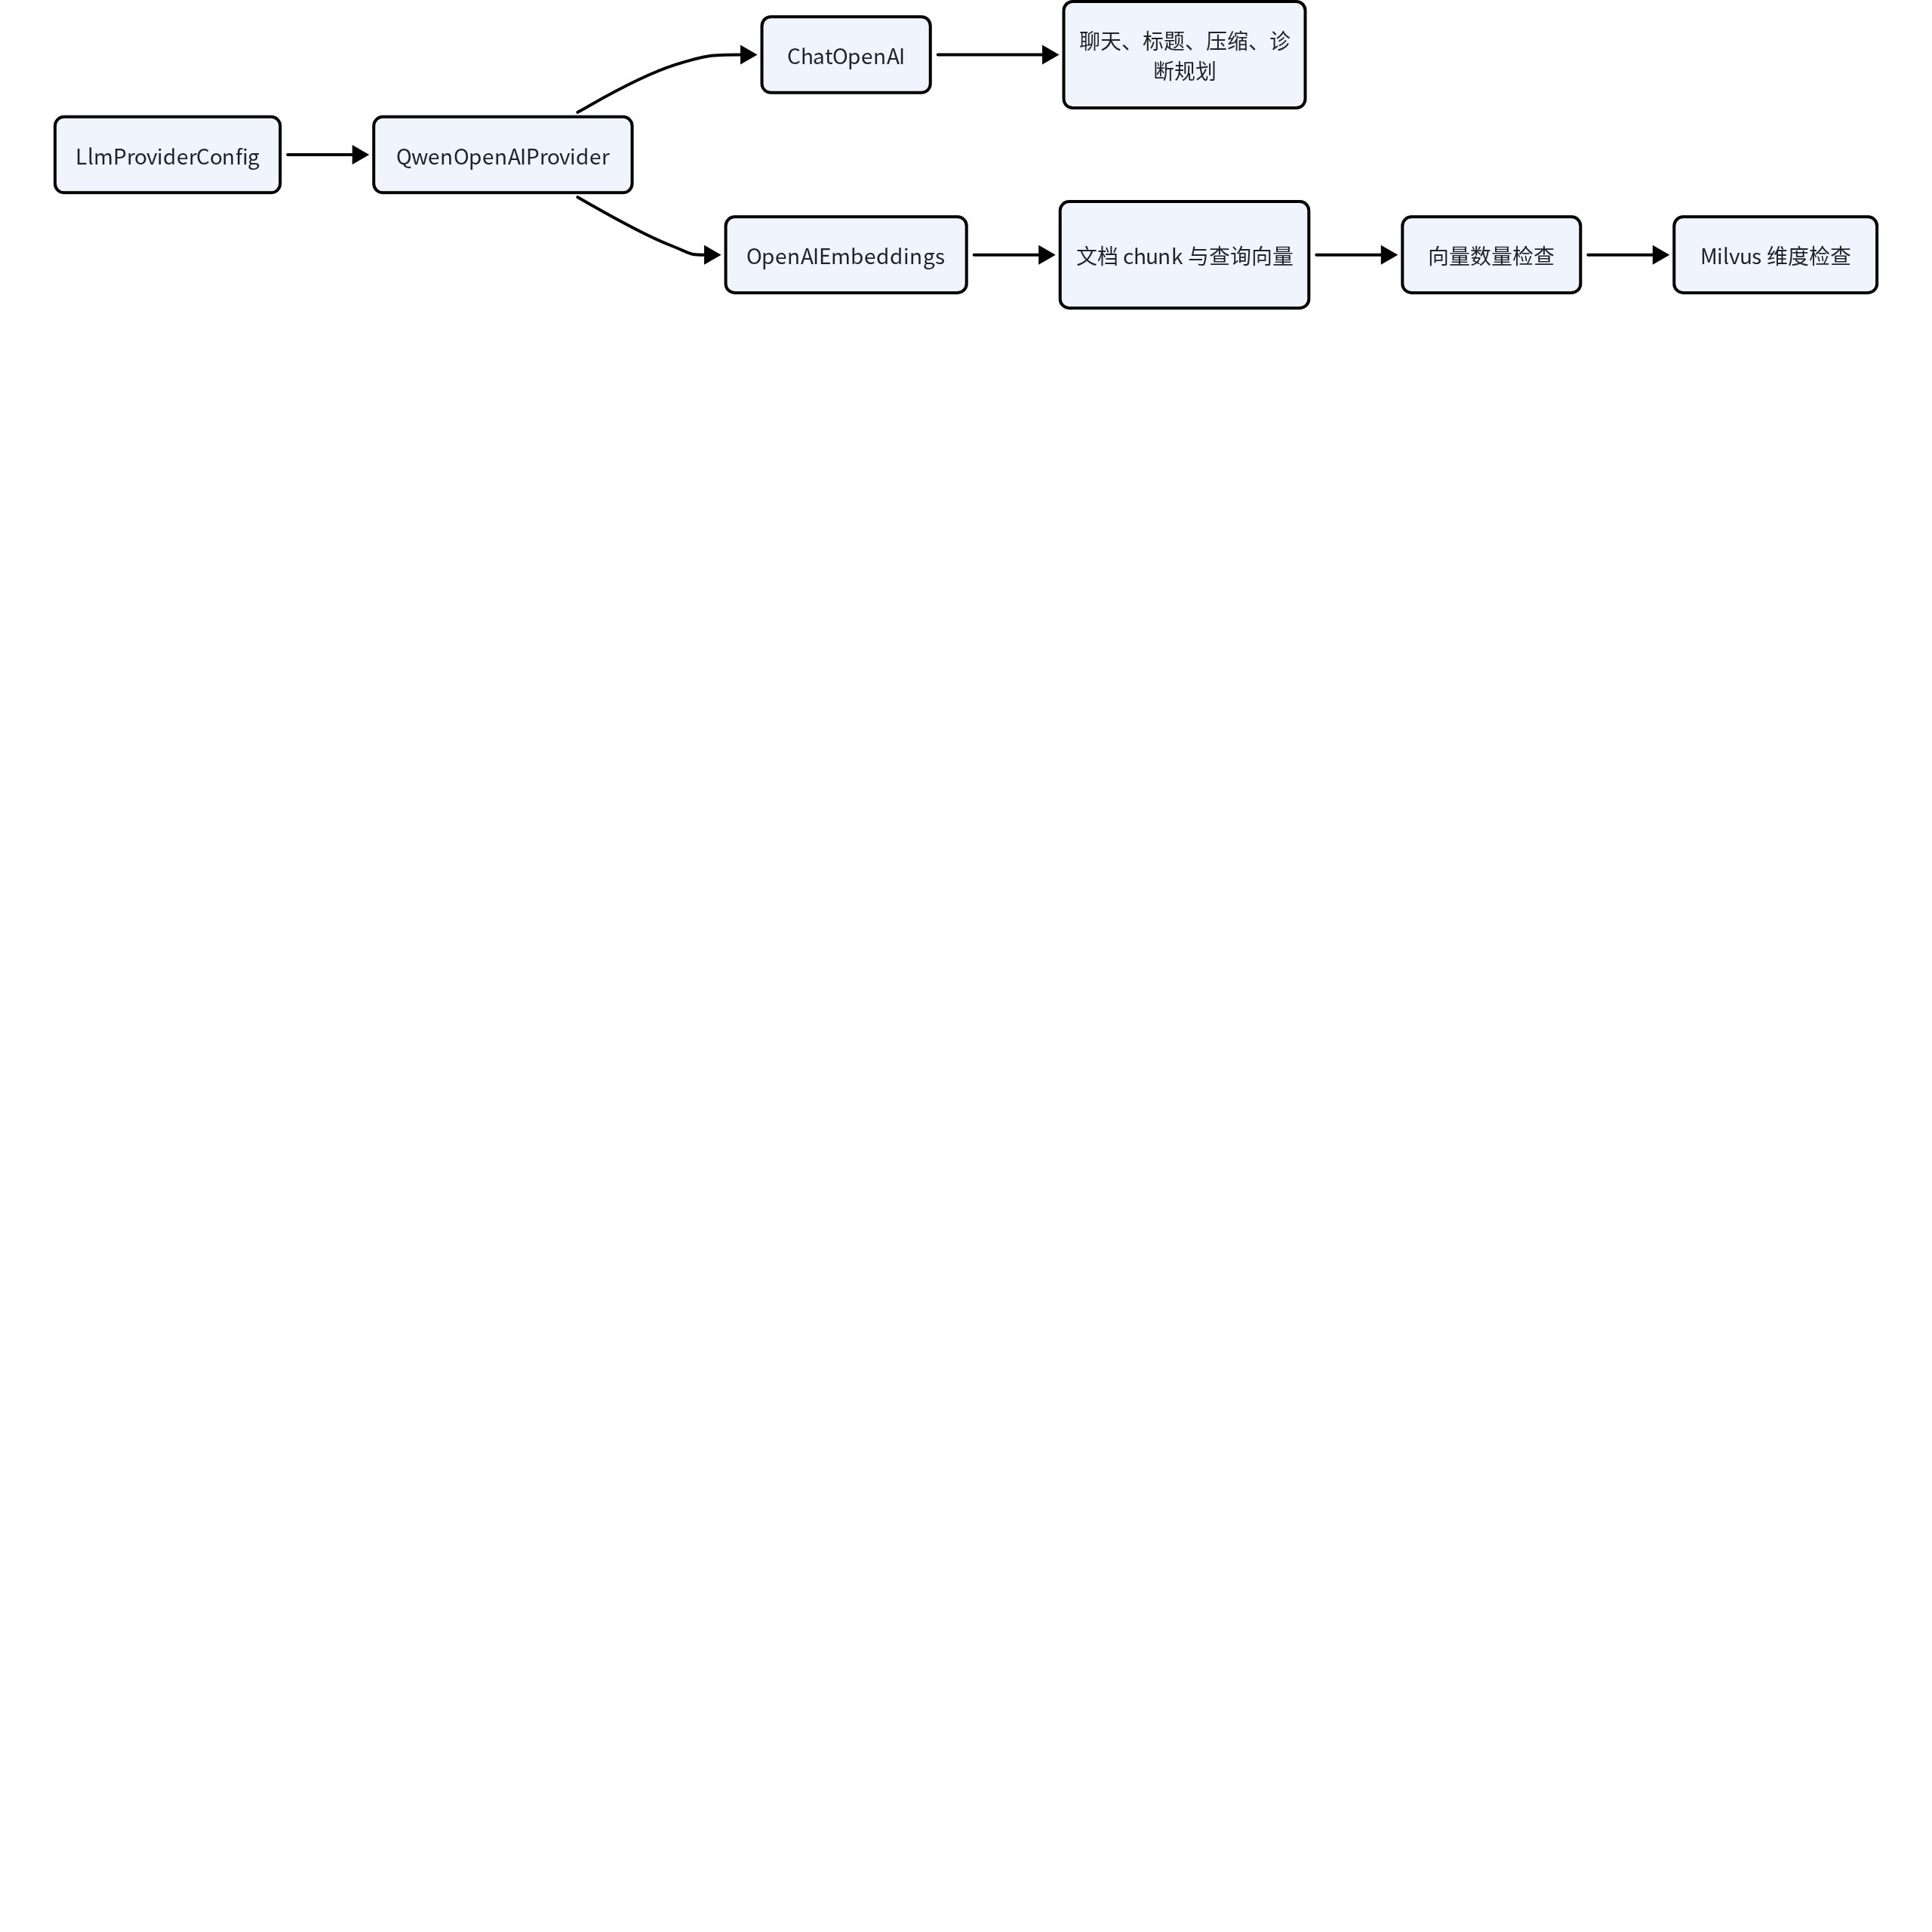
共享配置不等于共享成功状态:聊天模型可用时 embedding 仍可能因模型权限、批次或维度失败。排障和 readiness 需要分别理解能力边界,不能用一次对话成功证明知识索引完整。
📷 [图片 token=ZEw6bjwQvoZVihxbrGtctuLKnng(未能下载,见飞书原文)]
Rerank 是独立协议与直接 HTTP 边界
QwenVlRerankModel.arerank 接收 query、documents 和 top_n;空 query 或空 documents 返回空列表,不发送网络请求。合法请求组装模型、文本和 top_n,通过 bearer header 调用配置 endpoint。429 和服务端错误在重试额度内指数退避,传输或超时也可重试;最终失败统一抛出 LlmRerankError,不附上上游响应正文。
📷 [图片 token=F2XmbOD9Do718ixnbVwcfsgInAd(未能下载,见飞书原文)]
_parse_rerank_results 要求 output.results 是列表,每个结果必须有范围内且不重复的 index,以及 0 到 1 之间的有限 relevance_score。结果按分数降序并截取 top_n。这个验证很关键:外部模型响应属于不可信输入,错误索引可能把一个文档的分数错误关联到另一个文档。
📷 [图片 token=Xs2nbWWotoecK8xMHS9cU6OCnLb(未能下载,见飞书原文)]
看什么:rerank 请求使用独立 endpoint,空输入短路,合法请求只发送模型、查询、候选文本和 top_n。
📷 [图片 token=SjxFbI1s5oVo1zxgLCCcyJmhneb(未能下载,见飞书原文)]
    async def arerank(
        self,
        *,
        query: str,
        documents: Sequence[str],
        top_n: int,
    ) -> list[RerankResult]:
        normalized_query = query.strip()
        # 1. 空查询或空候选不发起外部 HTTP 请求。
        if not normalized_query or not documents:
            return []
        if top_n < 1 or top_n > len(documents):
            raise LlmRerankError("Rerank request is invalid.")

        # 2. 响应中的 index 必须继续映射回这里的候选顺序。
        payload = {
            "model": self._model,
            "input": {
                "query": {"text": normalized_query},
                "documents": [{"text": document} for document in documents],
            },
            "parameters": {"return_documents": False, "top_n": top_n},
        }
        response = await self._post_with_retry(payload)
📷 [图片 token=O09SbPnWMohzvuxT26pc6pisnOf(未能下载,见飞书原文)]
代码证明 rerank 没有被伪装成 OpenAI chat 调用,也没有在空候选时制造分数。外部响应随后必须验证 index、重复、有限分数和范围;超时、429、5xx 或坏 JSON 最终都会成为安全 LlmRerankError,检索层不得退化为把 RRF 分数冒充最终精排分。
📷 [图片 token=O7HybCsTLolMQhxfh07cJMtonoh(未能下载,见飞书原文)]
看什么:从两路粗召回到精排结果,关键的一致性条件是 rerank index 始终引用同一候选数组。
📷 [图片 token=VKAhbb2SDoQym7xSdVtcKcZ2ndc(未能下载,见飞书原文)]
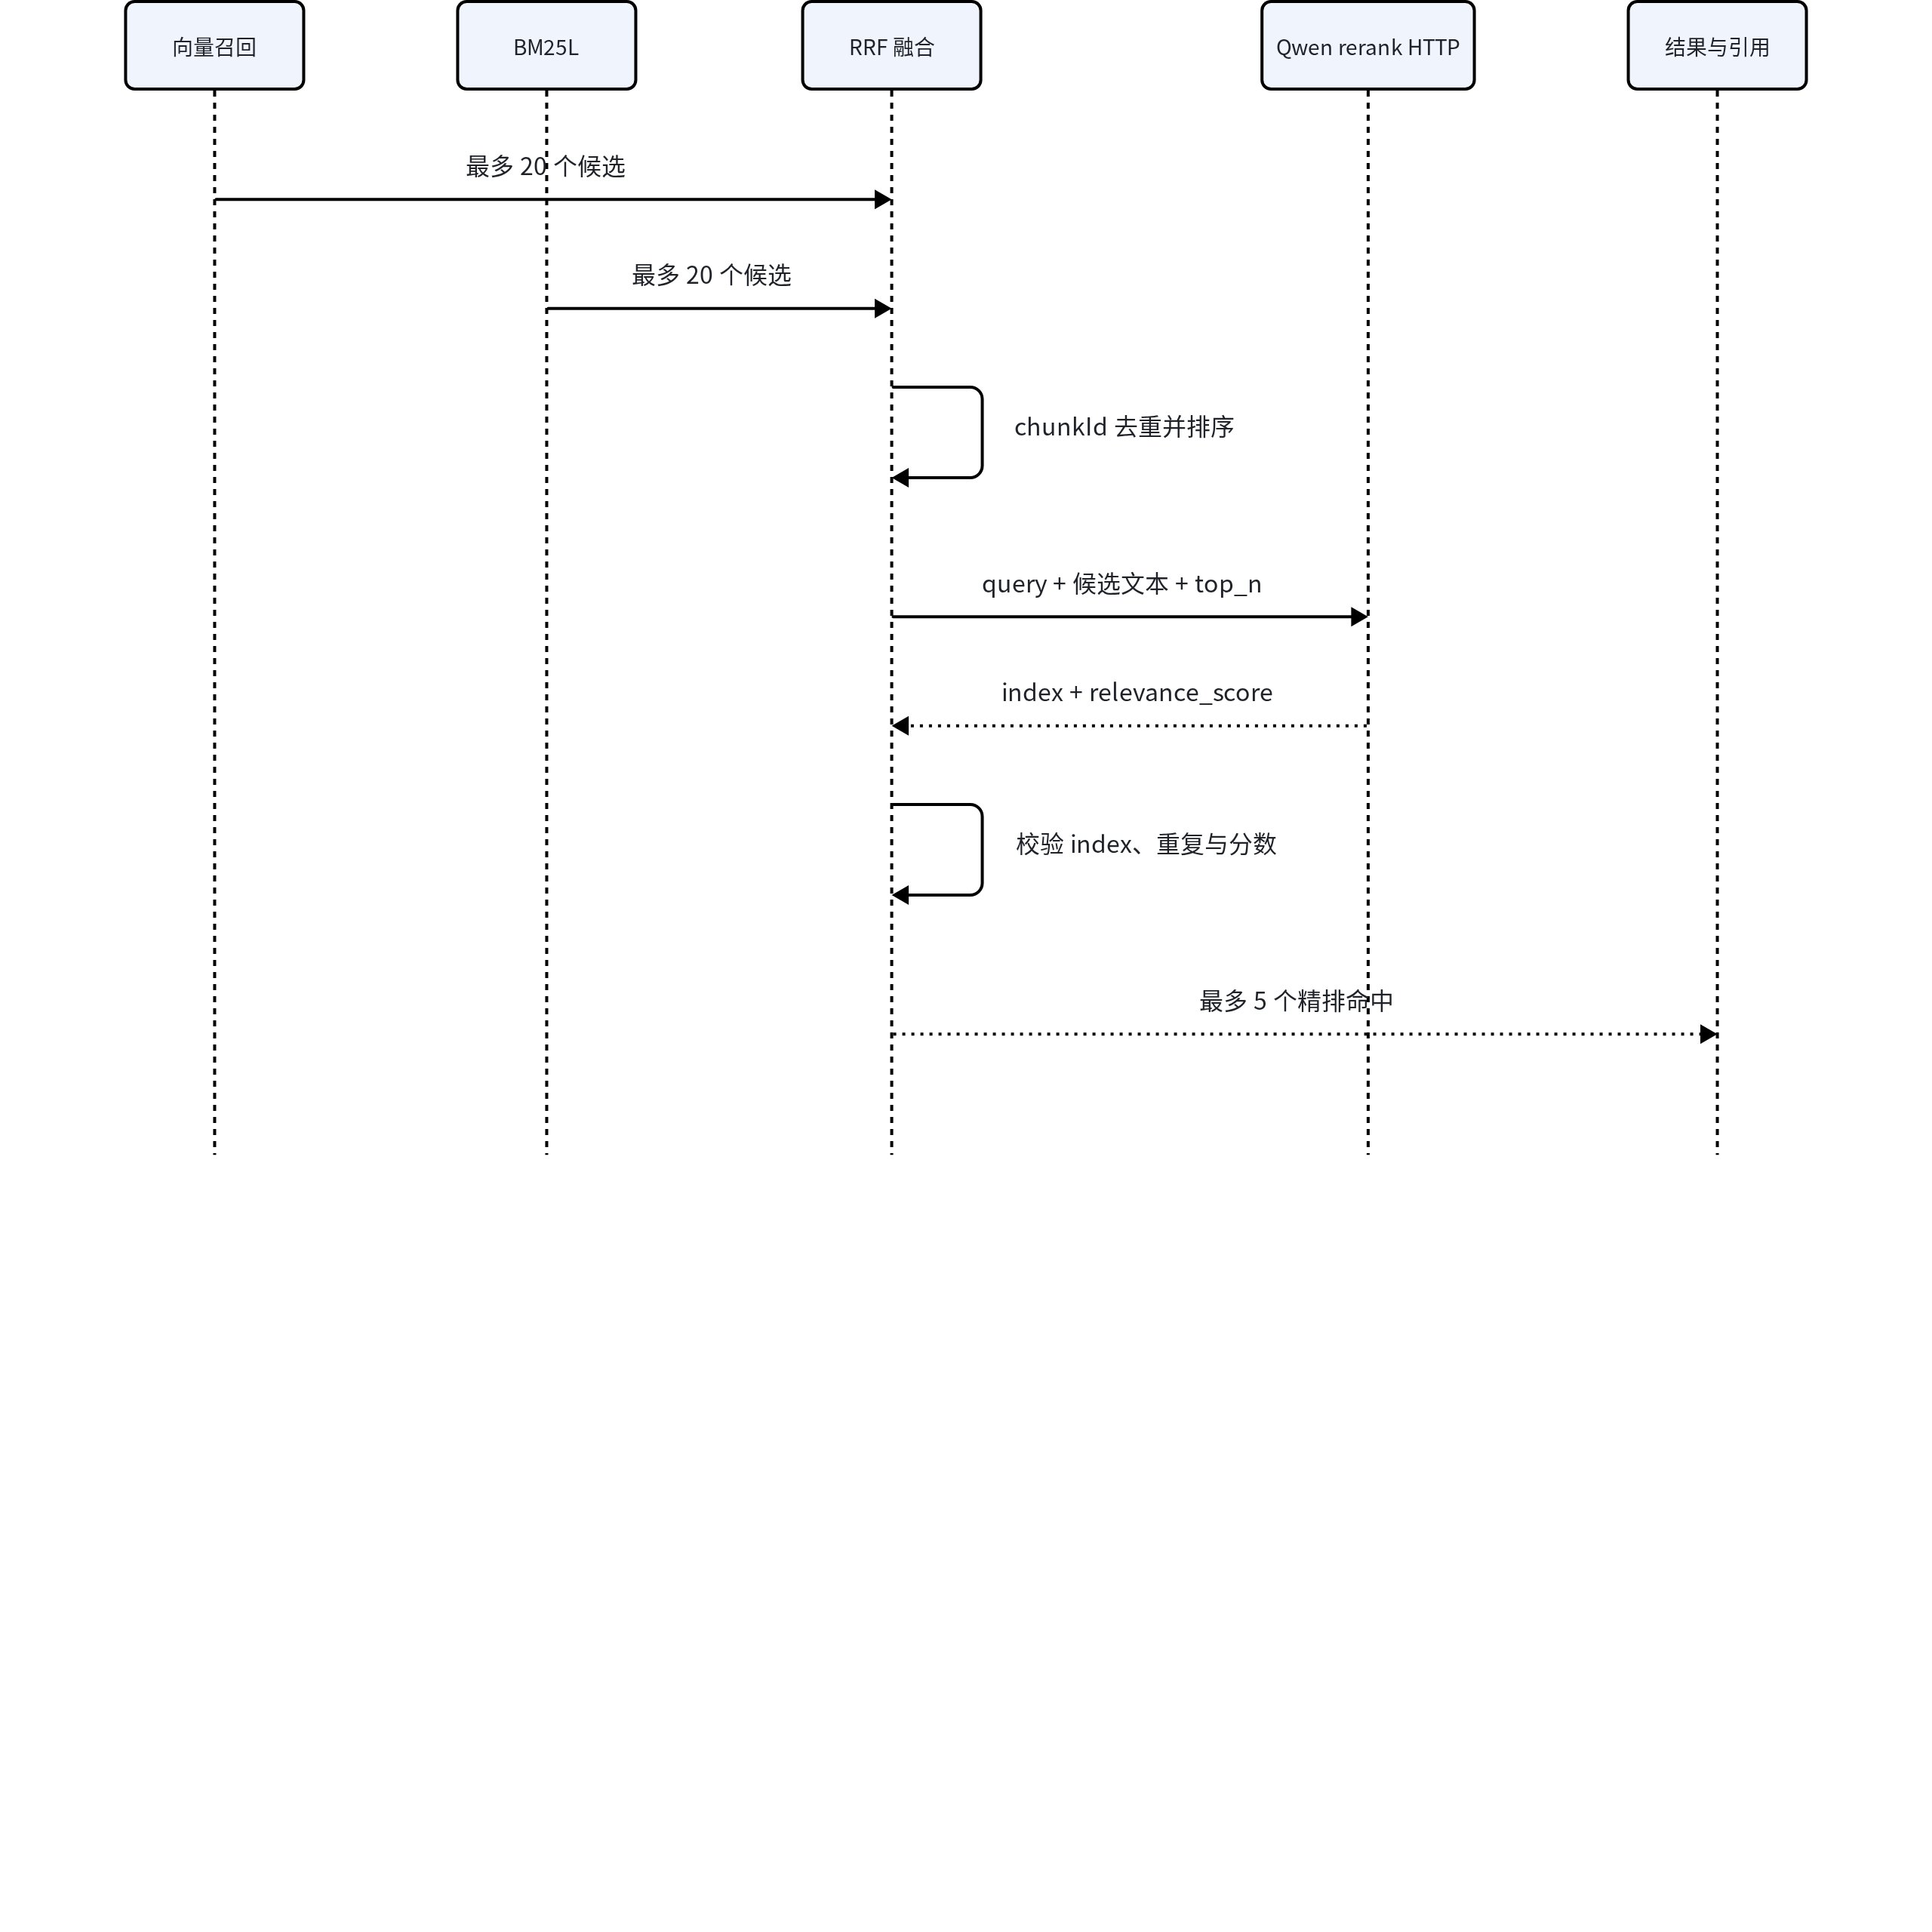
任一粗召回失败时当前实现返回系统不可用,不静默单路降级;rerank 失败也不会产生伪造终分。只有通过校验的 index 才能把分数写回对应 chunk 与引用。
📷 [图片 token=C7jGbrpqaoW4oixWoOucOBNjnYe(未能下载,见飞书原文)]
Readiness 不是一次业务保证
QwenOpenAIProvider.check_readiness 创建 chat model 并执行最小提示,返回 ok、provider、model、base URL、延迟和可选错误。_safe_error_message 会把异常字符串中出现的 api key 替换为 [redacted]。API 层的 _llm_readiness_payload 进一步把失败归一为“LLM provider is unavailable”,所以 /ready 不返回 provider 原始异常。
📷 [图片 token=NPPQbdQ9OoyLjxxeLWxcoHyBnhd(未能下载,见飞书原文)]
/health 完全不探测模型;/ready 实际调用模型并与 SQLite、Milvus、MCP 结果聚合;/config/check 还检查 llm section 能否构造成类型化配置。即使 readiness 成功,后续真实对话仍可能因限流、超时、网络变化或输入规模失败,因此业务流必须保留自己的 error 事件和任务失败状态。
📷 [图片 token=DeVNbjDOJo8dX1x7LUvcUto6nEc(未能下载,见飞书原文)]
看什么:provider readiness 的最小提示只返回安全配置上下文和延迟,异常中的 key 会在结果构造前替换。
📷 [图片 token=NxyRbLwxaobbG2xE8dTc1eu3nKe(未能下载,见飞书原文)]
    async def check_readiness(self) -> LlmReadinessResult:
        started_at = monotonic()
        try:
            model = self.create_chat_model()
            # 1. 最小请求验证当前聊天模型可达。
            await model.ainvoke("Return exactly: ready")
        except Exception as exc:
            return LlmReadinessResult(
                ok=False,
                provider=self._config.provider,
                model=self._config.chat_model,
                base_url=self._config.base_url,
                latency_ms=_elapsed_ms(started_at),
                # 2. readiness 结果不保留可识别的 API key。
                error=_safe_error_message(exc, self._config.api_key),
            )

        return LlmReadinessResult(
            ok=True,
            provider=self._config.provider,
            model=self._config.chat_model,
            base_url=self._config.base_url,
            latency_ms=_elapsed_ms(started_at),
        )
📷 [图片 token=VH0KbcdDmojhtaxJF5ic1fd7n8c(未能下载,见飞书原文)]
片段证明 readiness 是一次真实的最小 chat 调用,不只是检查字段非空;API 层还会把失败错误归一化。它不探测 embedding 与 rerank 的完整业务输入,也不能预言后续限流、长上下文或网络变化,所以索引、检索和聊天仍要分别保存失败。
📷 [图片 token=HR6PbhIkForZkyxDxabcKD7Fn0d(未能下载,见飞书原文)]
看什么:三种健康入口回答的问题不同,不能把 liveness、配置可解析和依赖可用混为一谈。
📷 [图片 token=OPjabTbxko5SeVxjlAVcacPinYb(未能下载,见飞书原文)]
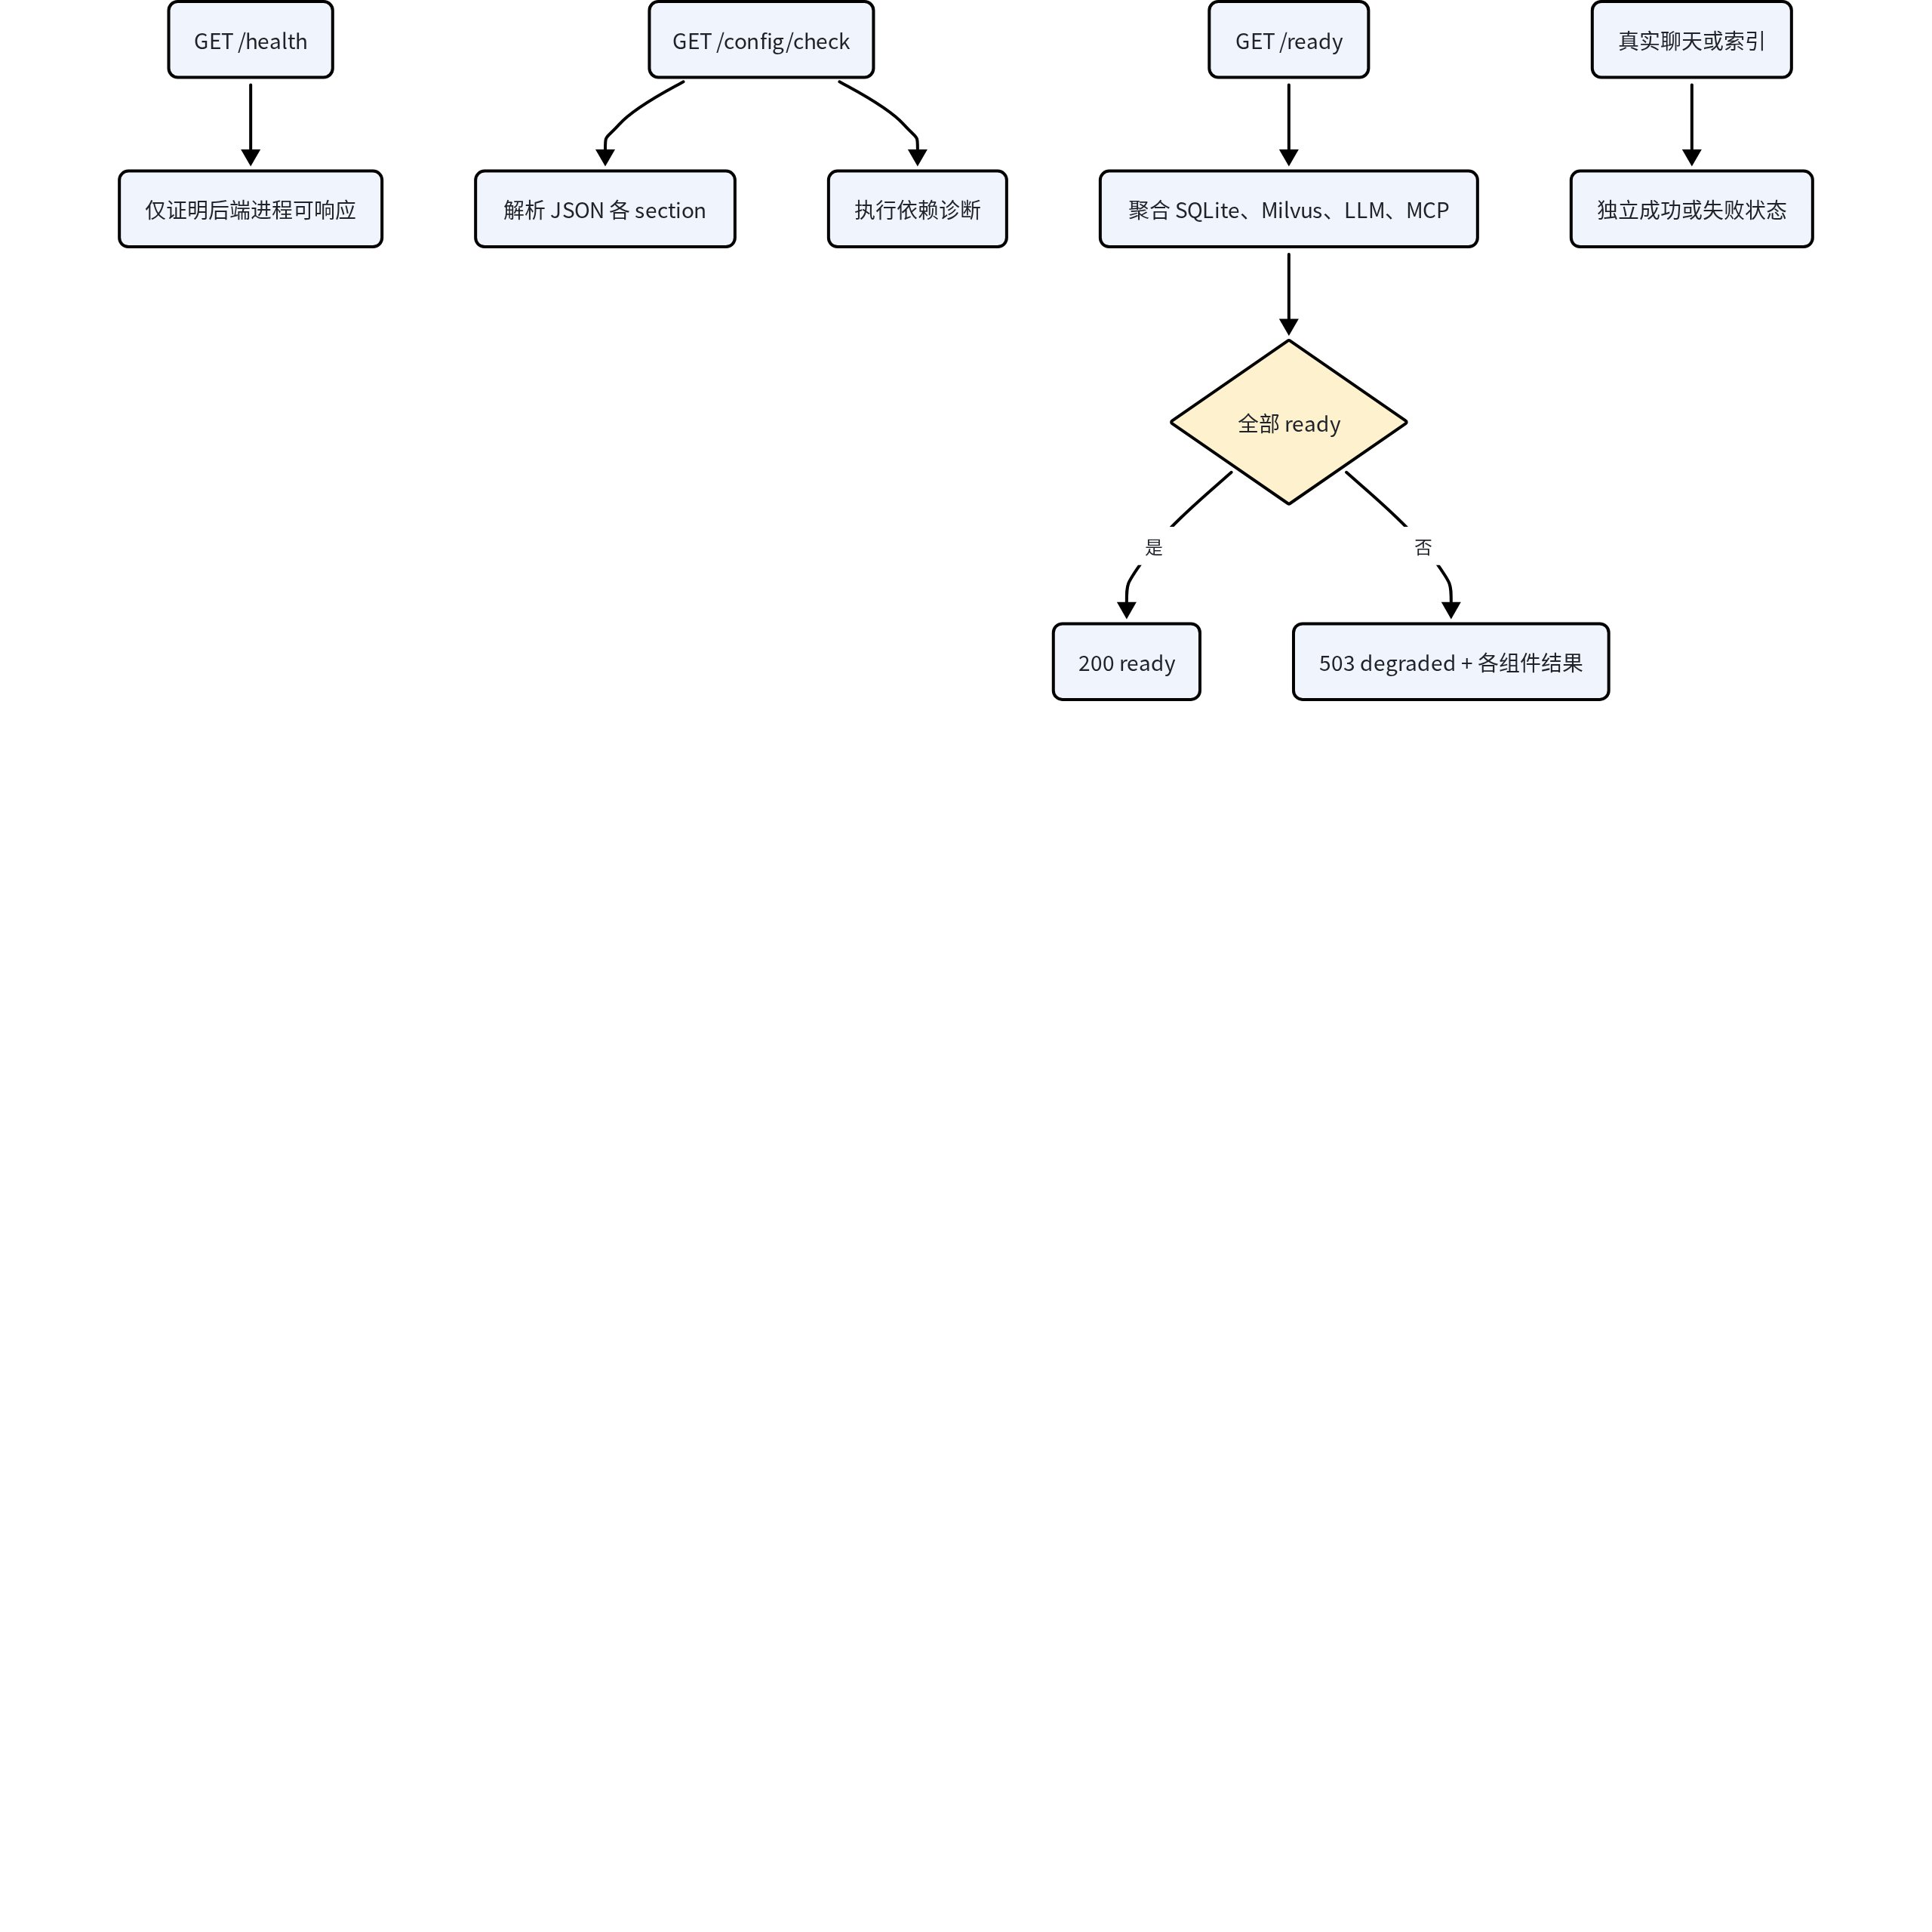
/health 即使模型离线仍可成功;/ready 的 503 仍携带成功 envelope 中的分组件诊断;具体业务可能在 readiness 后失败。恢复动作必须针对所在层,而不是看到 503 就盲目修改密钥。
📷 [图片 token=TvRdbNbqfoOKgsxIMP7cWFdqnTg(未能下载,见飞书原文)]
模型切换需要成组修改
切换 chat model 不能只替换一个字符串。新的 chatModel 必须在 modelCapabilities 中有同名 profile,否则 load_llm_provider_config 明确失败;contextWindowTokens 又会影响会话占用率和自动压缩判断。若同时切换 embedding model,还必须确认 embeddingDimensions 与 vectorStore.vectorDimension 一致,并考虑已有 collection 中向量是否需要重建。rerank model 与 rerankUrl 也应作为一组检查。
📷 [图片 token=TQWsbjoLRocofOxzmcZcK7ewnPd(未能下载,见飞书原文)]
温度、超时和重试不是越大越安全。聊天重试可能增加等待时间,embedding 批次在大文档中会放大总耗时,rerank 的重试还包含指数退避。配置变更后至少要分别验证最小模型调用、超过十个 chunk 的 embedding、Milvus 维度写入以及 rerank 响应校验,不能用一次聊天成功概括全部模型能力。
📷 [图片 token=Hu7JbxRn4oty2sxDOPecwcDynRf(未能下载,见飞书原文)]
看什么:模型切换是三个耦合组而不是一个名称替换,图中每组都标出当前代码实际消费该字段的边界。
📷 [图片 token=IHOGbKXQUoNpElxc7mjcMt4knpA(未能下载,见飞书原文)]
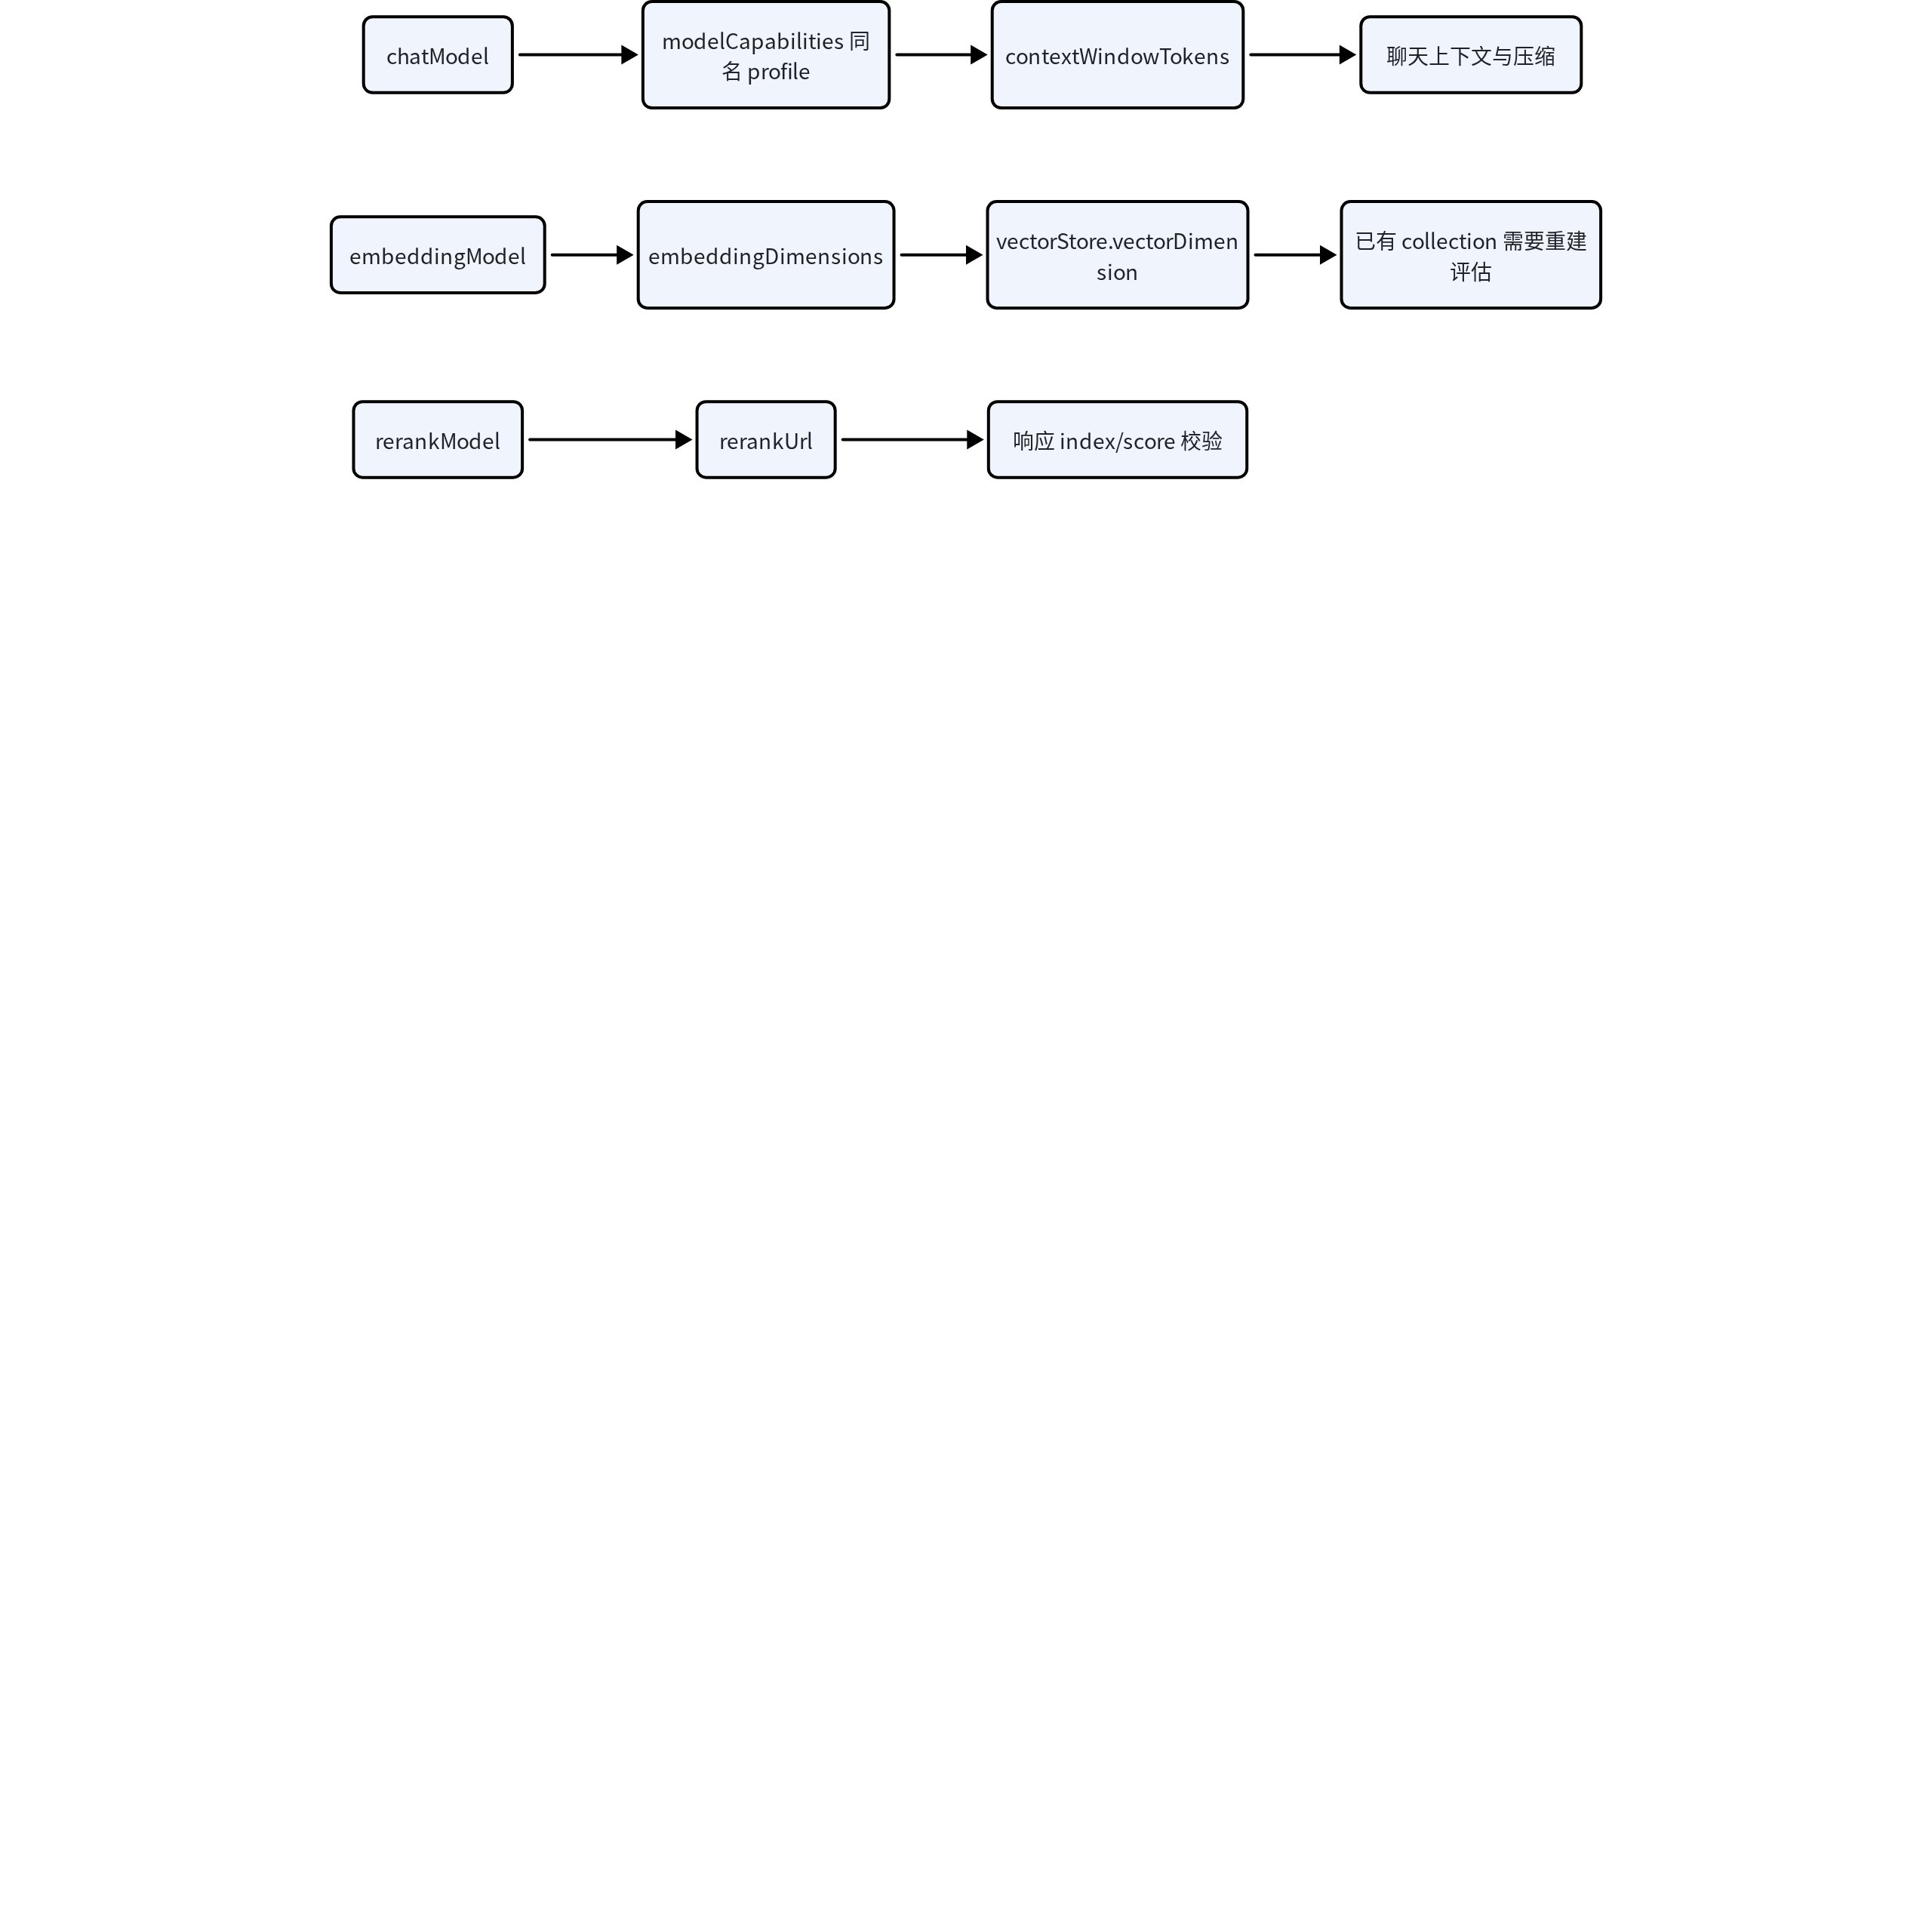
任何一组只改一半都会明确失败或产生不可搜索的数据风险。切换后需要受控重启重新装配 provider,并分别验证 chat、十一条以上 embedding、Milvus 写入和 rerank;旧后台任务还要避免在一次执行中跨越两套配置。
📷 [图片 token=HrhWbn3V2oaM9Ax3Lwlcx4R2nIb(未能下载,见飞书原文)]
依赖注入让失败可以被确定地测试
QwenOpenAIProvider 构造函数接受 model_factory、embedding_factory 和 rerank_factory。create_app 也允许注入 llm_provider、embedding_model、rerank_model 和 chat_agent_runner。这些入口使测试能记录输入、返回固定向量或主动抛错,而无需访问外部服务。可测试性不是额外便利,它证明业务层真正依赖协议,而没有在深处偷偷创建网络客户端。
📷 [图片 token=X5yxb817WorojNxzvuFczWFenXb(未能下载,见飞书原文)]
例如 readiness 测试注入 FakeChatModel,可以确认最小提示确实调用模型,并检查结果 repr 不含 api key;索引测试注入 embedding fake 与 vector store fake,可以确认 chunk 顺序、向量数量和状态更新;聊天测试注入 Agent runner,可以确认越权时 runner 调用次数保持为零。这些断言比 mock 一个 HTTP 状态更接近安全边界。
📷 [图片 token=UuJ8bVeKdo5PhRxh5uMczUMunec(未能下载,见飞书原文)]
看什么:provider 构造函数保留三个工厂插槽,并在未注入时才选择真实客户端工厂。
📷 [图片 token=IyoWbOmUMobpiGxj8TbcM12bnaf(未能下载,见飞书原文)]
    def __init__(
        self,
        config: LlmProviderConfig,
        model_factory: ModelFactory | None = None,
        embedding_factory: EmbeddingFactory | None = None,
        rerank_factory: RerankFactory | None = None,
    ) -> None:
        self._config = config
        # 1. 测试可注入只记录输入、不访问网络的 chat factory。
        self._model_factory = model_factory or _create_chat_openai_model
        # 2. embedding 与 rerank 也有独立替换点。
        self._embedding_factory = embedding_factory or _create_openai_embedding_model
        self._rerank_factory = rerank_factory or _create_qwen_rerank_model
📷 [图片 token=AIwibHmO0oaLLhxueUicX9MDnie(未能下载,见飞书原文)]
代码证明业务层可以依赖稳定协议,并让不同能力独立失败;测试无需 monkeypatch 厂商 SDK。边界是 fake 只能证明本地编排和错误处理,不能替代真实 endpoint 的集成验证;线上凭据、限流和响应兼容仍需安全的 readiness 与显式业务测试。
📷 [图片 token=HkLebSfG5oHXVQxOpV3c9TJKnVe(未能下载,见飞书原文)]
配置排障的分层路径
遇到模型不可用时,先判断是文件、字段、连接还是业务输入。文件层由 load_project_config 报告无法读取、非法 JSON 或顶层非 object;字段层由 load_llm_provider_config 报告缺失、空值、类型错误或 capability 不匹配;连接层由 /ready 的 llm 组件给出降级;业务层则由聊天 SSE、索引任务或检索工具记录具体失败状态。按层排查可以避免因为一次 503 就反复改动密钥。
📷 [图片 token=GufZb6GRXoiLcHxXYPVcj1v7nid(未能下载,见飞书原文)]
/config/check 会同时返回 configuration 与 dependencies。configuration.llm 有效只表示必要字段能被解析,并会暴露安全的 provider、model 与 base URL;dependencies.llm 才表示最小请求结果。若前者失败,应先修 JSON;若前者成功而后者失败,再检查 endpoint、网络、模型权限、限流或服务状态。响应不会提供原始上游正文,进一步诊断应在不泄密的本地环境进行。
📷 [图片 token=KLjybaMsCo0FoRx5Kw1czHqtnkf(未能下载,见飞书原文)]
看什么:排障树先使用无网络证据,再逐层进入真实调用,避免在无法读取 JSON 时就怀疑远端模型。
📷 [图片 token=Xkf7bOfRUoFq1CxB3YIc4XDjnTo(未能下载,见飞书原文)]
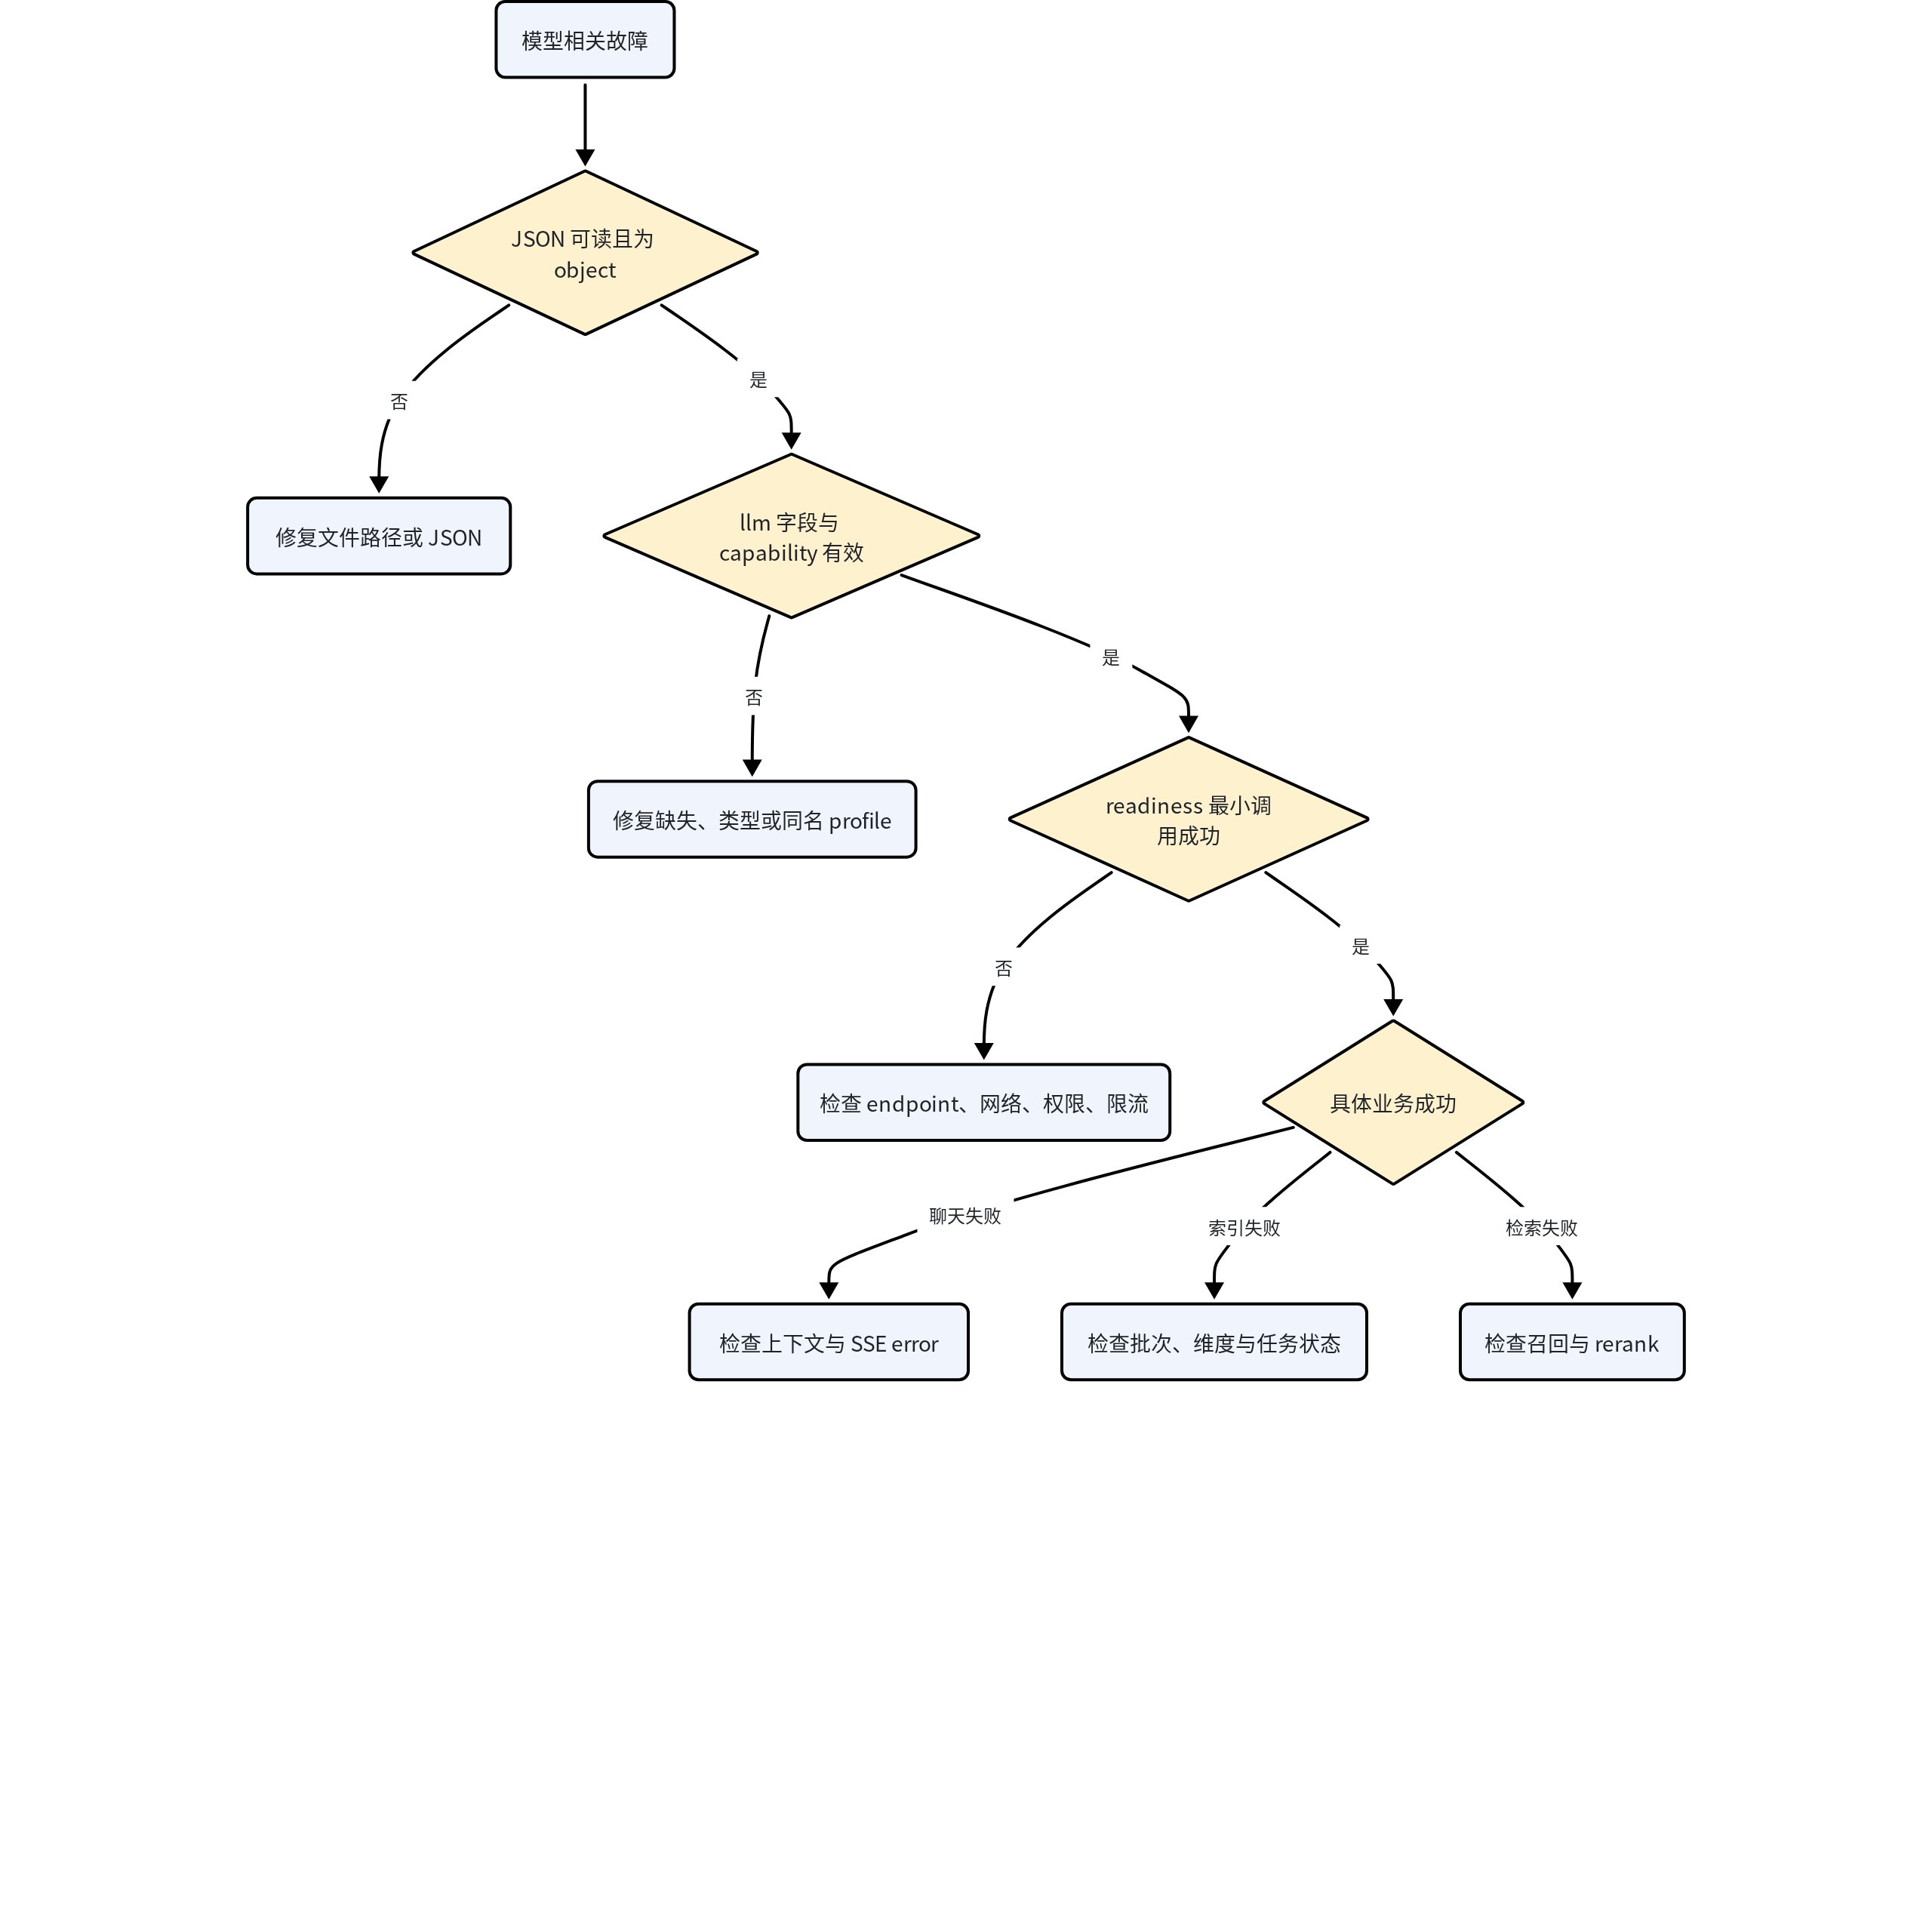
每个节点都对应不同证据与恢复动作。安全诊断只返回 provider、模型、base URL 和组件状态,不返回 key 或上游正文;需要更深排查时也应保持本地日志脱敏,不能用扩大响应内容换取便利。
📷 [图片 token=XHixbxM20oNPCsx5moYcpErgnjc(未能下载,见飞书原文)]
本地文件与外部服务的责任分离
项目配置不读取环境变量,但宿主机启动器会从同一 JSON 合并结果为外部 CLS MCP 进程导出它所需的进程变量。这不改变后端 LLM 的读取规则:聊天、embedding 和 rerank 仍从 apps/backend/src/super_ai/project_config.py 读取 JSON。区分“应用项目配置”和“外部进程启动接口”可以避免误以为在 shell 中设置一个模型 key 就会覆盖后端配置。
📷 [图片 token=OnwSbSS5yoxf7KxqofjcngAIned(未能下载,见飞书原文)]
本地 JSON 也不是远端密钥管理系统。它解决的是单机开发中的明确来源、覆盖和版本控制隔离;多人共享、集中轮换、最小权限和审计仍需要组织层面的密钥管理流程。当前代码能保证不主动从环境补值和不在安全诊断中返回 key,但不能阻止拥有本机文件读取权限的人查看文件。
📷 [图片 token=ZLbrbpqgLoFZdnx9lW1cmEFonzc(未能下载,见飞书原文)]
配置文件发生修改后,已经创建的 provider 对象不会自动热更新。应用在按需构建默认 provider 时读取当时的合并结果,长期运行的对象持有不可变 LlmProviderConfig。因此切换模型或轮换 key 后,应通过受控重启重新装配,并再次执行配置检查和 readiness;不要假定编辑 JSON 会改变正在进行的聊天或索引任务。重启前还应等待或取消重要后台任务,避免同一任务的不同阶段使用不同模型配置。
📷 [图片 token=XWOQbCylropZj5xbFIccyFvnn0n(未能下载,见飞书原文)]
看什么:责任图把本地 JSON、宿主机应用对象和远端能力分开,并标出编辑文件后不会自动更新已缓存 provider。
📷 [图片 token=HryHbqG2xogfWxxLQ9dcUxQ9n0g(未能下载,见飞书原文)]
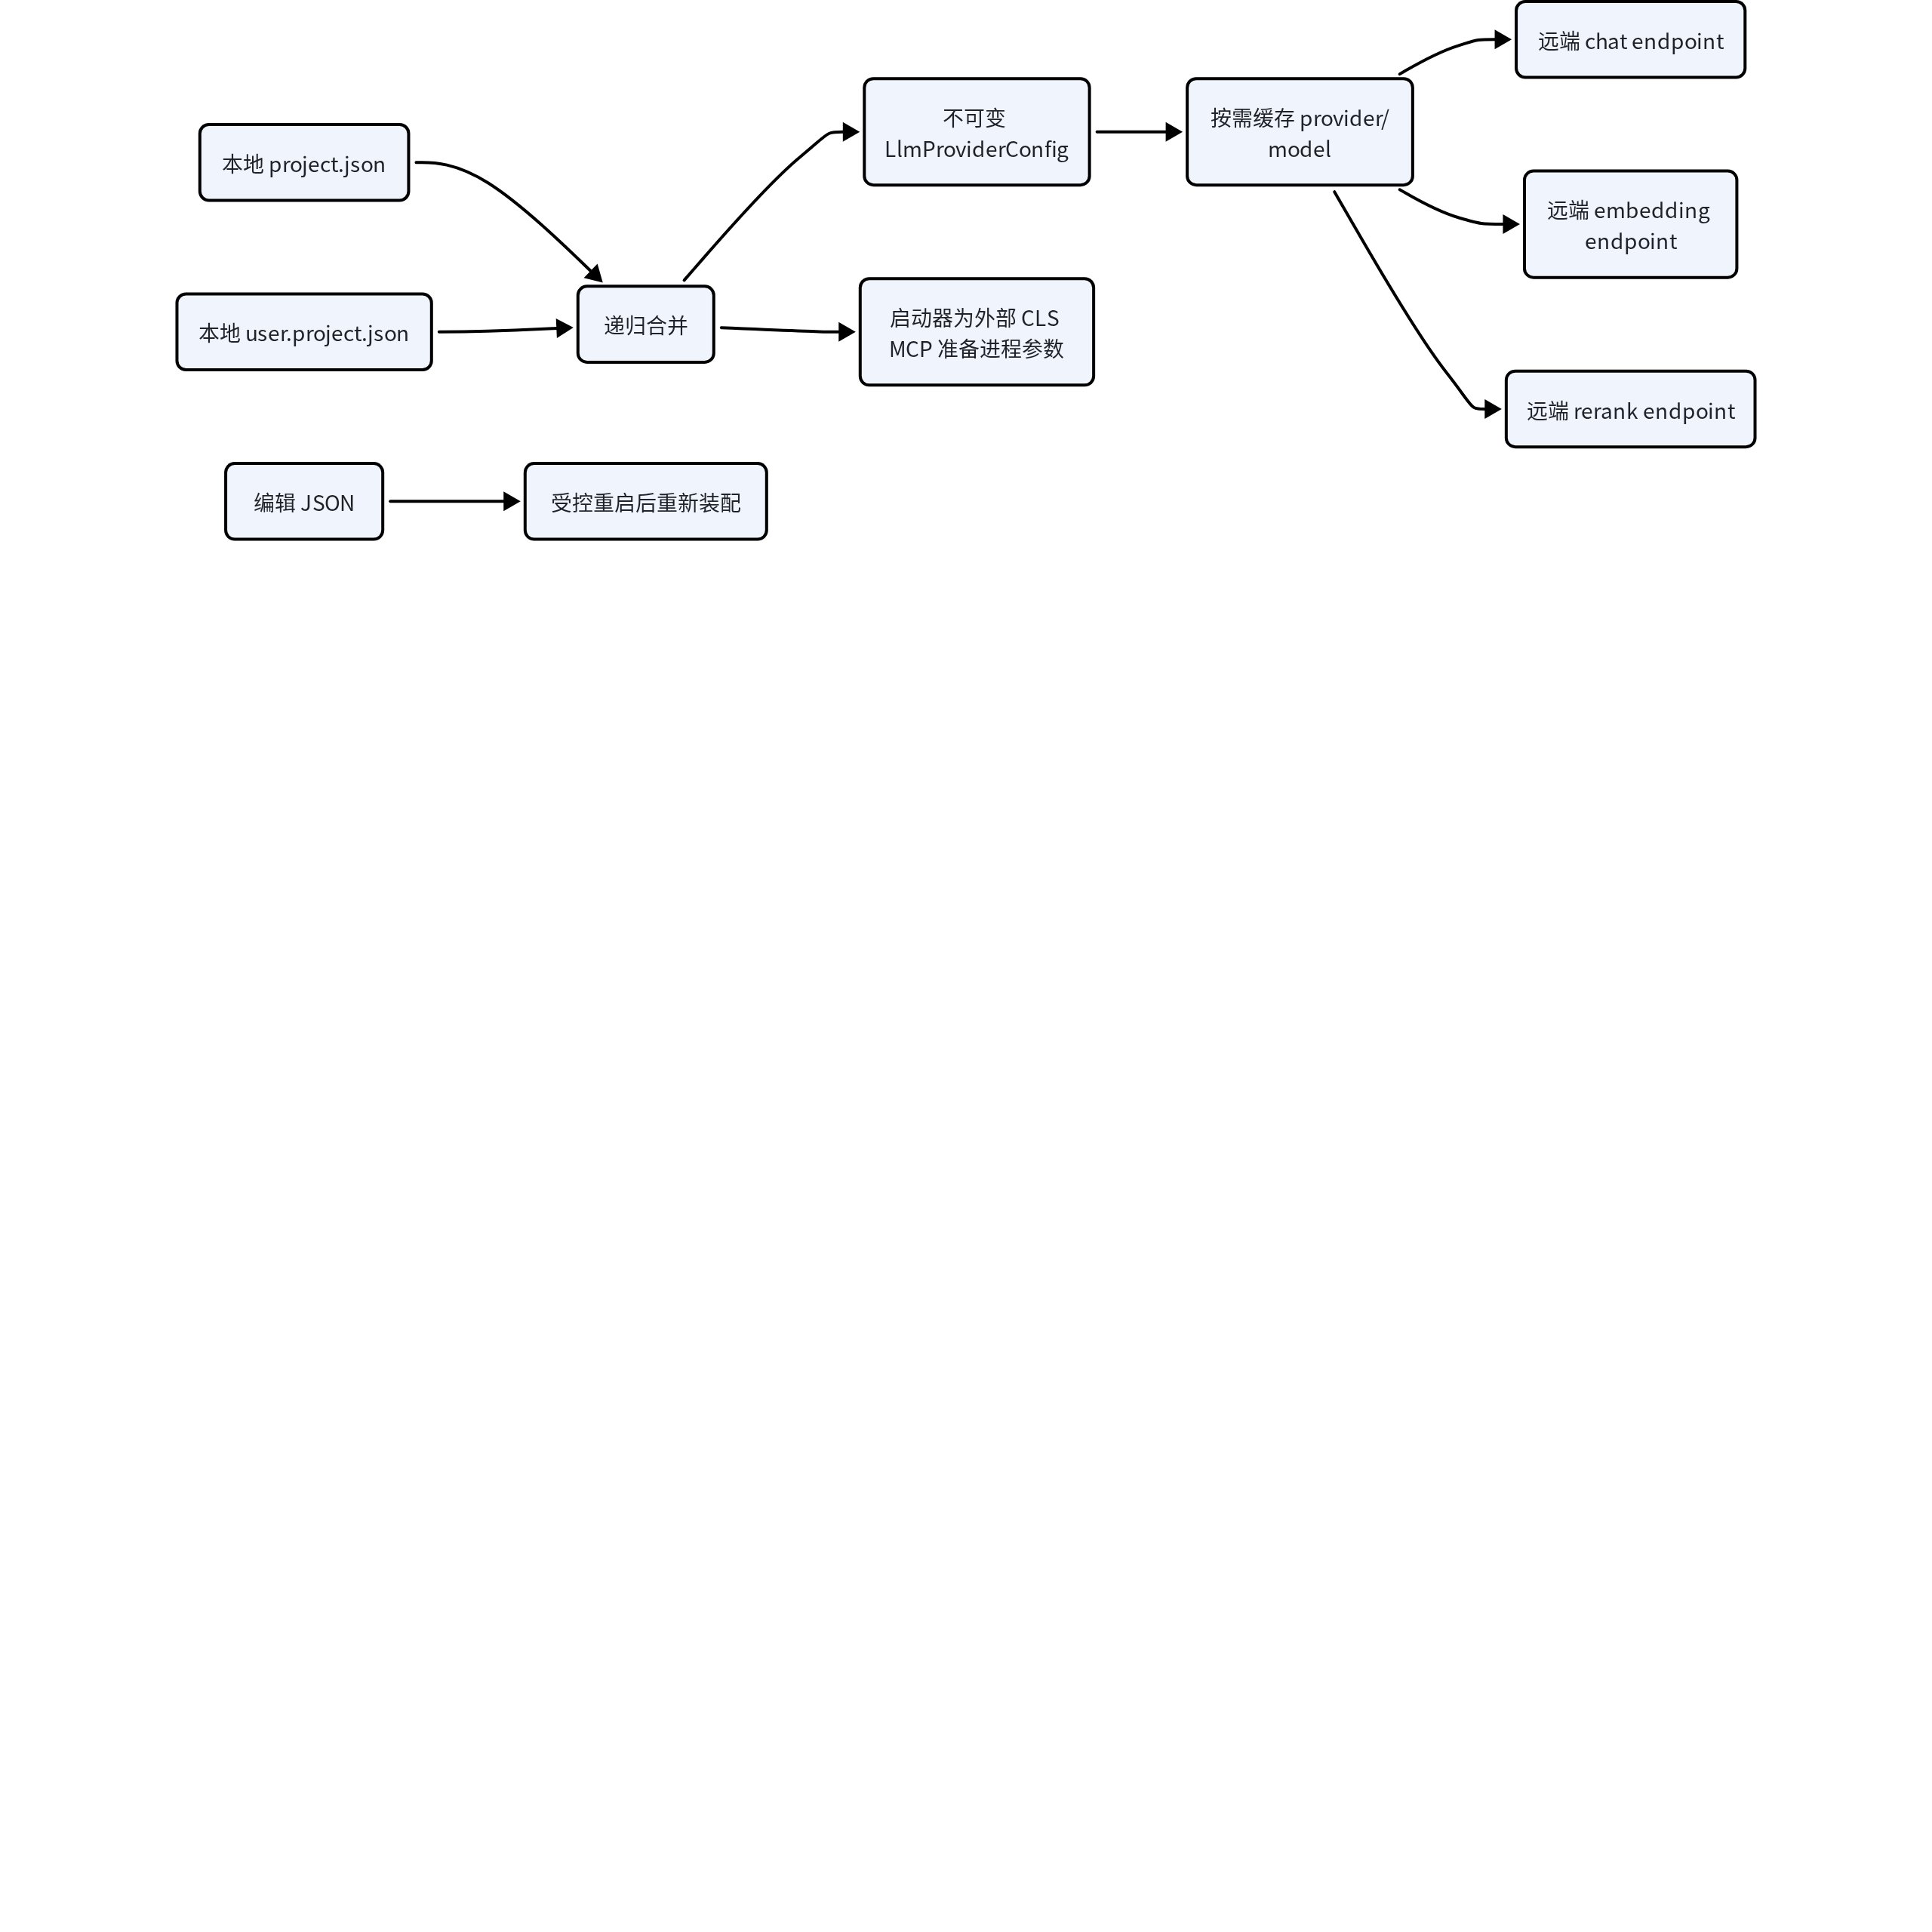
本地文件负责明确来源和版本控制隔离,远端服务负责实际模型能力,两者之间没有热更新保证。拥有本机文件权限的人仍可读取 secret;配置轮换后还需重启、重新 readiness,并妥善处理正在运行的 durable job。
📷 [图片 token=WoVdblJvIocHS9xuWQ2cbmtfnQf(未能下载,见飞书原文)]
数据、契约与状态
LlmProviderConfig 是不可变 dataclass,字段覆盖 provider、api key、base URL、三个模型、embedding 维度、rerank endpoint、上下文窗口、温度、超时和重试。api key 的 repr=False 只是降低误输出风险,不意味着可以记录整个配置映射;原始 JSON 同样不得进入日志或 HTTP。
📷 [图片 token=OQZJbFB1noca6UxZaWIcLcXanzb(未能下载,见飞书原文)]
三类模型能力承担不同数据语义:ChatModel 输入对话或提示并输出消息;EmbeddingModel 输入有序文本列表并输出同序向量;RerankModel 输入 query 与候选正文,输出引用候选下标的相关性。它们共享一个 provider 配置,但不能互换。Milvus 只保存 embedding 结果和知识 chunk,不保存聊天响应或 rerank 调用记录。
📷 [图片 token=Qsa8bYSePouXRkxoE3LccnHzn5b(未能下载,见飞书原文)]
当前聊天 model capability 的 contextWindowTokens 被聊天记忆服务用于上下文占用计算和压缩策略。它来自用户配置中的 modelCapabilities,且必须与当前 chatModel 匹配。这个字段描述模型能力边界,不是某次请求已经消耗的 token 数;会话自己的 context_tokens 持久化在 SQLite。
📷 [图片 token=T3PGb6WtmoB8t7xeDR0cIm6rnuf(未能下载,见飞书原文)]
权限、安全与失败边界
本地 JSON 文件虽然被忽略,仍是明文敏感文件,应依赖操作系统文件权限和工作目录安全。不要把它们粘贴进 issue、日志、截图或测试 fixture。.gitignore 只能阻止正常未跟踪添加,不能清除已经进入 Git 历史的秘密,因此密钥一旦泄露仍需轮换。
📷 [图片 token=KLfIbADSJo7tsJx044UcpxCGnBh(未能下载,见飞书原文)]
日志、/ready 和 /config/check 只允许 provider、model、base URL、延迟和安全错误。API key 不应进入 LlmReadinessResult,rerank 的 Authorization header 与上游响应正文不进入 LlmRerankError。业务层也不得捕获外部异常后直接串行化到 SSE。
📷 [图片 token=Q2BZbeh34o0GtexHLRWcEqp4nMF(未能下载,见飞书原文)]
外部模型不可用时必须如实失败:聊天流发送结构化 error 且不保存部分 assistant 消息;embedding 失败使索引任务和文档索引状态变为 failed,可手动重试;rerank 失败不能伪造分数。配置缺字段或 capability 不匹配时应在构建 provider 阶段报配置错误,而不是切换到未声明的模型或环境变量。
📷 [图片 token=EGKzb0mHpomAZhxwXdvcIJ2KnqG(未能下载,见飞书原文)]
阅读顺序与小结
先读
apps/backend/src/super_ai/project_config.py,准确理解路径选择和深度合并。再读
apps/backend/src/super_ai/llm/config.py,列出从 JSON 到类型化配置的所有必需字段。阅读
apps/backend/src/super_ai/llm/provider.py,区分聊天、embedding、rerank 工厂和 readiness。深入
apps/backend/src/super_ai/llm/rerank.py与apps/backend/src/super_ai/documents/indexing.py,核对外部响应验证和失败状态。最后沿 provider、readiness 与大文档索引调用链,确认外部访问时机和脱敏边界。
Qwen 接入的工程价值在于“可替换且可失败”:业务依赖协议,具体客户端集中创建;配置来源单一可解释,密钥不进入公共状态;embedding 和 rerank 对供应商限制与不可信响应做显式处理。模型能力越强,越需要这种窄而清晰的 provider 边界来保证权限、恢复和可观测性仍由应用掌控。
📷 [图片 token=W5VqbEY10oCYOAxCCSjcD6donVc(未能下载,见飞书原文)]