OncallAgent 是一个本地优先的 AIOps Agent 工作台。它把 Vue 3 工作区、FastAPI API 与 Agent 运行时、SQLite 持久化、Milvus 知识向量、Qwen 模型能力和外部 MCP 工具放进一条可在开发者机器上运行的链路。这里的“本地优先”不是“所有计算都离线”:应用进程和主要状态边界位于本机,但模型服务、CLS MCP 所连接的日志服务仍可能是远端依赖。理解这一点,才能正确解释 readiness 降级、网络失败和凭据配置。
📷 [图片 token=DFZOb06q2oyLklxYCaOc5Fotnef(未能下载,见飞书原文)]
从 AI Native 角度看,这套代码最值得学习的不是某一个模型调用,而是模型如何被约束在工程边界内:HTTP 与 SSE 有共享契约,身份经过统一依赖解析,业务记录通过 Repository 持久化,知识检索必须带 tenant 范围,工具调用与诊断结论可以落到审计和证据链。Agent 只是调用链中的一个执行者,不是绕过权限、存储和错误处理的特殊通道。
📷 [图片 token=SXLfbdkb6ofAAJx2SWicTsF2nPg(未能下载,见飞书原文)]
源码阅读应同时沿“控制面”和“运行面”展开。OpenSpec 主规格描述已经生效的行为,packages/api-contracts 固化跨语言协议;运行时则从前端路由进入 FastAPI,再进入服务、Repository、模型或外部工具。单独阅读任意一层都容易产生误判,例如看到 Milvus collection 并不代表所有业务数据都在那里,看到模型 provider 也不代表启动时必然发起网络连接。
📷 [图片 token=QxuRbBEQnoIQAVx45Lac9qKAnKk(未能下载,见飞书原文)]
学习目标
📷 [图片 token=Qq15b0z3HoGrDUxqGWvcKYh4nfc(未能下载,见飞书原文)]
识别浏览器、API、Agent、SQLite、Milvus、Qwen、MCP 与本地容器基础设施的职责边界。
能从一个用户操作追踪到共享契约、后端路由、服务、持久化与外部依赖。
理解为什么 owner scope、统一错误、显式连接和 durable job 是 AI Native 系统的基础设施,而不是附加功能。
能区分当前实现、主规格约束和外部依赖可用性,避免把设计意图误写成运行结果。
功能入口与完整调用链
📷 [图片 token=Kck6bosHloOw3rxR1klcFvvVnNe(未能下载,见飞书原文)]
桌面入口由 apps/frontend/src/router/index.ts 定义。公开路由是 /login 与 /register,工作区中的 /chat、/knowledge、/aiops 和 /mcp 都标记为需要认证。全局导航守卫先调用认证状态初始化;没有当前用户时跳转登录页,已认证用户访问公开认证页时回到对话页。这里的前端守卫改善交互,但真正的安全边界仍在后端,因为浏览器路由不能阻止直接构造 HTTP 请求。
📷 [图片 token=WYxHbWf81oHLzrxsYuWcQLnjnfb(未能下载,见飞书原文)]
后端装配集中在 apps/backend/src/super_ai/api/app.py 的 create_app。它创建 FastAPI,配置 CORS、请求观测中间件、统一异常处理器,装配 AuthService、SQLite repositories、Milvus vector store 和 durable background job runtime。应用 lifespan 启动、停止后台任务 runtime,并在退出时释放自己创建的 SQLAlchemy engine。模块导入阶段不会连接 Milvus 或调用模型;这些外部动作由具体请求、readiness 或任务执行显式触发。
📷 [图片 token=PnwPbpAx3oG9JzxZ8TfcMzotnFb(未能下载,见飞书原文)]
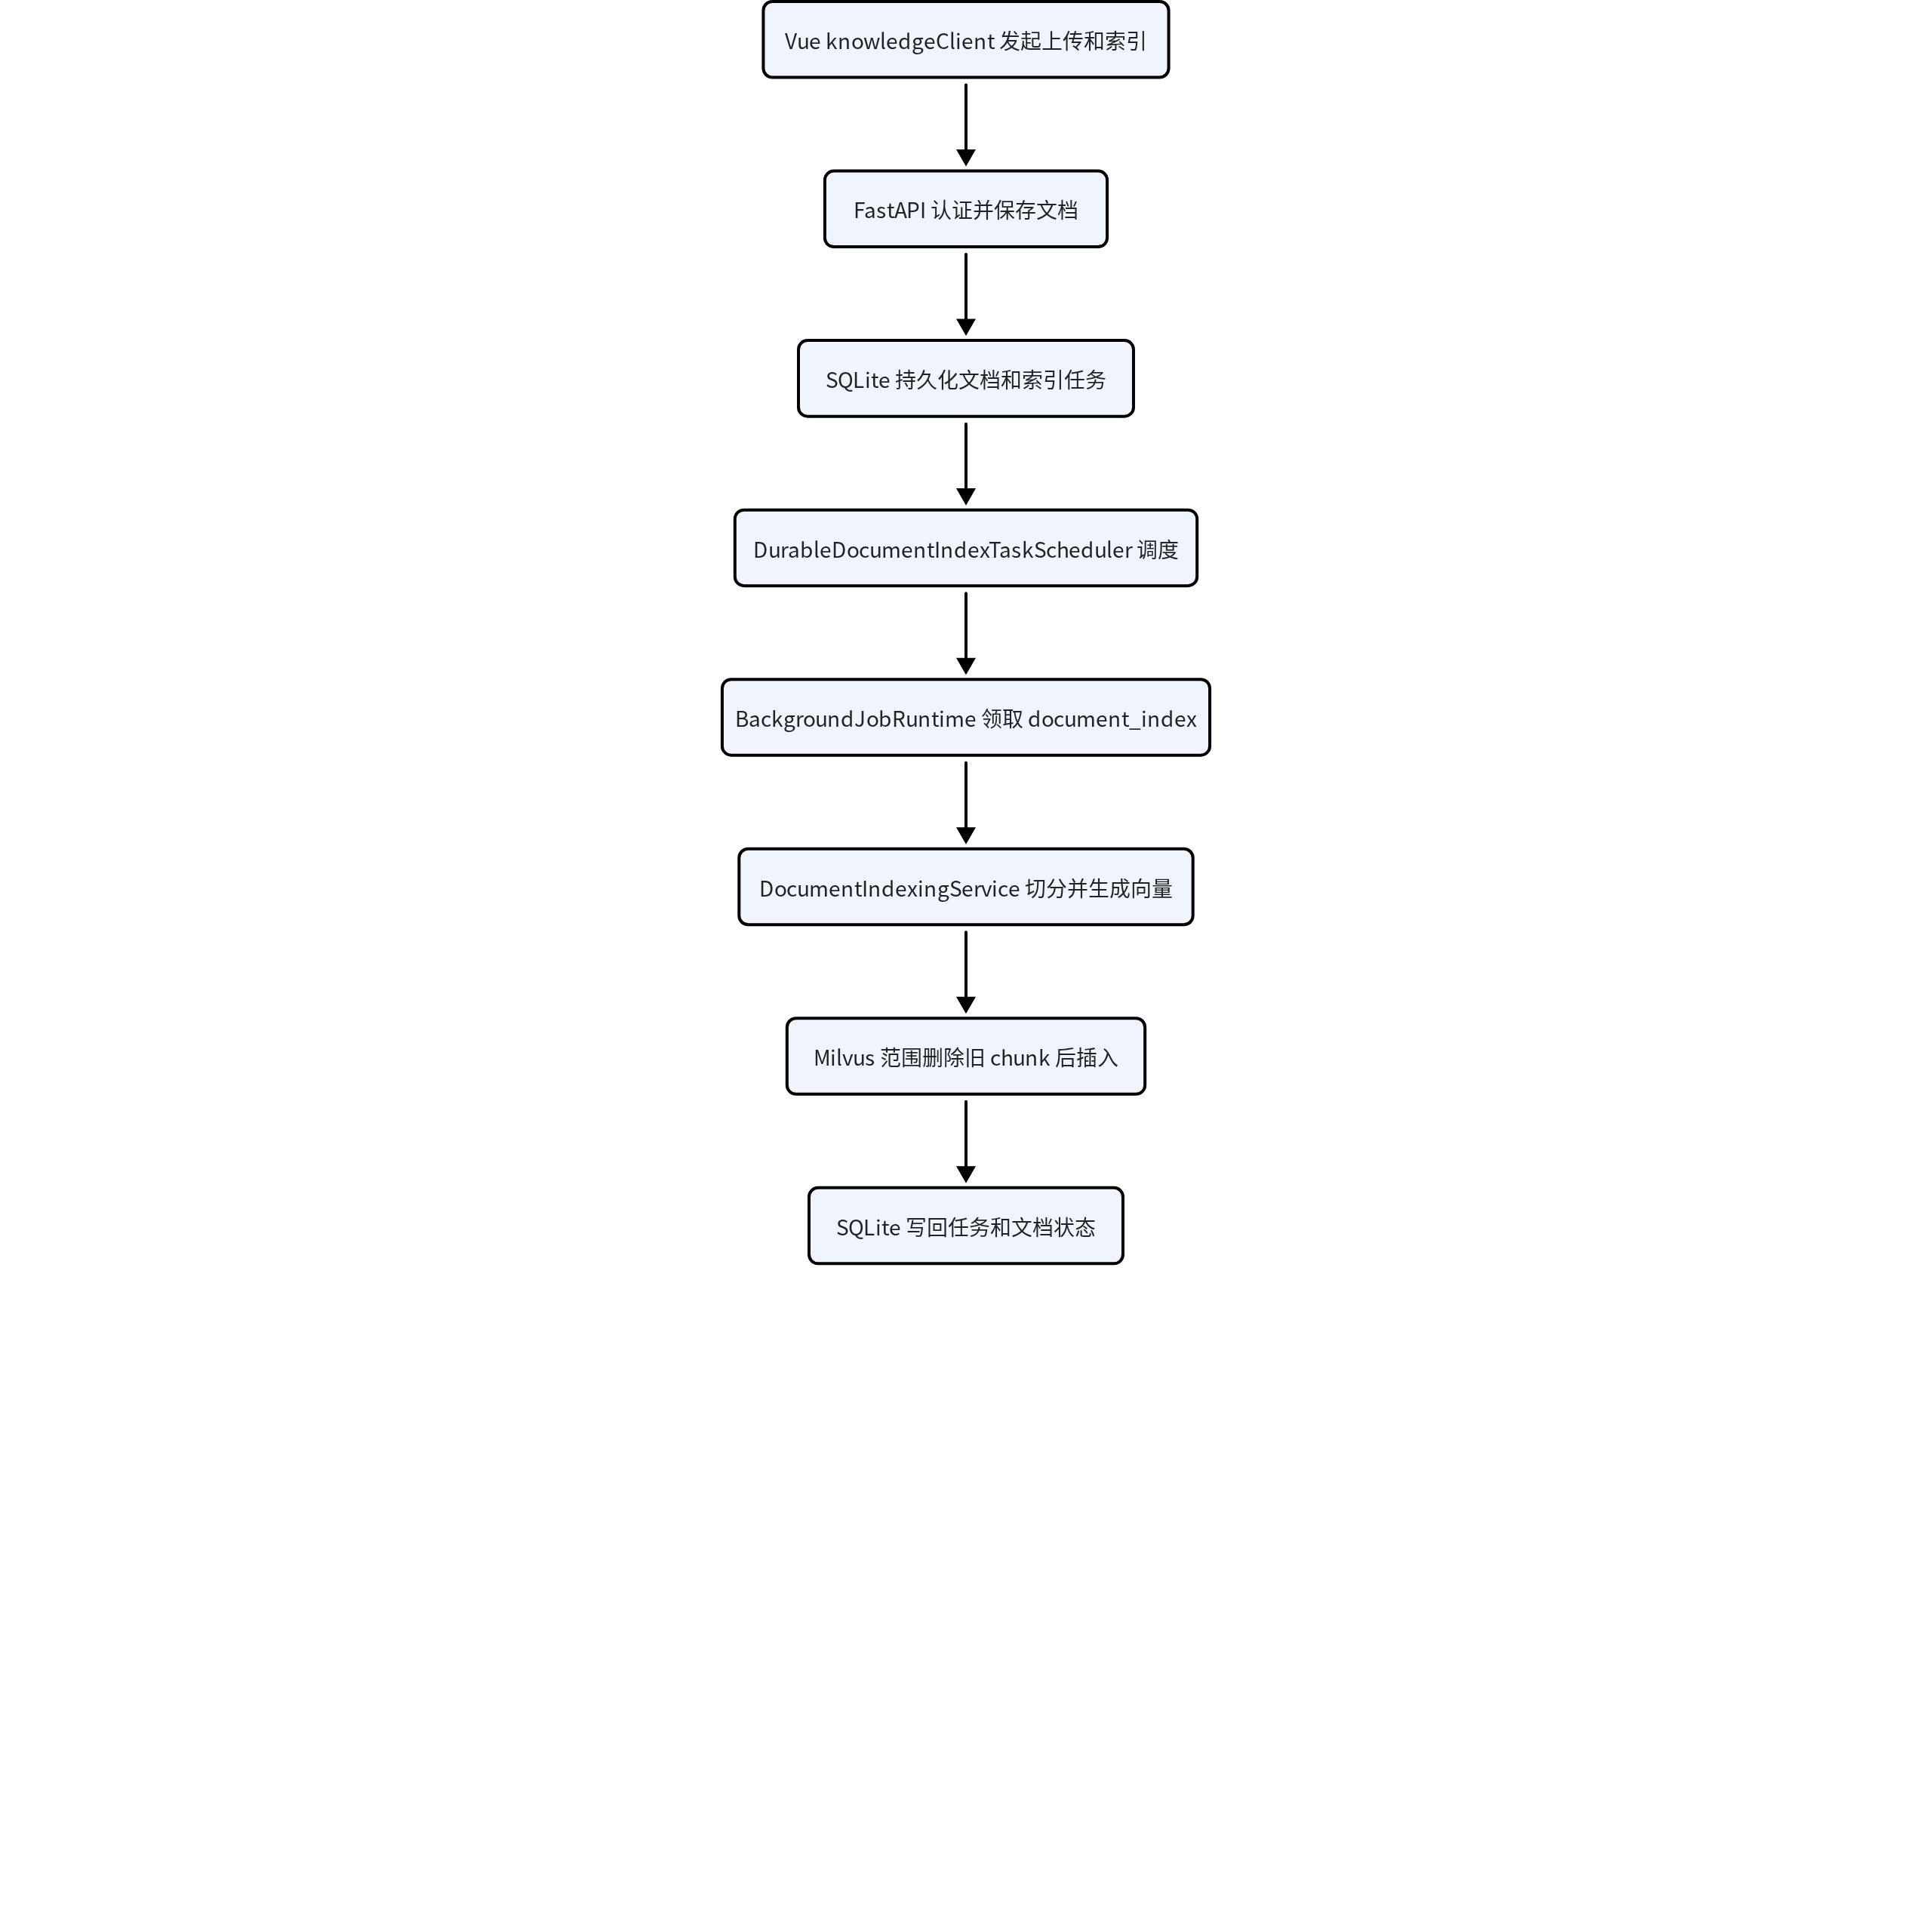
以“上传知识文档并索引”为例,完整链路如下:
📷 [图片 token=Ugixb1WKQoRgPcxzgJCcnODVnMb(未能下载,见飞书原文)]
apps/frontend/src/knowledge/knowledgeClient.ts通过带 bearer token 的请求上传 Markdown 或 PDF。create_app中的upload_knowledge_document先由_current_user解析身份,再校验个人知识库 ID、文件策略、抽取文本、计算 SHA-256,并通过 owner-scoped document repository 保存元数据。create_document_index_task创建业务索引任务,再由DurableDocumentIndexTaskScheduler进入BackgroundJobRuntime;API 以 202 返回,而不是等待嵌入和写向量完成。apps/backend/src/super_ai/documents/indexing.py的DocumentIndexingService.run_task按文档持久化的切分策略生成 chunk,调用EmbeddingModel.aembed_documents,显式初始化 Milvus,按 tenant、知识库和文档范围删除旧 chunk,再批量插入新向量。apps/backend/src/super_ai/vector_store/milvus.py把 owner 与 tenant 字段展开为标量和 metadata;任务最终状态与文档索引状态仍写回 SQLite。
对话链路体现另一类 AI Native 组合。POST /chat/sessions/{session_id}/messages:stream 先用当前用户 ID 查询会话;找不到同 owner 的会话就返回统一 403,不会启动 Agent。通过后,ChatStreamingService 先持久化用户消息,再让 LangChainChatAgentRunner 使用 provider 提供的聊天模型和可用工具。模型可自行选择知识检索、时间或已启用 MCP 工具,过程转成共享 SSE 事件;只有完整回答成功后才保存 assistant 消息。普通聊天没有自定义诊断状态图,而 AIOps 诊断由 apps/backend/src/super_ai/aiops/diagnostics.py 的图运行时承担 Planner、Executor、Replanner 与 Report 阶段,两者不应混为一谈。
Vue 路由与 Store
  → 共享 HTTP / SSE 客户端
  → FastAPI create_app 路由与认证依赖
  → 领域服务 / Agent runner / durable job
  → SQLite Repository
  → Milvus、Qwen、MCP、Alertmanager 等显式外部边界
📷 [图片 token=Kuw9b9MeboptOFxYGnVcQsuGn1b(未能下载,见飞书原文)]
核心源码地图
📷 [图片 token=HgXxb3JKqox0lNxhqEMccKGunrh(未能下载,见飞书原文)]
| 源码位置 | 关键符号 | 职责 |
|---|---|---|
apps/frontend/src/router/index.ts | createAppRouter | 定义公开页、受保护工作区路由和认证导航守卫。 |
apps/frontend/src/api/apiClient.ts | createApiClient、ApiClientError | 注入 bearer token,解析统一 HTTP envelope,并把错误转换为类型化异常。 |
apps/frontend/src/api/sseClient.ts | createSseClient | 读取 event stream、拼接跨 chunk 帧并验证共享 SSE 基础字段。 |
apps/backend/src/super_ai/api/app.py | create_app、_current_user | 后端组合根:路由、依赖注入、异常、中间件、readiness 和后台任务装配。 |
apps/backend/src/super_ai/memory/repositories.py | MemoryRepositories、TenantScopeError | 定义聊天、文档、诊断、审计、后台任务等业务持久化协议。 |
apps/backend/src/super_ai/memory/sqlite.py | create_sqlite_memory_repositories | 用 SQLAlchemy 实现 owner-scoped Repository 查询与状态变更。 |
apps/backend/src/super_ai/jobs/runtime.py | BackgroundJobRuntime | 执行持久后台任务,支持领取、租约、心跳、重试、超时与取消。 |
apps/backend/src/super_ai/chat/streaming.py | ChatStreamingService、LangChainChatAgentRunner | 组装聊天 Agent,转换事件,持久化消息与工具审计。 |
apps/backend/src/super_ai/vector_store/milvus.py | MilvusConnectionManager、MilvusVectorStore | 显式管理 Milvus 连接、collection、索引、范围查询与文档级删除。 |
packages/api-contracts/src/index.ts | FOUNDATION_HEALTH_CONTRACT 及模块导出 | 共享 HTTP、错误、OpenAPI、SSE、认证、文档、检索等类型入口。 |
infra/compose.yaml | etcd、minio、milvus、attu、alertmanager | 只托管本地容器基础设施,不运行前端、后端或 CLS MCP Server。 |
代码调用流程图
📷 [图片 token=Vb3IbuXqno7rurxttP1cF5zAnHd(未能下载,见飞书原文)]
下面这张图把页面动作、HTTP 路由、SQLite 任务、后台运行时和 Milvus 写入串成一条真实调用链。阅读源码时可以沿箭头逐层进入,而不是只在目录之间来回跳转。
📷 [图片 token=S7iFb6IY6o3JV2xitPYcFsi7nZd(未能下载,见飞书原文)]
关键实现拆解
📷 [图片 token=TFhxbCjkjobLM5xblcrcUgdYn7d(未能下载,见飞书原文)]
组合根与惰性外部资源
📷 [图片 token=Rkf6boq99o8fG5xIpUxcCVSanxe(未能下载,见飞书原文)]
create_app 接受 session_factory、vector_store、embedding_model、llm_provider、Agent runner 等可替换参数,这是测试无需真实网络的关键。默认向量存储由 build_default_milvus_vector_store 创建,但该函数只加载设置并创建对象;真正客户端由 MilvusConnectionManager.connect 在首次显式操作时构造。默认 LLM provider 也通过 _llm_provider 按需构建。这样的依赖边界使模块可导入、路由可测试,也使 readiness 能逐项报告故障。
📷 [图片 token=QQeZbQQbfowL7Hxu9j1cLaQHnHc(未能下载,见飞书原文)]
请求中间件为每个请求建立 request ID,记录方法、路径、状态和耗时。apps/backend/src/super_ai/observability.py 的 emit_event 会调用 _redact 清理敏感键;日志调用点只记录任务 ID、文档 ID、状态、耗时与异常类别,而不应记录用户消息、工具参数正文或文档正文。观测性在这里是边界检查的一部分,因为 Agent 系统最容易从“方便调试”的原始 payload 中泄露敏感数据。
📷 [图片 token=Fn5Vbmv3soS3oex3zAEcNMh9n8f(未能下载,见飞书原文)]
看什么:先看 create_app 的参数和 lifespan,确认哪些依赖可以注入,以及真正会在应用生命周期中启动和停止的对象。
📷 [图片 token=Uyn4bjvh7oO19Ux8c1Icqf8RnJV(未能下载,见飞书原文)]
def create_app(
    *,
    database_url: str | None = None,
    project_config_path: str | Path | None = None,
    session_factory: async_sessionmaker[AsyncSession] | None = None,
    vector_store: MilvusHealthCheckProvider | None = None,
    embedding_model: EmbeddingModel | None = None,
    rerank_model: RerankModel | None = None,
    llm_provider: LlmProvider | None = None,
    chat_agent_runner: ChatAgentRunner | None = None,
    aiops_diagnostic_runner: AiopsDiagnosticRunner | None = None,
    alert_provider: ActiveAlertProvider | None = None,
    index_task_scheduler: DocumentIndexTaskScheduler | None = None,
) -> FastAPI:
    # 1. 组合根接收协议对象,测试可替换网络与存储边界。
    # … 省略与本节无关的配置路径解析
    @asynccontextmanager
    async def lifespan(application: FastAPI) -> AsyncGenerator[None, None]:
        runtime = cast(BackgroundJobRuntime, application.state.background_job_runtime)
        # 2. 生命周期只显式管理 durable runtime 与自有数据库 engine。
        await runtime.start()
        try:
            yield
        finally:
            await runtime.stop()
📷 [图片 token=Yy7mbjwSHoiw3JxGz0qcuk6Anyd(未能下载,见飞书原文)]
这段代码证明“创建应用”和“访问外部依赖”是两个动作:注入项可在测试中替换,lifespan 负责后台 worker,而 Milvus、LLM 和 MCP 仍由各自的显式调用触发。失败边界也因此可分离:装配失败、后台 runtime 失败、readiness 失败和一次业务调用失败不是同一个状态。
📷 [图片 token=U40pbVNucof1dwxayCMcCqlnnNf(未能下载,见飞书原文)]
看什么:再用局部图观察默认对象从“已装配”到“首次使用”的变化,避免把 Python import 或 FastAPI 构造误读为已经联网。
📷 [图片 token=CvAubZyHpoGoB8xerGncbN7Jnvh(未能下载,见飞书原文)]
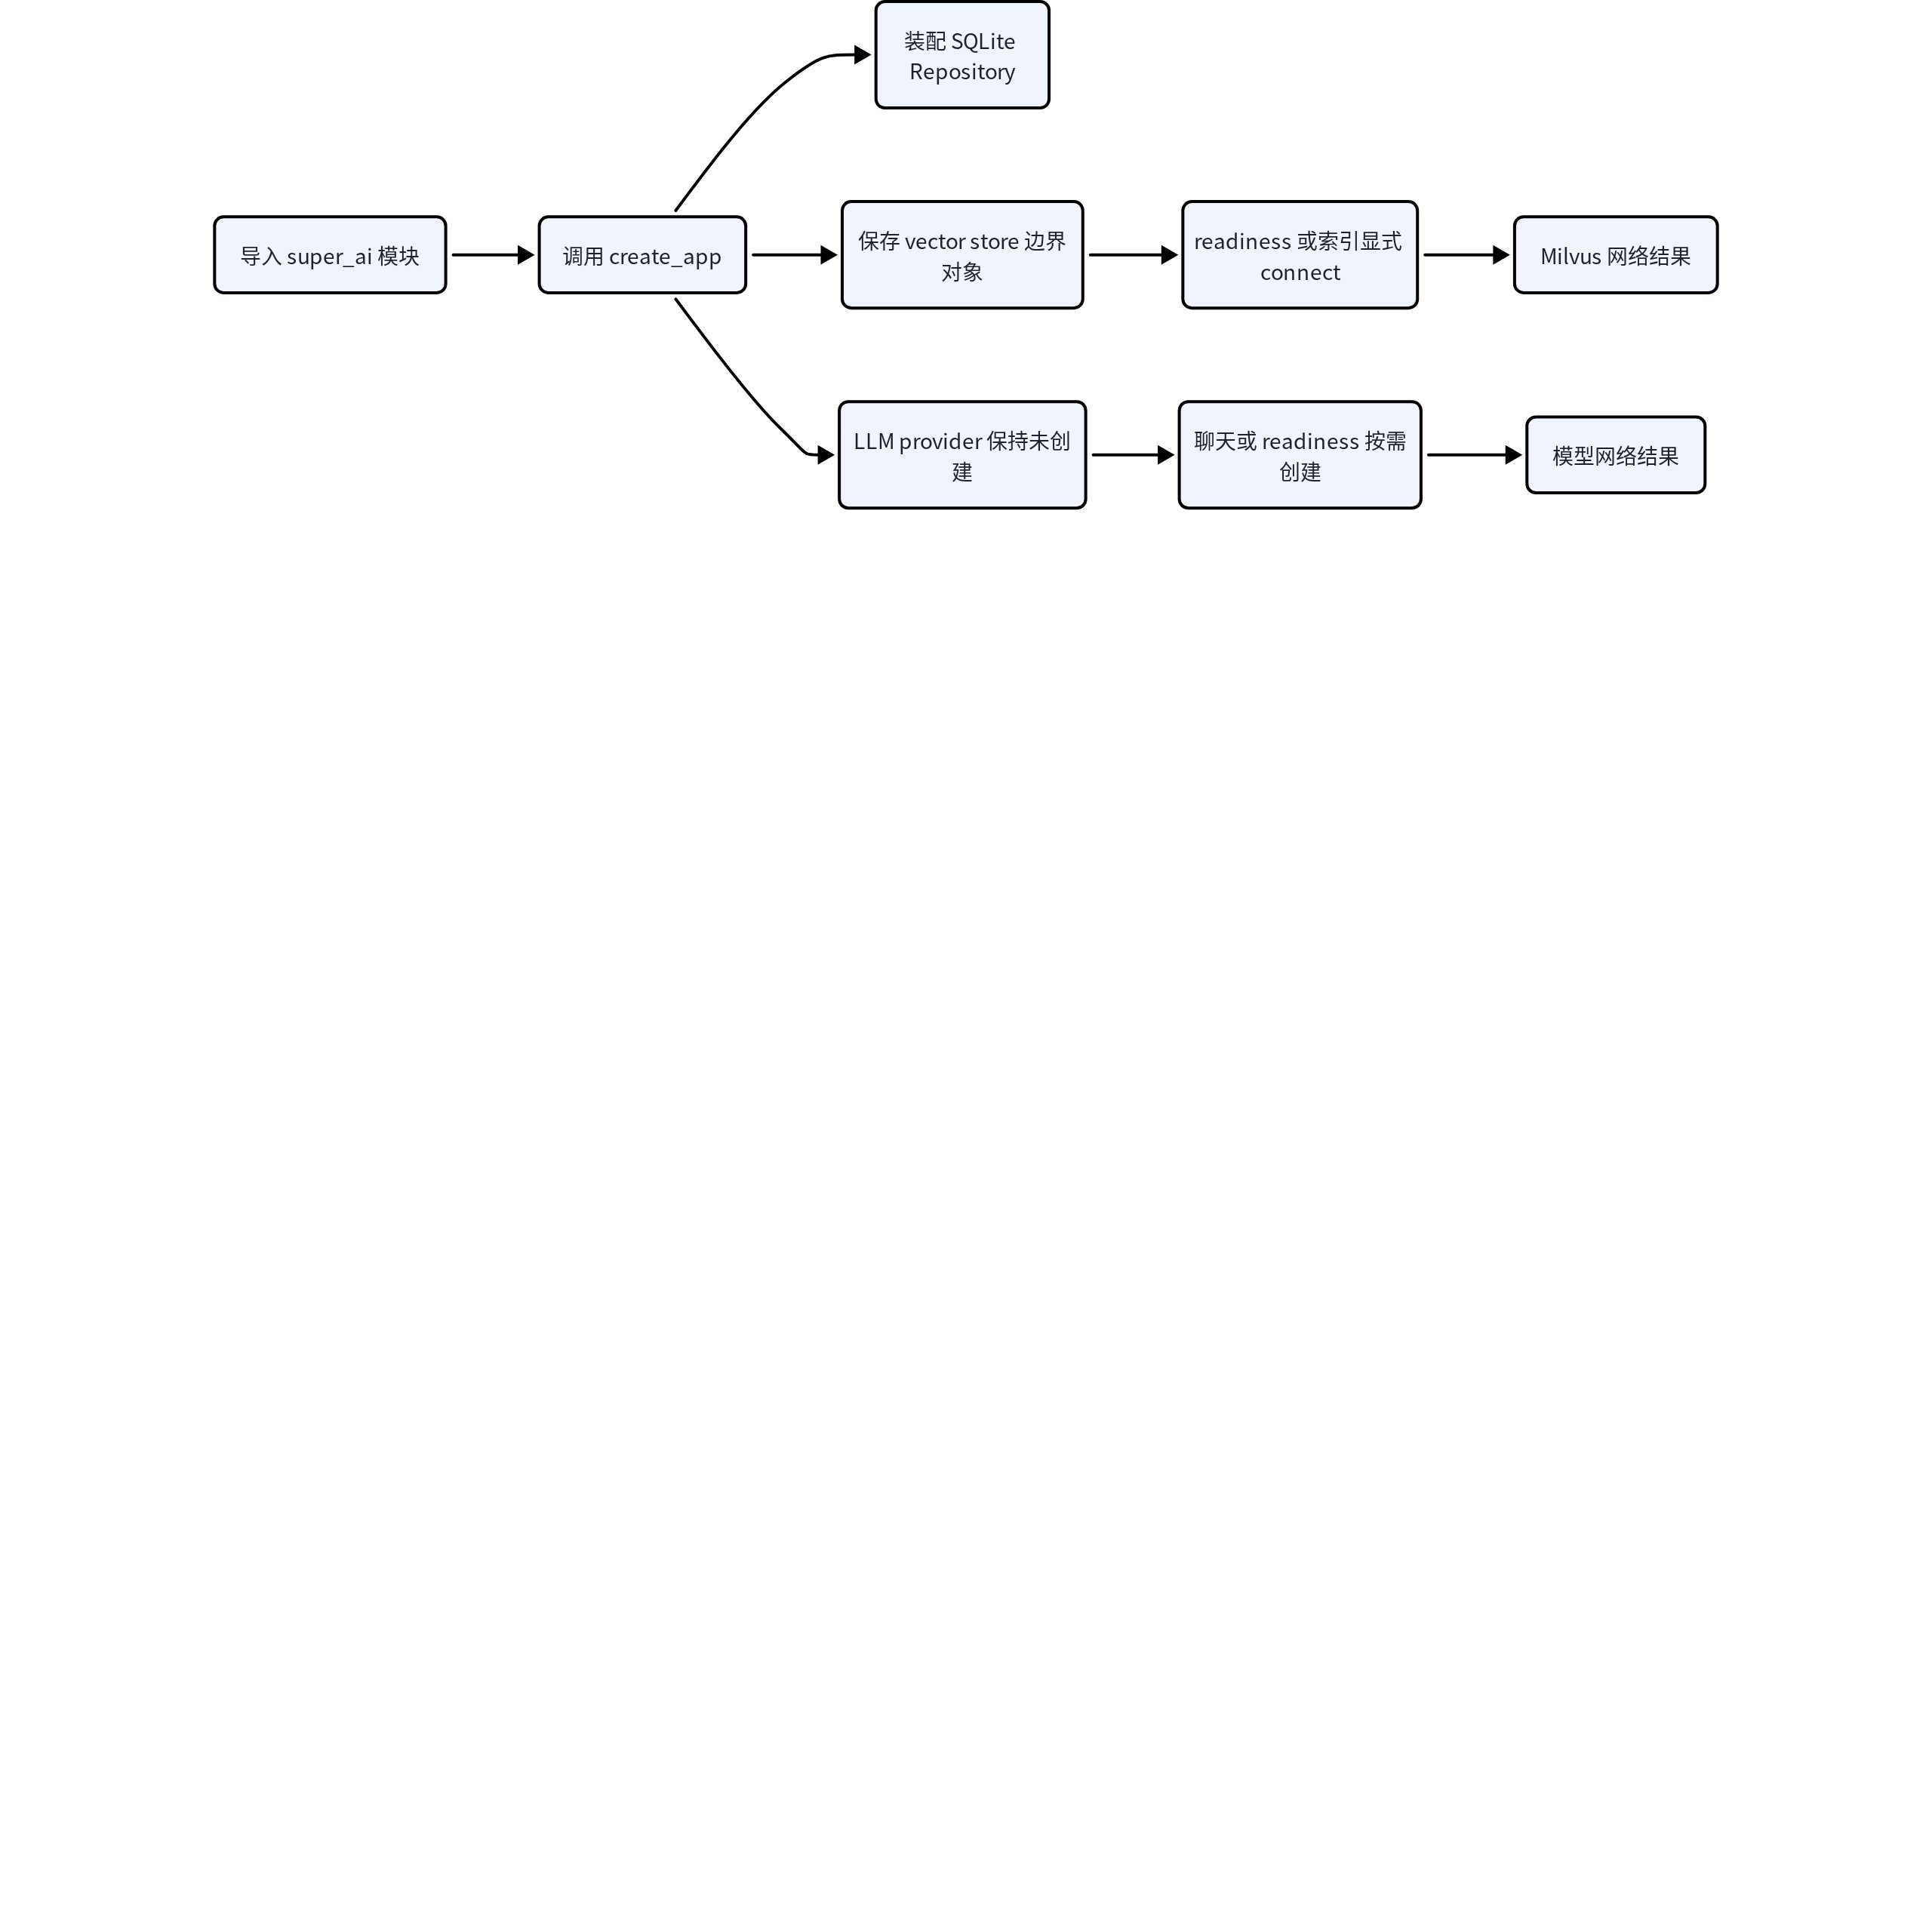
图中只有最后两条分支会产生外部网络结果;任何分支失败都应落入对应的安全诊断或业务错误,而不是让模块导入产生不可控副作用。SQLite engine 则由组合根明确区分“自己创建”和“调用者注入”,退出时只释放前者。
📷 [图片 token=YpPfbTcjgoSLUBxqyKWcdnW3nsc(未能下载,见飞书原文)]
状态分层:SQLite 是业务主存储,Milvus 是知识向量专用存储
📷 [图片 token=Na2NblSOtoPL5lxc9LhcfA5Rntc(未能下载,见飞书原文)]
apps/backend/src/super_ai/memory/models.py 定义用户、会话、消息、知识文档、索引任务、诊断任务、证据、报告、工具审计和后台任务等 ORM 模型。它们由 Alembic 管理模式并通过 Repository 访问。Milvus collection 则只包含知识文档 chunk 的内容、向量、来源、时间与权限标量;用户账户、聊天消息或诊断报告不会因为“AI 系统”而被塞入向量库。
📷 [图片 token=PQELbjyJ3oR6uCxZiYYc397dnIf(未能下载,见飞书原文)]
这一分层还有恢复语义:上传文档后,SQLite 先持久化文档和索引任务;durable job 可以在进程重启后重新领取。Milvus 写入成功后才把文档置为 indexed、任务置为 succeeded。如果嵌入或 Milvus 失败,任务和文档都进入失败状态,用户可以显式重试。当前实现不是跨 SQLite 与 Milvus 的分布式事务,因此重建前使用文档范围删除并以确定性 chunk ID 重新插入,降低重复与残留风险。
📷 [图片 token=UHwLbBpLIoeE3tx6wEVcolRhnQO(未能下载,见飞书原文)]
📷 [图片 token=UbbMbSOo2ox9lCx7lincQcMOnoe(未能下载,见飞书原文)]
看什么:索引核心先完成确定性切分和向量数量校验,再触碰 Milvus;删除条件同时包含 tenant、知识库与文档。
📷 [图片 token=B4skbOf0JoKRPBx4XZOccH8snmc(未能下载,见飞书原文)]
            # 1. 使用文档持久化的策略生成可复现 chunks。
            chunks = chunk_document_text(
                _indexable_text(document),
                strategy=strategy,
                chunk_size=chunk_size,
                chunk_overlap=chunk_overlap,
            )
            if not chunks:
                raise DocumentIndexingError("Document has no indexable text.")
            # 2. 向量数量必须与 chunk 数量完全一致。
            vectors = await self._embedding_model.aembed_documents(
                [chunk.content for chunk in chunks]
            )
            if len(vectors) != len(chunks):
                raise DocumentIndexingError(
                    "Embedding provider returned an unexpected vector count."
                )
            # 3. 重建只删除当前 tenant、知识库和文档范围。
            self._vector_store.initialize()
            self._vector_store.delete_document_chunks(
                tenant_id=owner_user_id,
                knowledge_base_id=document.knowledge_base_id,
                document_id=document.id,
            )
📷 [图片 token=HDb7b2UmEoRNLxxgSTGcjzxxn4b(未能下载,见飞书原文)]
片段证明 Milvus 内容是从 SQLite 文档事实派生出来的可重建索引,而不是反向决定文档存在性。空文本、向量数量不符、初始化或删除失败都会进入索引任务失败路径;删除后进程终止仍可能造成短暂空索引,所以当前边界是可观察、可重试的最终一致,而非跨库原子事务。
📷 [图片 token=If0ObuthYoKX92xlyJ3cchgwn2Z(未能下载,见飞书原文)]
看什么:下面的状态图把业务任务、文档状态和外部写入放在同一条时间线上,重点看失败发生在哪一侧。
📷 [图片 token=RdbabaKAgovN7Ex1cMGc6JuNnqh(未能下载,见飞书原文)]
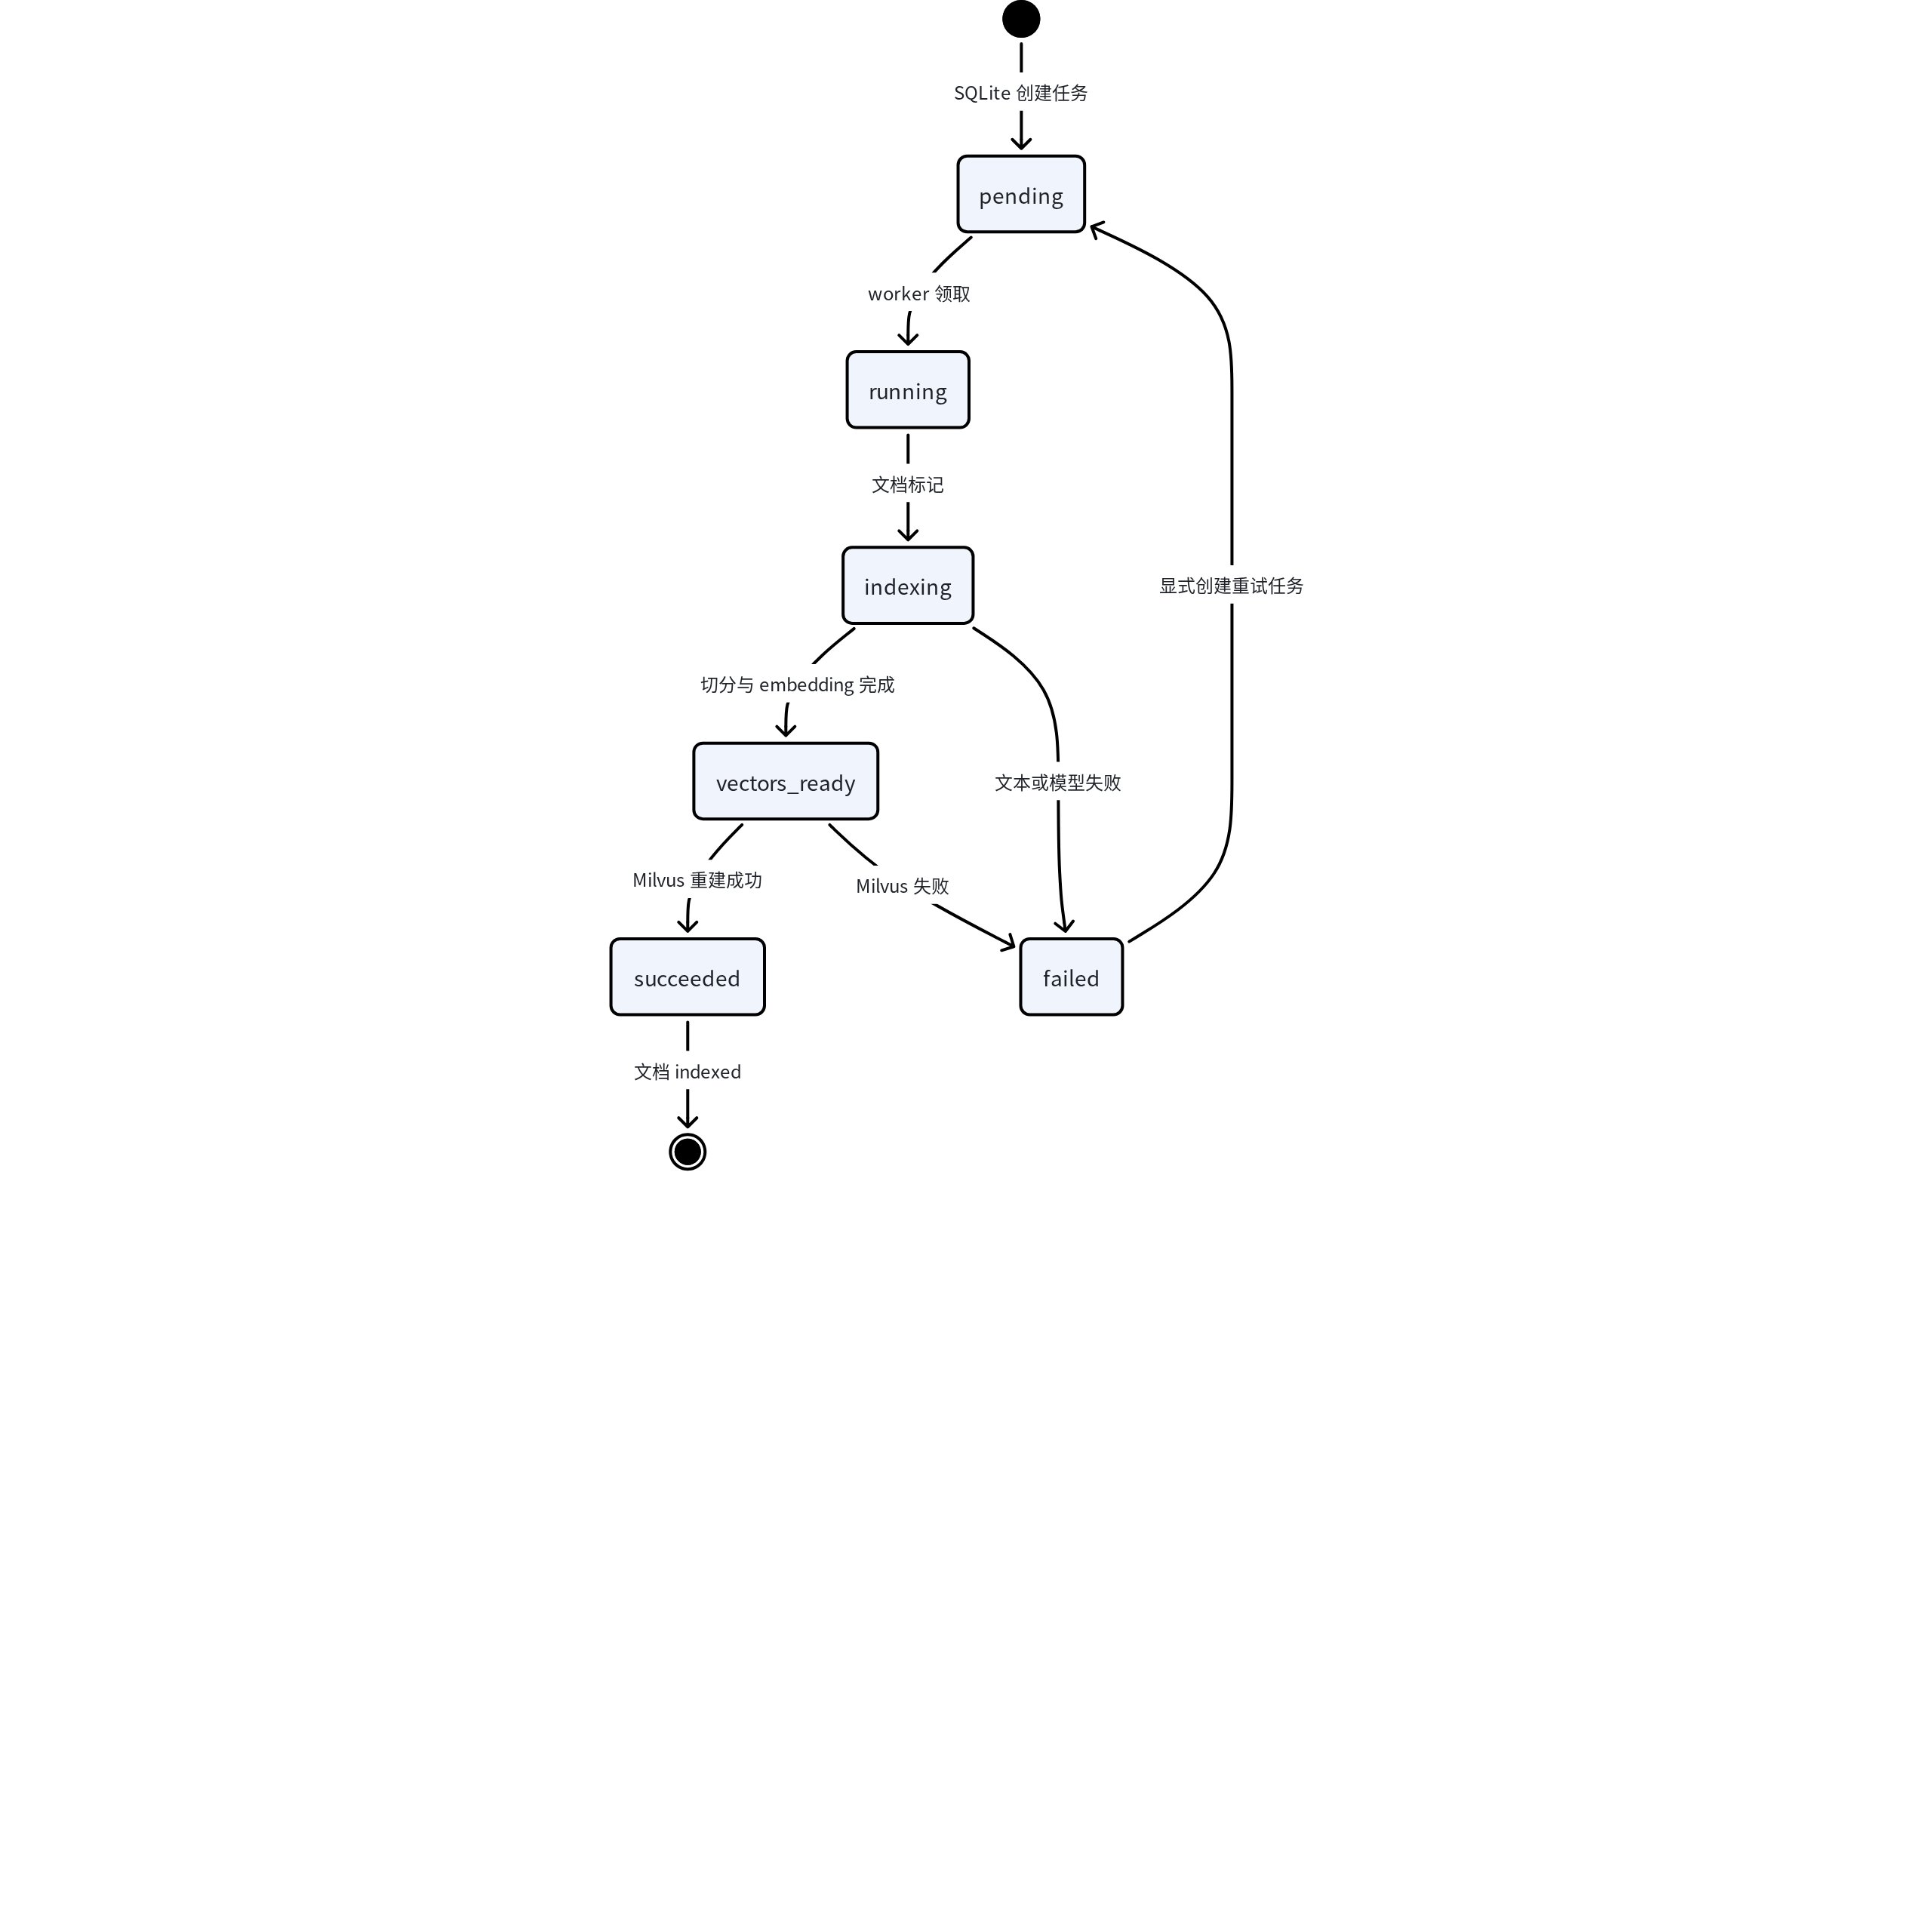
状态图没有把 retry 画成原任务回滚:当前实现会创建新的尝试并保留旧失败记录。Repository 更新若在服务 try 块之外失败,则由 durable job 记录失败,业务记录可能停留在中间态,这也是排障时要同时查看两类任务的原因。
📷 [图片 token=Hd52bUmXLofs33xoVYhcJ1EGn6b(未能下载,见飞书原文)]
两类 Agent 流程
📷 [图片 token=LqxHboIYeo5qx4xM1lyc7fzcnOz(未能下载,见飞书原文)]
聊天侧遵循“模型选择工具”的直接 Agent 模式。ChatStreamingService 负责可靠的外围生命周期:会话权限、用户消息持久化、system prompt 与 Skill 装配、工具调用审计、引用和最终消息。知识检索不是每条问题的强制前置步骤,无知识命中时也不能制造回退内容。
📷 [图片 token=UBPPbOOSBoQ18zxQz5FchTHvnHg(未能下载,见飞书原文)]
AIOps 侧需要计划、执行、重规划和证据报告,因而使用 LangGraph 诊断流程和 durable job。诊断结果要由真实工具结果、知识 SOP 与持久化证据支撑。外部 MCP、Prometheus 或 Alertmanager 不可用时,系统应如实失败或降级;当前代码没有授权以伪造日志、告警或成功执行来补齐演示。
📷 [图片 token=SfPRbo7EcoSGREx5LKocdkcCnde(未能下载,见飞书原文)]
看什么:AIOps 图的循环只发生在 replanner 之后,最终报告必须经过显式的 report 节点。
📷 [图片 token=Mf3gb5IlloxE06xW5yzczy0unBd(未能下载,见飞书原文)]
    def _build_graph(self) -> Any:
        graph = StateGraph(AiopsDiagnosticState)
        # 1. 四个节点分别承担计划、执行、重规划和报告职责。
        graph.add_node("planner", self._planner)
        graph.add_node("executor", self._executor)
        graph.add_node("replanner", self._replanner)
        graph.add_node("report", self._report)
        graph.add_edge(START, "planner")
        graph.add_edge("planner", "executor")
        graph.add_edge("executor", "replanner")
        # 2. 只有 replanner 决定继续执行或进入报告。
        graph.add_conditional_edges(
            "replanner",
            self._route_after_replanner,
            {"executor": "executor", "report": "report"},
        )
        graph.add_edge("report", END)
        return graph.compile()
📷 [图片 token=GURJbmboEohr5nxHrT0clzG9n8e(未能下载,见飞书原文)]
这段源码证明诊断并非普通聊天上附加几段 prompt,而是有明确阶段和循环出口的状态图。它只证明控制流,不证明某次诊断证据充分;工具失败、无 SOP 或证据不足仍要由节点状态、审计和最终报告如实表达。
📷 [图片 token=LD6Ubj9aPoCWiix0Mocchfhinig(未能下载,见飞书原文)]
看什么:对比两条运行路径时,关注“谁决定调用工具”和“终态保存在哪里”。
📷 [图片 token=BZWPbpm1ioJuGExkmsIcAlYVnei(未能下载,见飞书原文)]
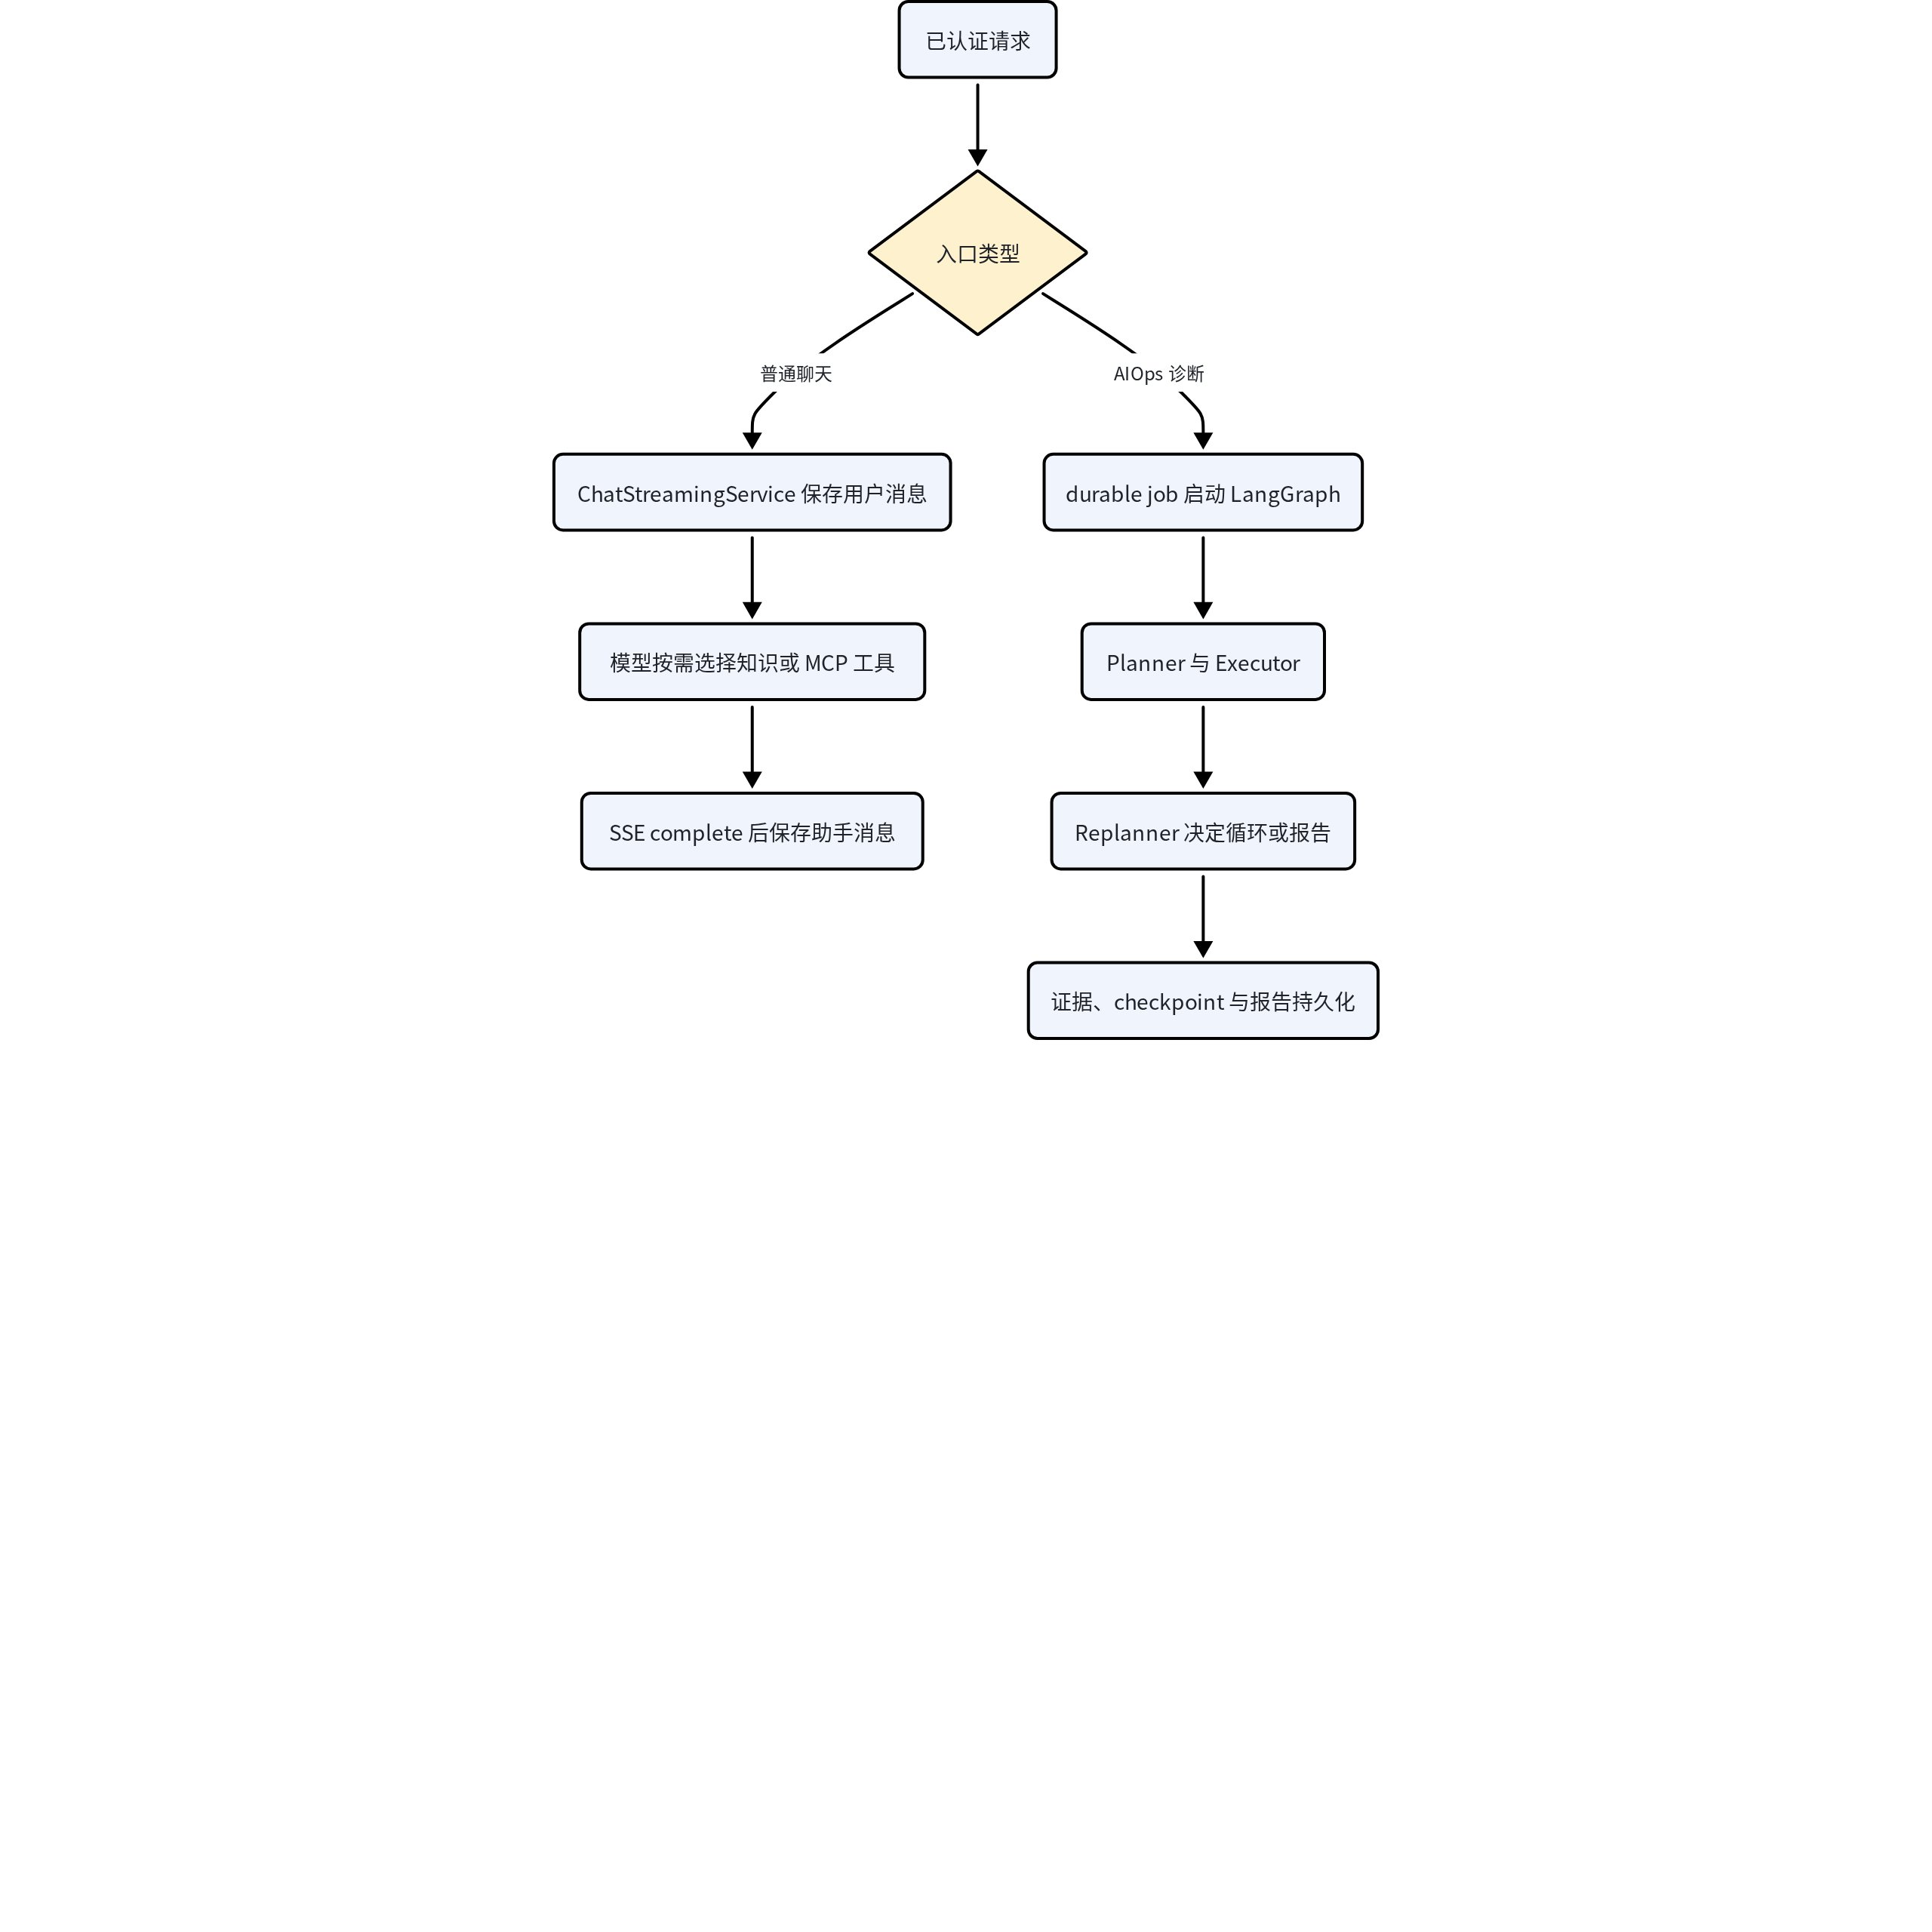
普通聊天的工具选择是 Agent 决策,诊断的阶段转移是图定义;两者都受当前 owner、真实工具和结构化错误约束。连接中断时,聊天通过持久会话协调结果,诊断则还可依赖 durable job 与持久事件继续运行。
📷 [图片 token=LxJ0buCBXoaWosxyRE0c1h6CnCh(未能下载,见飞书原文)]
按纵向切片理解仓库
📷 [图片 token=VWZYbBz84oSP2YxwPogcEyyUnHN(未能下载,见飞书原文)]
仓库目录不是孤立的技术分层,而是多条纵向功能切片共用一组基础边界。认证切片从 apps/frontend/src/authClient.ts 到认证路由、AuthService 和 SQLiteAuthRepository;知识切片从 knowledge client 到上传、索引任务、embedding 和 Milvus;聊天切片从 Pinia store 到 SSE client、流式服务、Agent runner 与消息 Repository;诊断切片则连接告警入口、durable job、图执行、证据与报告。每条切片都复用统一错误、request ID、当前用户依赖和共享契约,这正是单体仓库的优势。
📷 [图片 token=SaPWbJXY0ojrzixi5jEc235enic(未能下载,见飞书原文)]
新增能力时,可以用四个问题检查是否形成了完整切片。第一,前端看到的请求、状态和错误是否已有共享 DTO;第二,路由是否只负责认证、参数与服务编排,而没有直接实现复杂业务;第三,持久化是否经过协议边界并带 owner scope;第四,外部模型或工具失败后是否有安全错误、可观测状态和恢复动作。只完成页面或模型调用,通常还不能算一项完整能力。
📷 [图片 token=X1bgbJ4Y4odObHxFHyacVTjXnPc(未能下载,见飞书原文)]
看什么:索引 API 在同一个处理器里先做 owner-scoped 文档检查,再保存业务任务并调用调度器,202 只表示已接受。
📷 [图片 token=AlcmbRN0loEFN3xcgD9cT01Mnch(未能下载,见飞书原文)]
        document = await _memory_repositories(request).documents.get_document(
            owner_user_id=user.id,
            knowledge_base_id=knowledge_base_id,
            document_id=document_id,
        )
        if document is None:
            raise ApiErrorException("AUTH_FORBIDDEN")
        # 1. 先保存 pending 业务任务,HTTP 202 不等于索引完成。
        task = await _memory_repositories(request).document_index_tasks.create_task(
            owner_user_id=user.id,
            task_id=f"index_task_{uuid4().hex}",
            knowledge_base_id=knowledge_base_id,
            document_id=document_id,
            status="pending",
        )
        # 2. 持久化后再把 task id 交给 durable scheduler。
        await _schedule_index_task(request, owner_user_id=user.id, task_id=task.id)
        return success_response(
            request,
            {"task": _document_index_task_payload(task), "scheduled": True},
            status_code=202,
        )
📷 [图片 token=RV0ZbgeNrozK0Bxb9RKcSDRZnIh(未能下载,见飞书原文)]
代码把切片的关键门槛放在路由层:身份来自依赖,文档与任务都带同一个 owner,外部索引不占用请求。若文档不属于当前用户,调度发生前即返回 403;若调度失败,不能把已创建的业务记录谎称为已索引,后续必须从任务与后台 job 状态继续观察。
📷 [图片 token=Hv2BbfCx6owuqlxDItNcGKQtnXw(未能下载,见飞书原文)]
看什么:从浏览器动作到最终向量写入逐层核对 owner、DTO、状态和失败回传,不要跳过共享契约或 Repository。
📷 [图片 token=KZXxbjuZEojdevxyUs7c8G5rntc(未能下载,见飞书原文)]
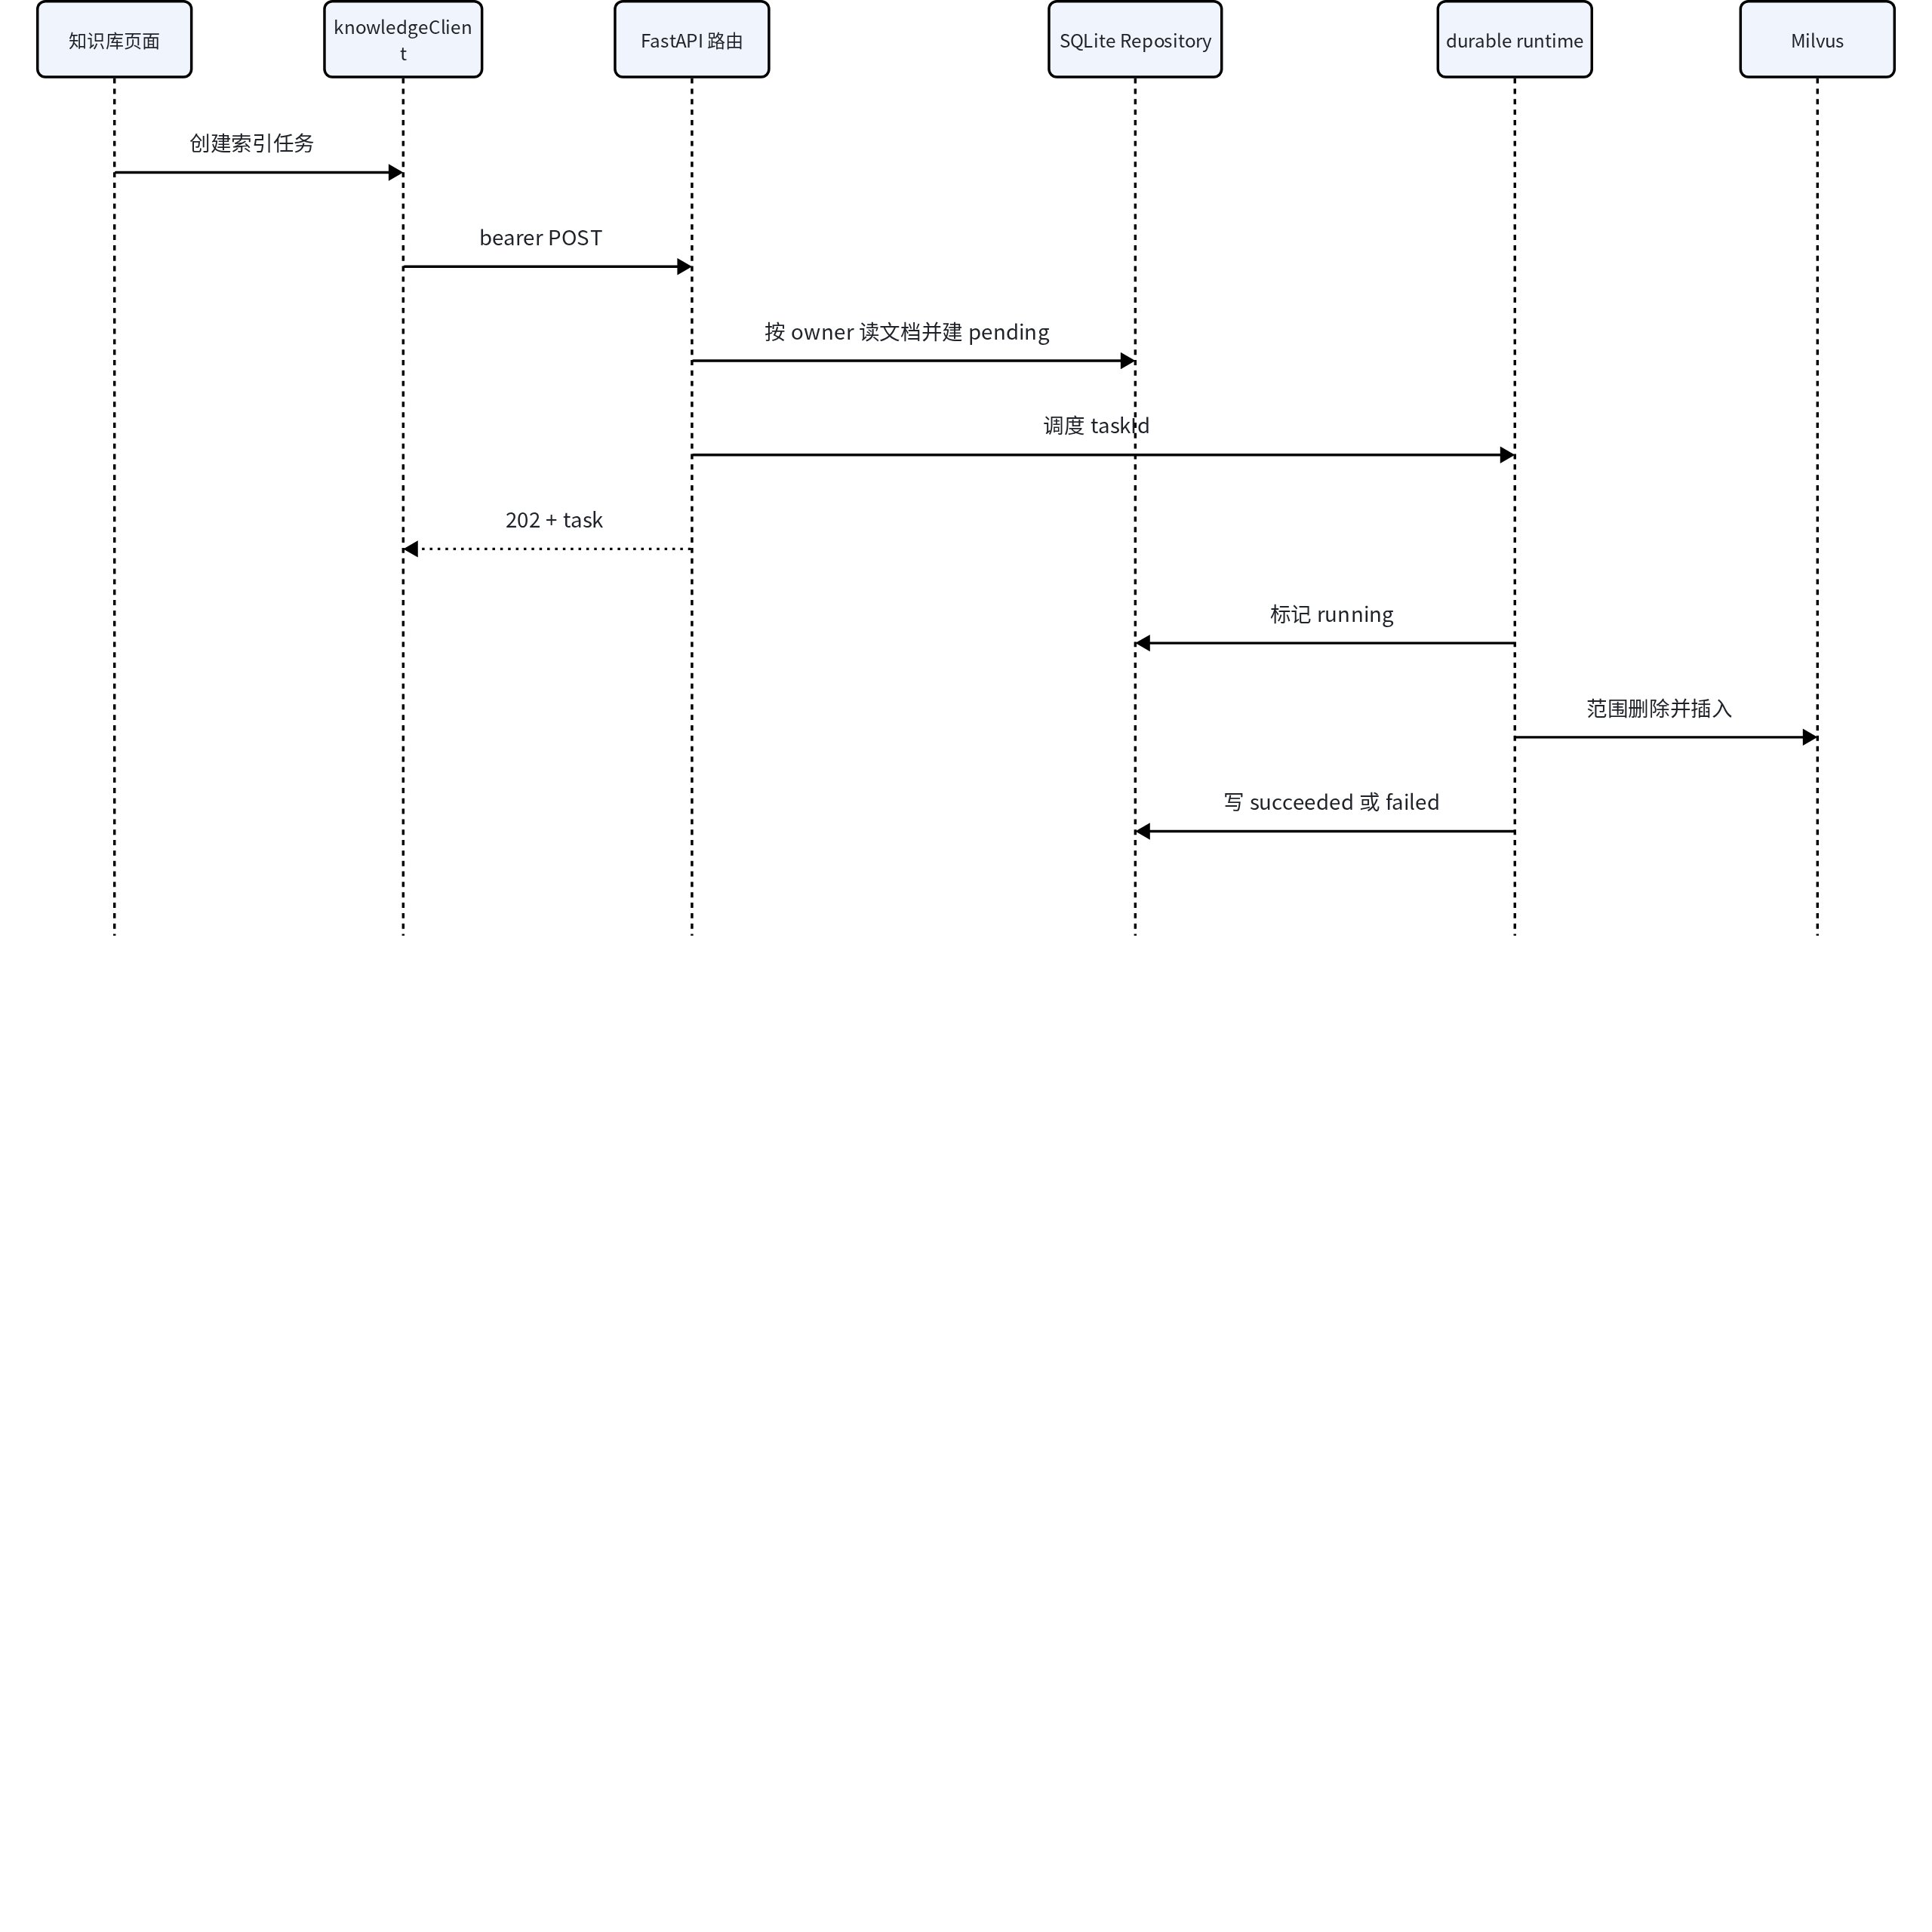
时序图显示 HTTP 返回与后台终态明确分离。页面需要轮询或订阅持久状态;直接把 202 当成功会隐藏 embedding、Milvus 或 worker 的失败,也会让用户在向量尚未就绪时误判检索结果。
📷 [图片 token=F7PFbtIBwoE3VyxjTPbcPabYnhc(未能下载,见飞书原文)]
控制面与运行面的相互约束
📷 [图片 token=Dg99bRlnnowViFxEZZRcSC6xnSd(未能下载,见飞书原文)]
openspec/specs 和共享契约可以视为工程控制面:它们规定哪些行为必须持续成立。FastAPI、Vue、SQLite、Milvus 和外部工具组成运行面:它们在请求与任务中产生真实状态。规格不能代替代码执行,运行结果也不能反向修改契约含义。变更时先更新可观察行为的规范与协议,再实现并用测试锁定,是避免 Agent 系统在快速迭代中失去边界的基本方法。
📷 [图片 token=IrDGbOwLPou2qbxTP4ncORTQnef(未能下载,见飞书原文)]
配置也是控制面的一部分。它选择 provider、模型、向量维度、外部 endpoint 与超时,但不表示依赖已经健康。readiness 把静态配置与动态可达性分别检查,业务任务再记录一次具体执行成功或失败。因此“配置有效”“依赖就绪”“一次索引成功”“一次诊断有充分证据”是四个不同结论,不能互相替代。
📷 [图片 token=LLyVbnC4GohdqxxgdxgcD3EGn8b(未能下载,见飞书原文)]
看什么:把一次变更从规范到运行结果画成闭环,特别关注机器契约和测试在中间承担的防漂移作用。
📷 [图片 token=ATzBbGnAOoBzS6xOfHDc8jBonbb(未能下载,见飞书原文)]
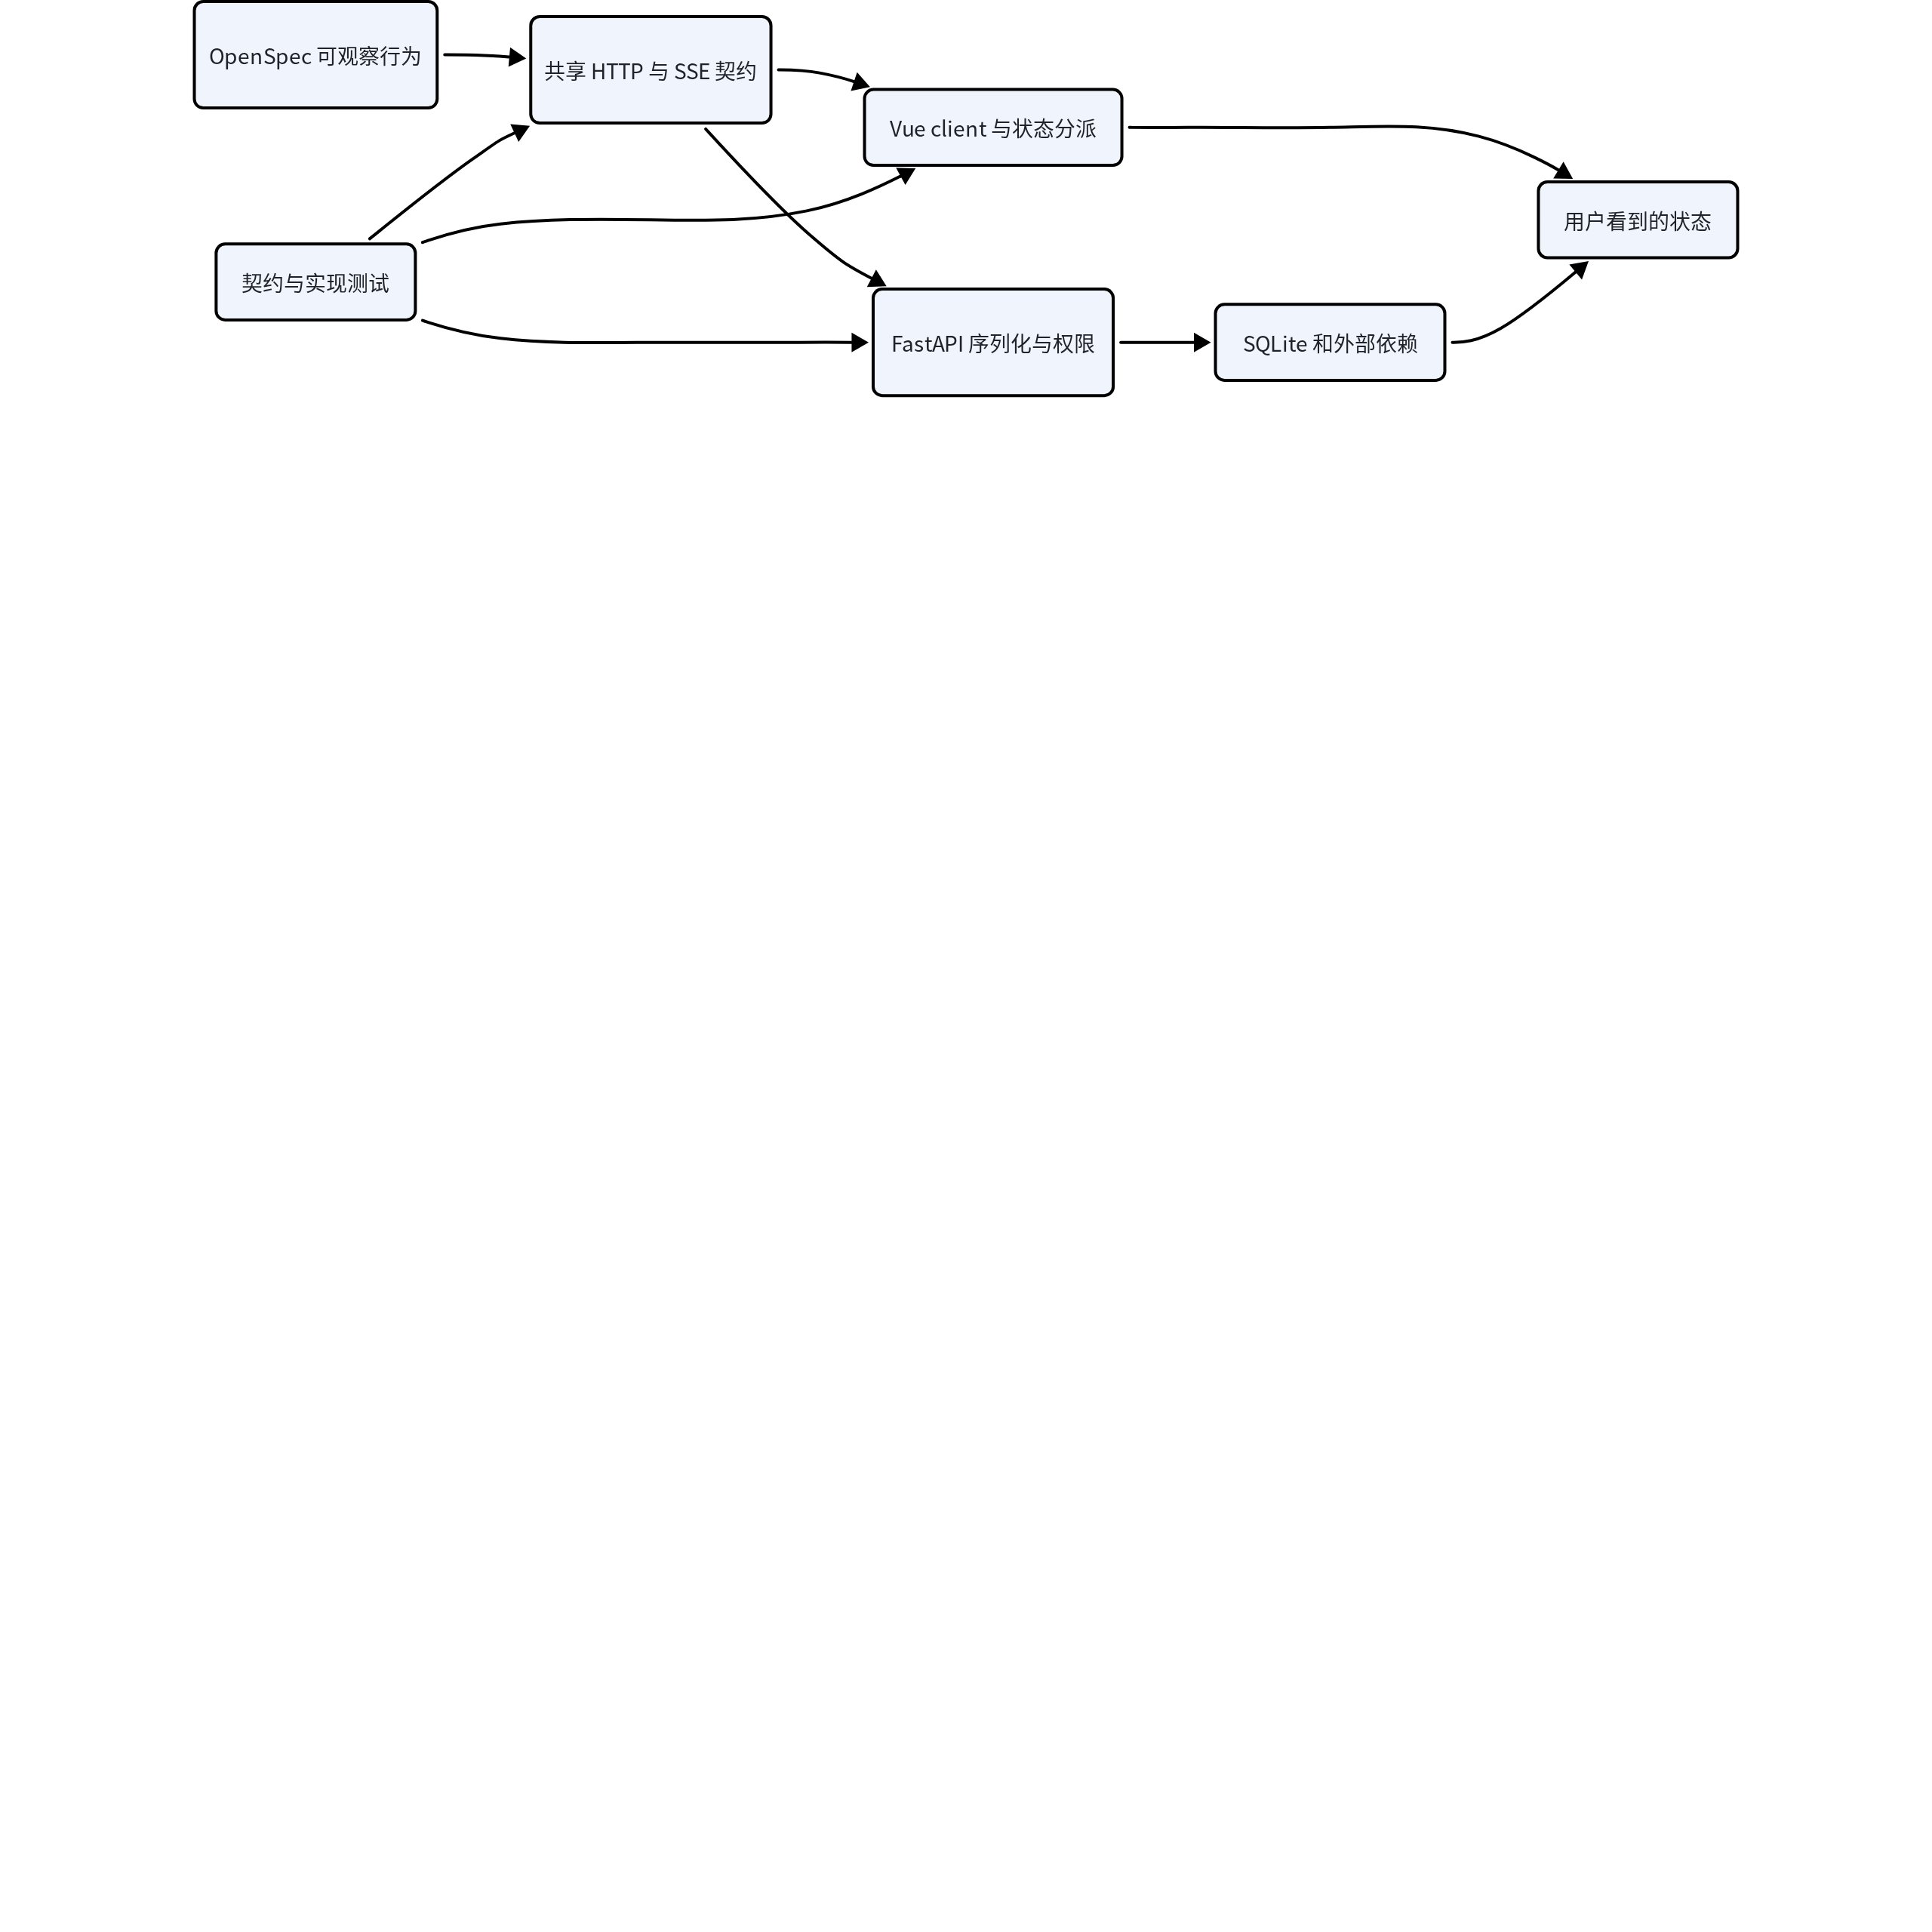
这张图证明不了运行依赖已经健康,但能说明每层应提供什么证据:规格定义期望、共享包定义形状、实现产生状态、测试防止漂移。任何一层变更若跳过相邻边界,都可能出现“类型通过但 Python payload 漂移”或“路由可用但 OpenAPI 未声明权限”的缺口。
📷 [图片 token=DNL7b68TKo35G1xxN5TcGIKhneb(未能下载,见飞书原文)]
数据、契约与状态
📷 [图片 token=TlXNb08uxovwyxxZfNEcr40kn0f(未能下载,见飞书原文)]
packages/api-contracts/src/responses.ts 把 HTTP 响应分成 ok: true 的数据 envelope 与 ok: false 的结构化错误 envelope,并都携带 request metadata。packages/api-contracts/src/sse.ts 用 type 区分内容增量、推理增量、工具调用、引用、任务状态、报告、完成与错误。后端 Python 没有直接导入 TypeScript,但 apps/backend/src/super_ai/api/responses.py、apps/backend/src/super_ai/error_catalog.py 和事件序列化必须与共享形状对齐,双方测试负责防漂移。
📷 [图片 token=C4XSbetRyouUkHxa4GFcS7annCh(未能下载,见飞书原文)]
状态也按领域区分。HTTP health 是轻量 liveness;/ready 并行探测 SQLite、Milvus、LLM 与 MCP,可能以 503 返回一个仍为成功 envelope 的降级诊断数据;/config/check 同时检查配置可解析性与依赖可用性。业务任务则有自己的状态机,例如文档索引的 pending、running、succeeded、failed,后台任务还包含 queued、租约、取消与重试信息。不要用单一“服务正常”替代这些不同层次的状态。
📷 [图片 token=JD5cbFrsyoG0JpxedbhcXZXZnsh(未能下载,见飞书原文)]
权限、安全与失败边界
📷 [图片 token=IDU5bCaRjobChdxtYonckFxunre(未能下载,见飞书原文)]
当前 user ID 就是 tenant scope,尚未引入独立组织 tenant。每个受保护路由通过 _current_user 获得 UserRecord,随后把 user.id 作为 owner_user_id 传给 Repository。跨 tenant 的资源 ID 通常表现为 owner-scoped 查询无结果,路由再映射为 AUTH_FORBIDDEN。Milvus 查询还必须同时带 tenant ID 与允许的知识库 ID;允许集合为空时直接返回空列表,不发送无范围 search 或 query。
📷 [图片 token=RNC3b9hmtoPgpfx7LtKcjBbgnZe(未能下载,见飞书原文)]
配置只从本地 config/project.json 与 config/user.project.json 递归合并,后者覆盖同路径字段。运行时不从环境变量补项目配置。模型 API key、CLS 凭据和真实资源 ID 不应进入版本控制、HTTP 响应或日志。/ready 与 /config/check 只暴露 provider、模型、基础 URL、collection 名、endpoint、延迟或工具数等必要上下文,失败时使用组件级安全消息。
📷 [图片 token=Ho5cbljwSoEeg6xfIrOcWfgonjh(未能下载,见飞书原文)]
外部失败不等于“没有问题”。Qwen 失败会让模型或嵌入流程失败,Milvus 失败会阻断索引和检索,MCP 失败会阻断真实工具调用,Alertmanager 不可用会阻断告警读取。调用层必须保留失败状态并提供恢复路径;AIOps 结论尤其不能在证据不足时生成确定根因。启动脚本会安装依赖、迁移数据库并启动服务,因此它是有副作用的运行入口,不应被当成静态验证命令。
📷 [图片 token=KlEObLn9VoJCNrxg48fcbU2pnwc(未能下载,见飞书原文)]
阅读顺序与小结
📷 [图片 token=KVxTbKxycoNsagxDoMKcQrAzn2e(未能下载,见飞书原文)]
先读
README.md与openspec/specs/project-foundation/spec.md,建立产品能力和仓库边界。再读
packages/api-contracts/src/index.ts、packages/api-contracts/src/responses.ts、packages/api-contracts/src/sse.ts与packages/api-contracts/src/openapi.ts,明确跨层协议。从
apps/frontend/src/router/index.ts进入一个页面 client,再追到create_app对应路由。沿路由继续到服务、
apps/backend/src/super_ai/memory/repositories.py、SQLite 实现及外部 provider。最后沿本文流程图回到 OpenSpec 主规格与真实实现,核对权限、失败和状态边界。
OncallAgent 的架构核心可以概括为:浏览器负责交互,FastAPI 负责边界与编排,服务和 Agent 负责受约束的智能行为,SQLite 保存可恢复的业务事实,Milvus只保存带权限范围的知识 chunk 向量,Qwen 与 MCP 是可失败的外部能力,共享契约和测试负责让这些层长期对齐。阅读源码时始终追问“身份从哪里来、事实保存在哪里、事件遵循什么契约、失败会留下什么状态”,就能比从页面或模型调用开始获得更稳定的全景。
📷 [图片 token=HewQbjTEToNo6cxNfIyc2ceinGe(未能下载,见飞书原文)]